توفر المعايير طريقة موضوعية لتقييم أنظمة الذكاء الاصطناعي، لكنها ليست الغاية النهائية. فقيمة الحصول على درجة عالية في المعيار لا تتحقق إلا إذا انعكس ذلك على أداء موثوق في التطبيقات العملية.
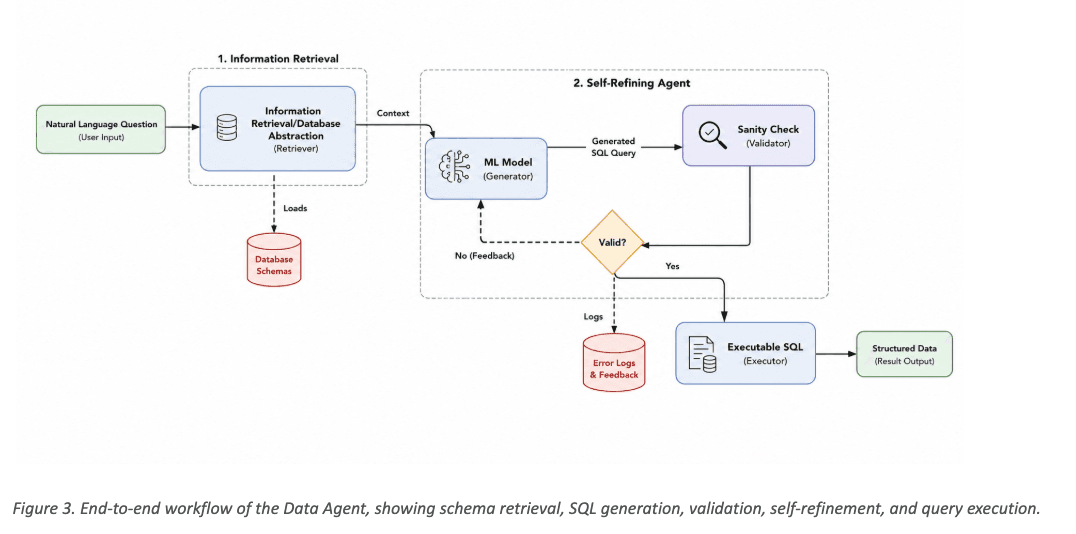
خلال هذه الدراسة، وجدنا أن بناء نظام تحويل النصوص إلى SQL جاهز للإنتاج يتجاوز بكثير مجرد توليد استعلامات SQL. فقد تبين أن فهم مخططات قواعد البيانات، واسترجاع السياق الصحيح، والتحقق من صحة الاستعلامات المولدة، وتحسين المخرجات غير الصحيحة، لا يقل أهمية عن نموذج اللغة نفسه.
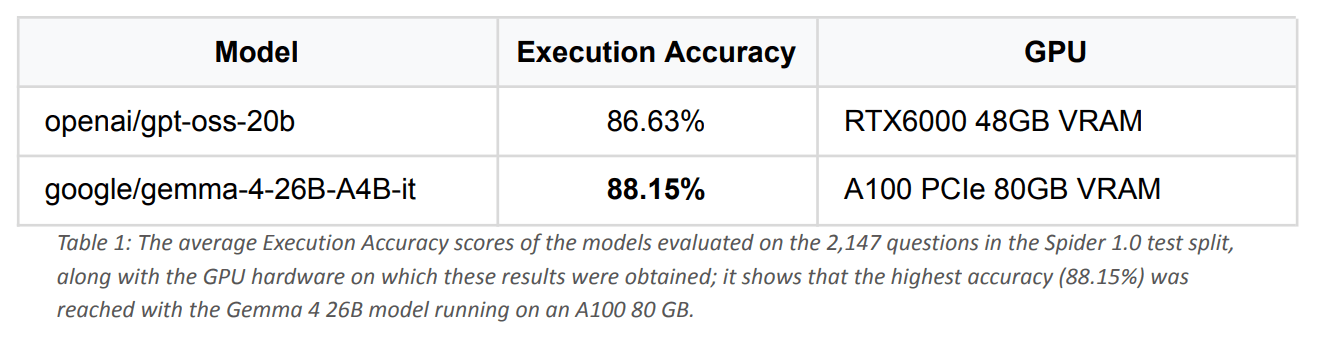
تُبرهن دقة التنفيذ التي حققناها بنسبة 88.15% على منصة Spider 1.0 أن النماذج مفتوحة المصدر، إلى جانب بنية مصممة جيدًا، قادرة على تقديم أداء تنافسي للغاية لمهام تحويل النصوص إلى SQL في المؤسسات. والأهم من ذلك، أنها تُؤكد صحة مبادئ التصميم التي يقوم عليها وكيل البيانات الخاص بنا ، والذي صُمم ليعمل بكفاءة عالية على قواعد بيانات المؤسسات المعقدة، وليس فقط على مجموعات البيانات المعيارية.
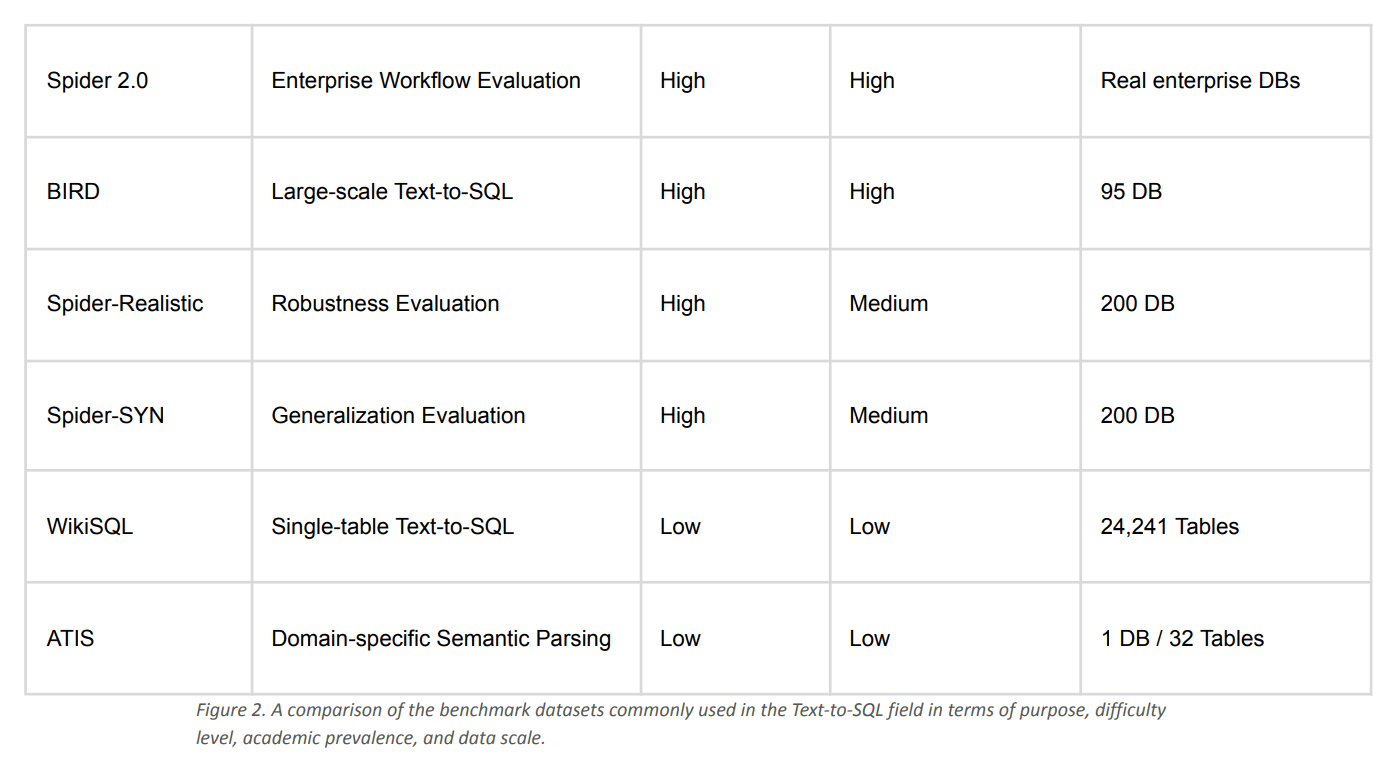
يمثل Spider 1.0 علامة فارقة مهمة، ولكنه ليس سوى بداية رحلتنا. تشمل خطواتنا التالية تقييم وكيل البيانات على Spider 2.0 ، وإجراء اختبارات معيارية أوسع نطاقًا على مستوى المؤسسات، والأهم من ذلك، بيئات عملاء حقيقية حيث تكون مخططات قواعد البيانات أكبر بكثير وتكون أسئلة الأعمال أكثر تعقيدًا.
إن رؤيتنا طويلة المدى لا تقتصر على بناء مولد SQL أفضل فحسب، بل نهدف إلى بناء وكلاء بيانات أذكياء يمكّنون المؤسسات من التفاعل مع بياناتها المؤسسية بسلاسة كما لو كانت تتواصل مع زميل لها، وذلك من خلال دمج الاسترجاع والاستدلال والتحقق والذكاء الاصطناعي القابل للتفسير في منصة موثوقة لدعم اتخاذ القرارات.