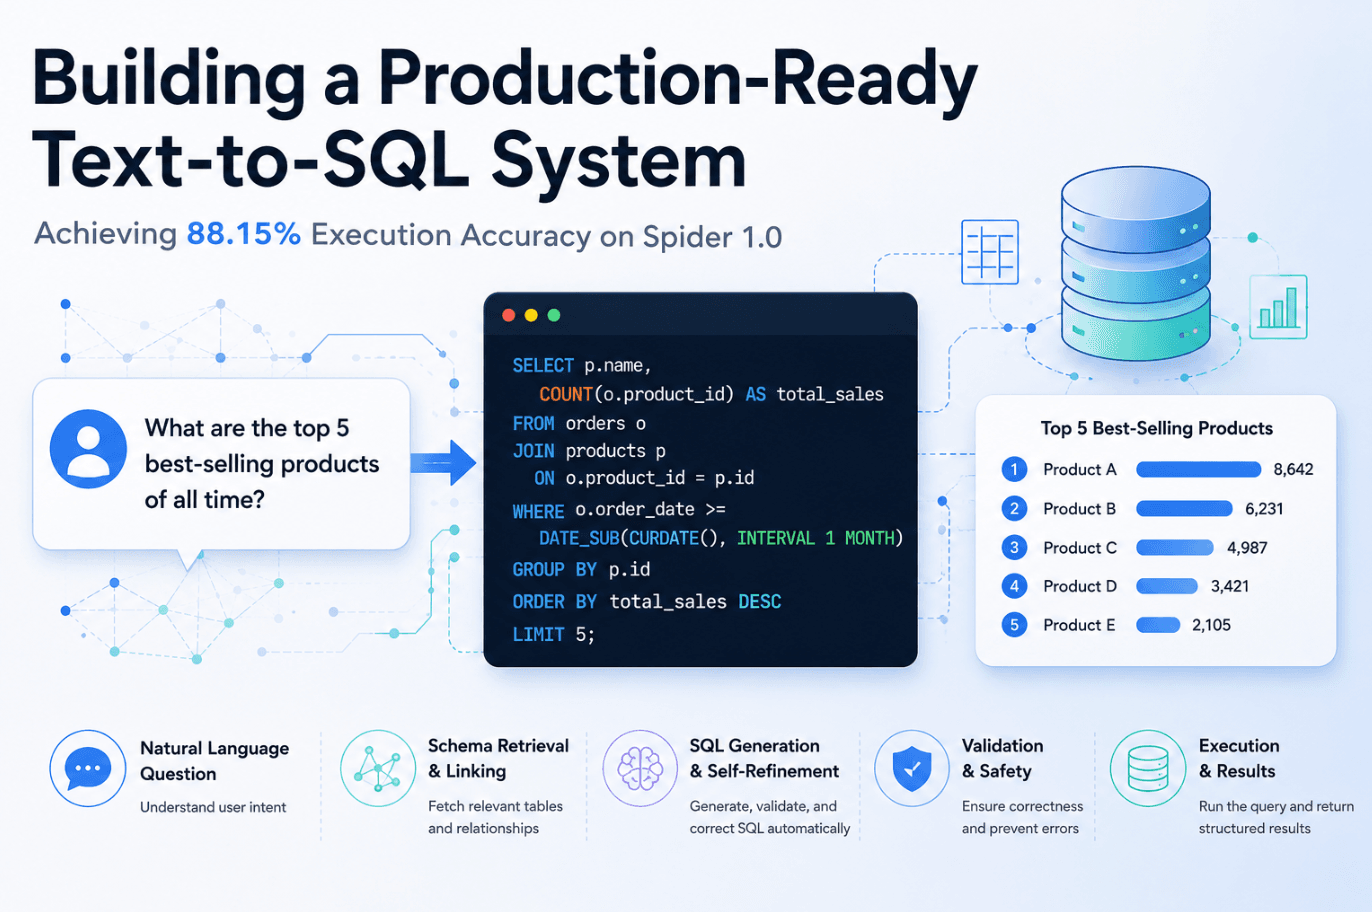
Изграждане на готова за производство система за преобразуване на текст в SQL: Постигане на 88.15% на Spider 1.0
Дата на публикуване
Юли 13, 2026
Сподели
Резюме
Изграждането на готова за производство система за преобразуване на текст в SQL изисква много повече от генериране на SQL с голям езиков модел. Корпоративните приложения изискват точно разбиране на схемата, извличане на контекст, валидиране и коригиране на грешки, за да се получат надеждни резултати върху невиждани досега бази данни.
В това проучване ние сравняваме нашия Data Agent със Spider 1.0 и постигаме 88.15% точност на изпълнение, използвайки модела Gemma 4 26B . Вместо да се фокусира единствено върху резултатите от бенчмарковете, тази статия споделя архитектурните решения, инженерните уроци и прозренията от бенчмаркинга, които стоят зад тези резултати.
Отвъд генерирането на SQL
Моделите с големи езици значително подобриха генерирането на SQL код, но изграждането на готова за работа система за преобразуване на текст в SQL изисква много повече от превеждане на естествен език в SQL. Корпоративните приложения трябва да разбират сложни схеми на бази данни, да извличат правилния контекст, да валидират генерирани заявки и да генерират надеждни резултати в бази данни, които никога преди не са виждали.
За да оценим тези възможности, тествахме нашия Data Agent на Spider 1.0, най-широко използваният бенчмарк за Text-to-SQL. Използвайки модела Gemma 4 26B , нашата система постигна 88.15% точност на изпълнение , демонстрирайки, че архитектурата и управлението на контекста са също толкова важни, колкото и изборът на модел.
Защо Спайдър 1.0?
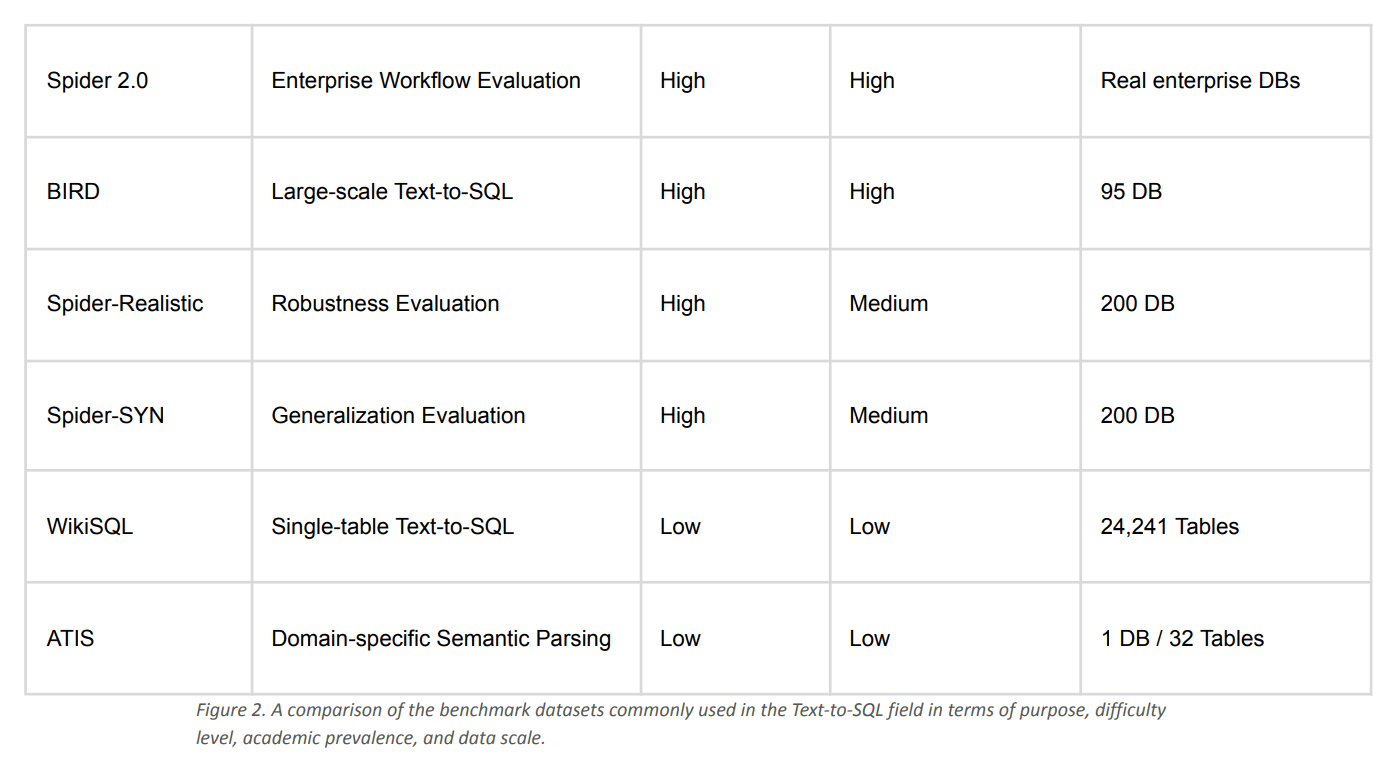
Изборът на правилния бенчмарк е също толкова важен, колкото и изборът на правилния модел. Докато по-нови набори от данни като Spider 2.0 и BIRD въвеждат по-сложни корпоративни сценарии, Spider 1.0 остава най-широко възприетият бенчмарк за оценка на Text-to-SQL системи и сравняване на резултатите в цялата литература.
За първоначалната ни оценка избрахме Spider 1.0, защото той предоставя стандартизирана и добре установена базова линия. Той ни позволява да измерим колко ефективно нашият Data Agent разбира невиждани досега схеми на бази данни и генерира правилен SQL код при реални условия.
Фигура 2 обобщава как Spider 1.0 се сравнява с други често използвани бенчмаркове за Text-to-SQL.
Изграждане на агента за данни
Постигането на висока точност при преобразуване на текст в SQL не е просто въпрос на използване на по-голям езиков модел. По време на нашия процес на сравнителен анализ установихме, че архитектурата и управлението на контекста имат по-голямо влияние върху производителността, отколкото самият избор на модел.
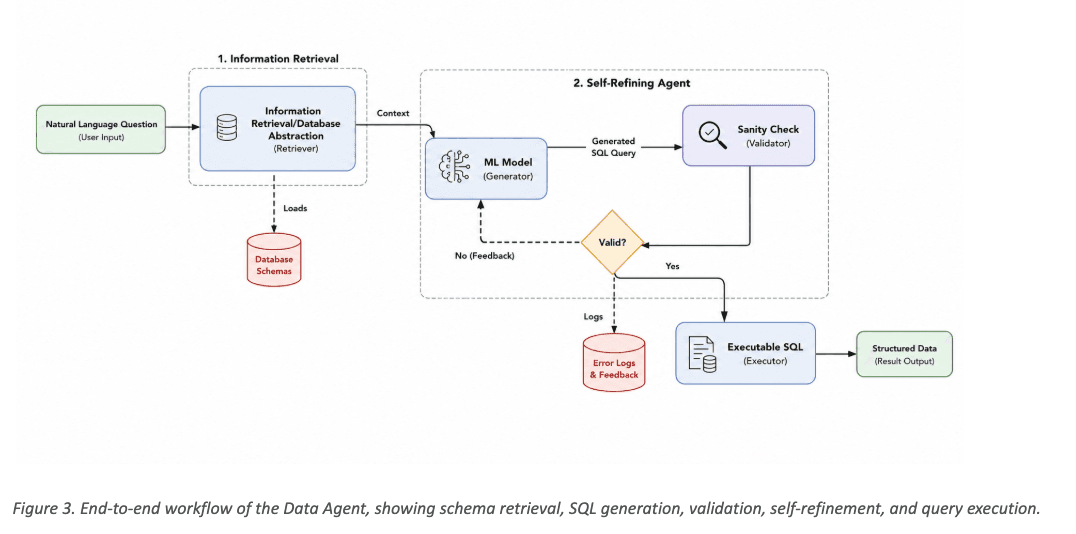
Нашият Data Agent е проектиран като многоетапен конвейер, който постепенно стеснява проблема, преди да поиска от LLM да генерира SQL. Вместо да излага цялата схема на базата данни на модела, системата първо извлича само съответната схема и контекстуална информация, след което генерира SQL заявка, валидира резултата и автоматично коригира често срещани грешки преди изпълнение.
Както е илюстрирано на Фигура 3 , архитектурата се състои от три основни етапа:
Извличане на информация – Въпросът на потребителя се анализира, за да се идентифицират съответните обекти в базата данни, и от хранилището на метаданни се извлича само необходимата информация за схемата.
Саморафиниращ агент – Езиковият модел генерира SQL, валидира заявката спрямо извлечената схема и автоматично я прецизира, когато валидацията е неуспешна.
Изпълнение и отговор – След валидиране, SQL заявката се изпълнява спрямо целевата база данни и резултатите се връщат като структурирани данни или отговор на естествен език.
Тази ориентирана към производството архитектура е вдъхновена от идеите, въведени в DIN-SQL и DAIL-SQL , като същевременно е адаптирана за корпоративни среди, където надеждността, обяснимостта и устойчивостта са също толкова важни, колкото и точността на бенчмарка.
Нашето пътешествие в бенчмаркинга
Изборът на правилния езиков модел беше важна част от нашия процес на сравнителен анализ. Вместо да оценяваме само един модел, експериментирахме с широк набор от LLM с отворен код, включително Llama 3.1, Qwen 2.5, DeepSeek, SQLCoder, CodeGemma, Mistral, GPT-OSS и Gemma 4.
За да осигурим справедливо сравнение, оценихме всеки модел, използвайки Execution Accuracy (EA) , стандартната метрика за бенчмаркинг на Text-to-SQL. За разлика от метриките, базирани на синтаксис, Execution Accuracy измерва дали генерираният SQL връща същия резултат като референтната заявка, което я прави по-добър индикатор за реална производителност.
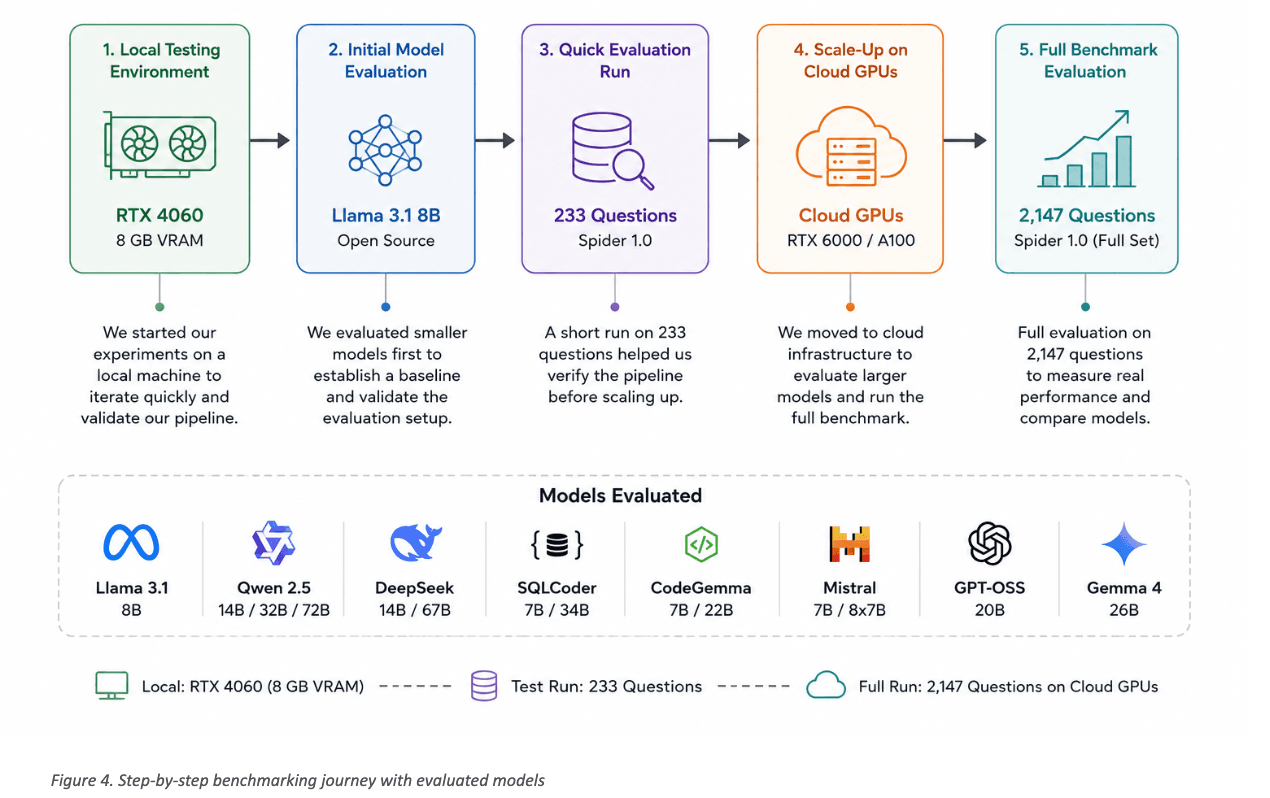
Нашият път на бенчмаркинг е илюстриран на Фигура 4. Започнахме с експерименти на локална работна станция, оборудвана с RTX 4060 (8 GB VRAM) , където по-малките модели ни позволиха бързо да итерираме и да валидираме нашия процес. След като установихме стабилна базова линия, използвайки подмножество от 233 въпроса от Spider 1.0, преминахме към облачни графични процесори, за да оценим по-големи модели върху пълния бенчмарк от 2,147 въпроса . Този поетапен подход ни позволи да оптимизираме ефективно архитектурата, преди да инвестираме в мащабни бенчмаркове.
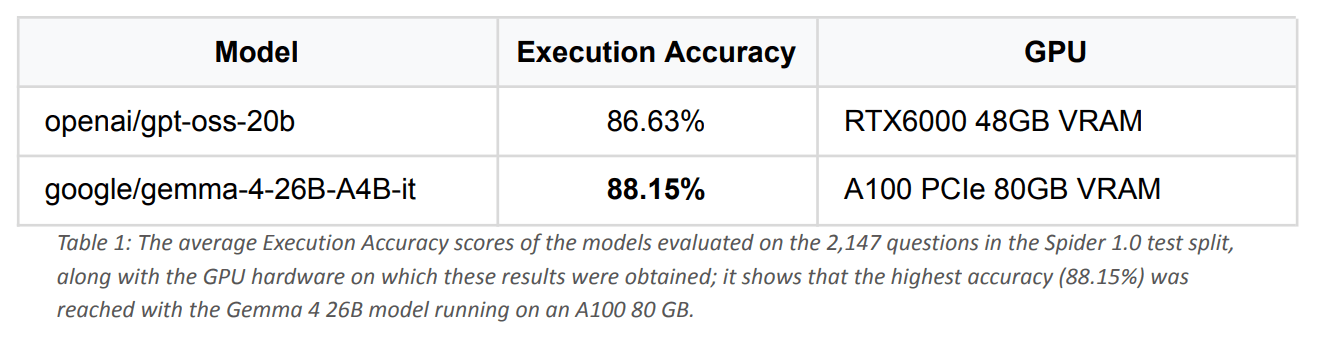
Оценихме крайните модели на пълния тестов разпределител Spider 1.0, съдържащ 2,147 въпроса. Както е показано в Таблица 1, Gemma 4 26B постигна най-висок резултат (88.15%), следван от GPT-OSS 20B (86.63%). Тези резултати показват, че съвременните LLM с отворен код, когато са комбинирани с ефективен канал за извличане и валидиране, могат да постигнат високо конкурентна производителност при Text-to-SQL.
Как се сравняват тези резултати?
Резултатите от бенчмарковете са значими само когато могат да бъдат сравнени с публикувани по-рано трудове. За да разберем по-добре значението на нашите резултати, прегледахме както скорошни проучвания за преобразуване на текст в SQL, така и широко цитирани статии за бенчмарк.
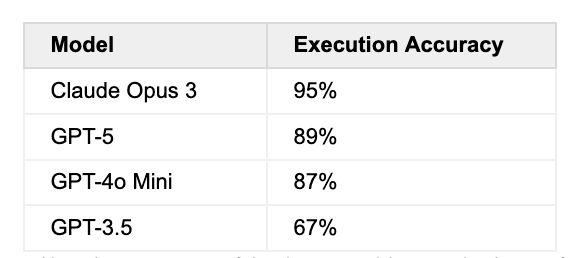
Таблица 2: Процентите на точност на моделите със затворен код, докладвани в проучването SQL-of-Thought върху подмножество от набора от данни Spider; тя показва, в сравнително отношение, че резултатът от 88.15%, получен в тази работа, е позициониран над GPT-4o Mini (87%) и на ниво, близко до GPT-5 (89%).
Скорошни изследвания, като например SQL-of-Thought [1], показват, че водещи модели със затворен код, включително Claude Opus 3, GPT-5 и GPT-4o Mini , постигат висока точност върху подмножествата на бенчмарковете на Spider. Въпреки че директните сравнения трябва да се тълкуват внимателно поради разликите в настройките за оценка, подканите и подмножествата на бенчмарковете, нашата точност на изпълнение от 88.15% показва, че моделите с отворен код могат да постигнат производителност в рамките на същия конкурентен диапазон.
Въпреки че тези резултати идват от различни условия за оценка и не трябва да се сравняват директно, те предоставят полезен контекст за разбиране на текущия пейзаж на производителността на системите за преобразуване на текст в SQL. Нашият бенчмарк показва, че моделите с отворен код вече могат да се конкурират с водещите алтернативи със затворен код, когато са комбинирани с добре проектирана архитектура.
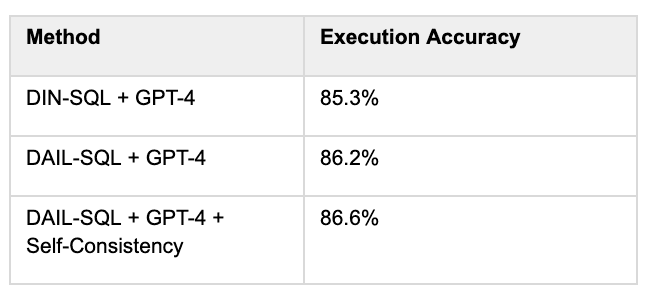
Също така сравнихме нашите резултати с ориентирани към продукцията рамки за преобразуване на текст в SQL, като DIN-SQL [3] и DAIL-SQ L, които комбинират големи езикови модели с техники, включително свързване на схеми, проектиране на промпти, самосъгласуваност и коригиране на грешки.
Таблица 3: Резултатите за точността на изпълнение на различни методи върху Spider 1.0 в проучването „Text-to-SQL, подкрепен от модели на големи езици: сравнителна оценка“ [2]; тя разкрива влиянието върху точността не само на избора на модел, но и на техники като бързо инженерство, свързване на схеми и самосъгласуваност.
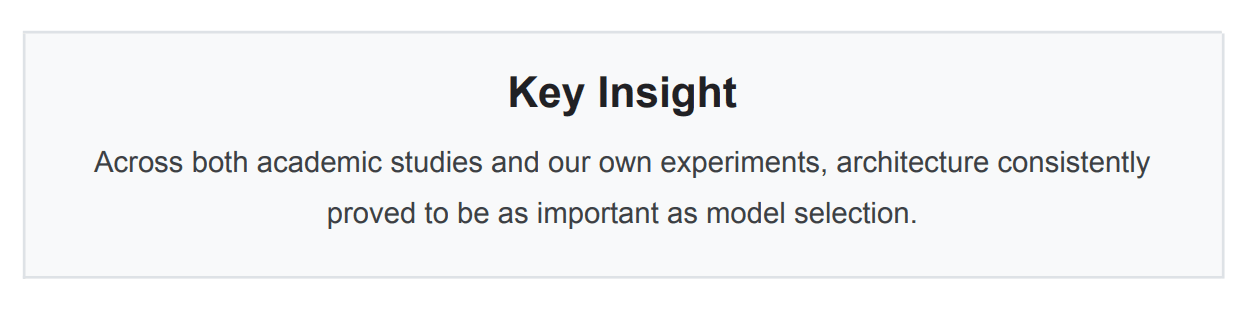
Нашите открития потвърждават заключението, споделяно в скорошната литература: високата производителност на Text-to-SQL зависи не само от езиковия модел, но и от заобикалящата го архитектура. Ефективното извличане на схема, управлението на контекста, валидирането и самокорекцията често са толкова важни, колкото и самият модел.
Какво научихме
Бенчмаркингът не е само измерване на точността, а и разбиране къде и защо една система се проваля. По време на нашата оценка анализирахме неправилни прогнози и идентифицирахме няколко повтарящи се модела, които повлияха на крайните резултати.
Някои грешки произлизат от самия бенчмарк. В малък брой случаи, несъответствия в референтните (златни) SQL заявки са довели до маркиране на логически правилните прогнози като неправилни. Други случаи са включвали двусмислени въпроси на естествен език или сценарии за разбиване на равенство, при които множество SQL заявки биха могли легитимно да дадат еднакво валидни отговори.
Наблюдавахме също така няколко специфични за модела поведения, включително ненужни преобразувания на типове, непоследователно обработване на чувствителността към главни и малки букви и понякога прекомерно усложняване на иначе прости SQL заявки. Тези открития подсилиха важността на включването на механизми за валидиране и самокорекция в конвейера на Data Agent.
Като цяло, нашият анализ показа, че много от останалите грешки не са причинени от ограниченията на самия езиков модел, а от неясноти в бенчмарка или гранични случаи при генериране на SQL. Това предполага, че по-нататъшни подобрения в извличането, валидирането и управлението на контекста биха могли да тласнат системата отвъд прага на точност на изпълнение от 90%.
Цена и ефективност
Високата точност е само един аспект на готовата за производство система за преобразуване на текст в SQL. В корпоративни среди разходите за инфраструктура, поверителността на данните и гъвкавостта на внедряването са също толкова важни съображения.
Едно от ключовите предимства на нашия подход е, че той разчита изцяло на езикови модели с отворен код. По време на процеса на разработка успяхме да извършим повечето експерименти локално, използвайки потребителска RTX 4060 (8 GB VRAM) , което ни позволи да итерираме бързо, без да правим разходи за API или токени. По-големи бенчмарк тестове бяха изпълнени на специални облачни графични процесори, едва след като архитектурата беше валидирана.
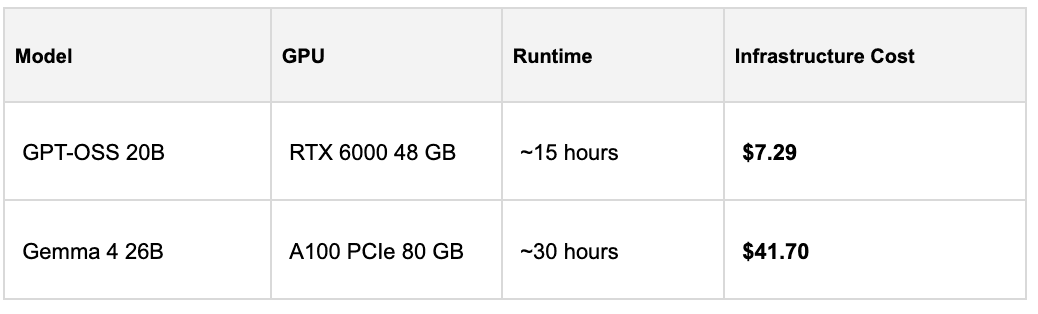
За пълната оценка на Spider 1.0 използвахме RunPod Secure Cloud. Бенчмаркът Gemma 4 26B беше изпълнен на A100 PCIe 80 GB GPU, докато GPT-OSS 20B работеше на RTX 6000 48 GB GPU.
Разходите за инфраструктура са обобщени в Таблица 4.
Въпреки че най-големите бенчмарк тестове изискваха облачна инфраструктура, цялостният процес на разработка остана рентабилен благодарение на локалните експерименти и моделите с отворен код. По-важното е, че получената архитектура може да бъде внедрена изцяло в собствената инфраструктура на организацията, елиминирайки зависимостта от външни API, като същевременно осигурява по-голям контрол върху поверителността на данните, съответствието и оперативните разходи.
Това прави архитектурата особено подходяща за организации, работещи в среда, чувствителна към поверителността, регулирана или изолирана среда, където сигурността на данните и гъвкавостта при внедряване са критични изисквания.
Отвъд паяка 1.0
Бенчмарковете предоставят обективен начин за оценка на системи с изкуствен интелект, но не са крайната цел. Високият резултат от бенчмарка е ценен само ако се превръща в надеждна производителност в реални приложения.
В хода на това проучване установихме, че изграждането на готова за работа система за преобразуване на текст в SQL е много повече от генериране на SQL. Разбирането на схемите на базите данни, извличането на правилния контекст, валидирането на генерираните заявки и прецизирането на неправилни резултати се оказаха също толкова важни, колкото и самият езиков модел.
Нашата 88.15% точност на изпълнение на Spider 1.0 демонстрира, че моделите с отворен код, комбинирани с добре проектирана архитектура, могат да осигурят високо конкурентна производителност за корпоративни задачи от типа „Text-to-SQL“. По-важното е, че това валидира принципите на проектиране, залегнали в нашия Data Agent , който е създаден да работи надеждно върху сложни корпоративни бази данни, а не само върху бенчмарк набори от данни.
Spider 1.0 представлява важен етап, но е само началото на нашето пътуване. Следващите ни стъпки включват оценка на Data Agent на Spider 2.0 , по-големи бенчмаркове в корпоративен мащаб и, най-важното, реални клиентски среди, където схемите на базите данни са значително по-големи, а бизнес въпросите са далеч по-сложни.
Нашата дългосрочна визия не е просто да изградим по-добър SQL генератор. Целта ни е да изградим интелигентни агенти за данни, които позволяват на организациите да взаимодействат с корпоративните данни толкова естествено, колкото общуват с колеги – комбинирайки извличане, разсъждение, валидиране и обясним изкуствен интелект в надеждна платформа за подпомагане на вземането на решения.
Основни уроци
Бенчмаркингът не е само за измерване на точността, а за разбиране защо една система е успешна или неуспешна.
По време на нашата оценка идентифицирахме няколко повтарящи се модела на грешки. Някои произлизат от неясноти в самия бенчмарк, включително несъответствия в референтните SQL заявки и неточно дефинирани условия за подреждане. Други отразяват често срещани поведения на LLM, като например ненужно преобразуване на типове или непоследователно боравене с чувствителни към малки и големи букви стойности.
Тези наблюдения подкрепиха едно от основните открития на нашата работа: архитектурата е от значение също толкова, колкото и изборът на модел. Извличането, свързването на схеми, валидирането и самокорекцията допринесоха също толкова за крайното представяне, колкото и основният езиков модел.
Въпреки че ограниченията на бенчмарковете неизбежно влияят на крайния резултат, нашият анализ показва, че по-нататъшни подобрения в управлението на контекста и валидирането биха могли да тласнат системата отвъд 90% точност на изпълнение.
Поглед напред
Spider 1.0 предостави важна основа за оценка на нашия Data Agent, но представлява само първата стъпка към готов за производство корпоративен изкуствен интелект.
Следващият ни фокус е да оценим архитектурата върху по-предизвикателни бенчмаркове като Spider 2.0 и, което е по-важно, върху реални корпоративни бази данни, където схемите са значително по-големи, документацията често е непълна, а бизнес въпросите са далеч по-сложни.
Нашата цел не е просто да изградим поредната система за преобразуване на текст в SQL. Ние изграждаме интелигентни агенти за данни , които комбинират извличане, разсъждение, валидиране и обяснимост, за да помогнат на организациите да взаимодействат с корпоративните данни естествено и надеждно.
Източници
[1] Саумя Чатурведи, Аман Чадха, Лоран Биндшедлер arXiv. „SQL-на-мисълта: Многоагентно преобразуване на текст в SQL с насочена корекция на грешки.“ arXiv. юни 2026 г. https://arxiv.org/abs/2509.00581
[2] Dawei Gao, Haibin Wang, Yaliang Li, Xiuyu Sun, Yichen Qian, Bolin Ding, Jingren Zhou „Текст към SQL, упълномощен от големи езикови модели: сравнителна оценка“ arXiv. юни 2026 г