Benchmarks giver en objektiv måde at evaluere AI-systemer på, men de er ikke det endelige mål. En høj benchmark-score er kun værdifuld, hvis den omsættes til pålidelig ydeevne i virkelige applikationer.
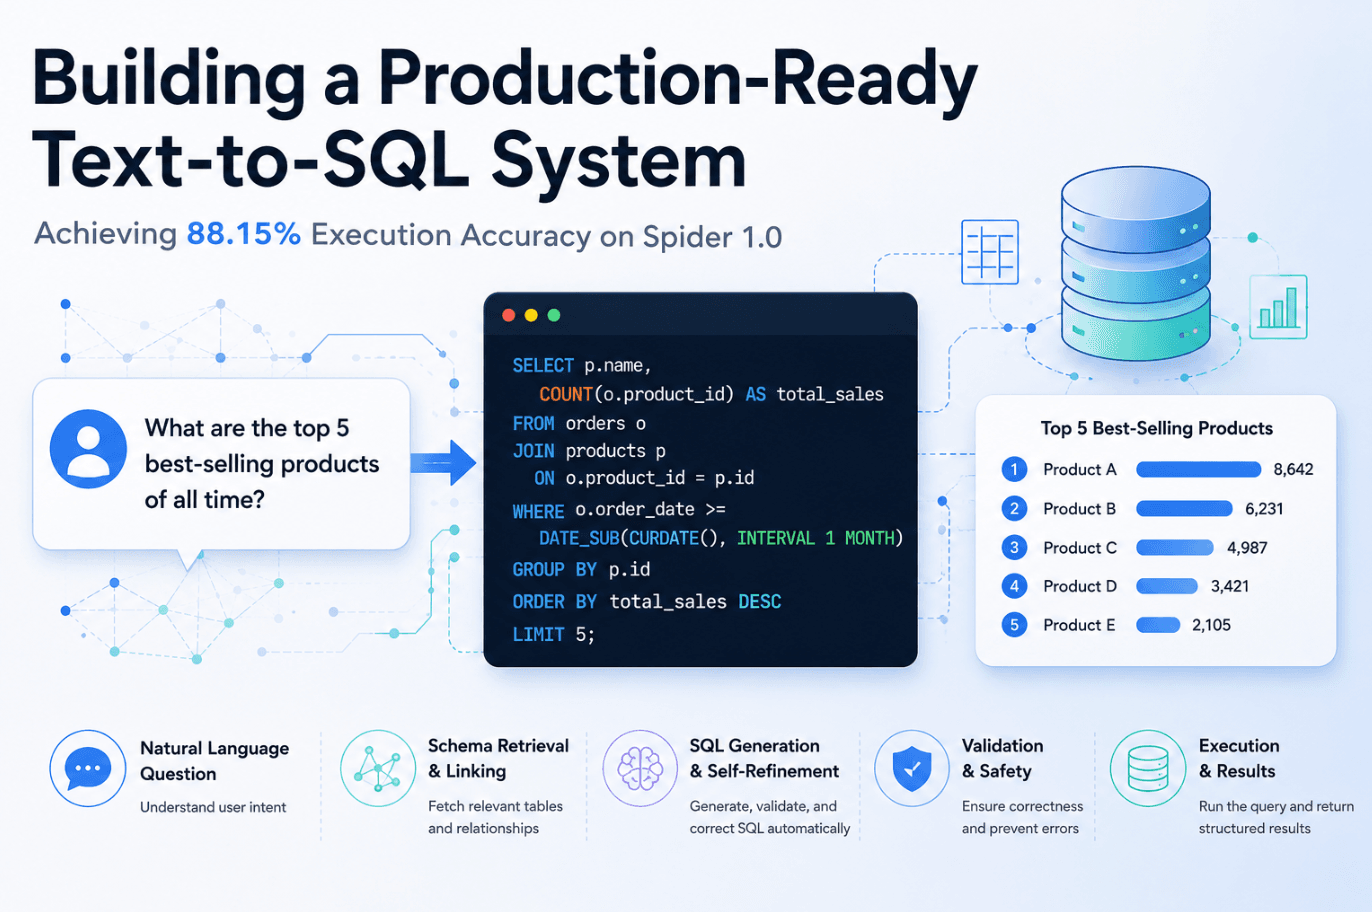
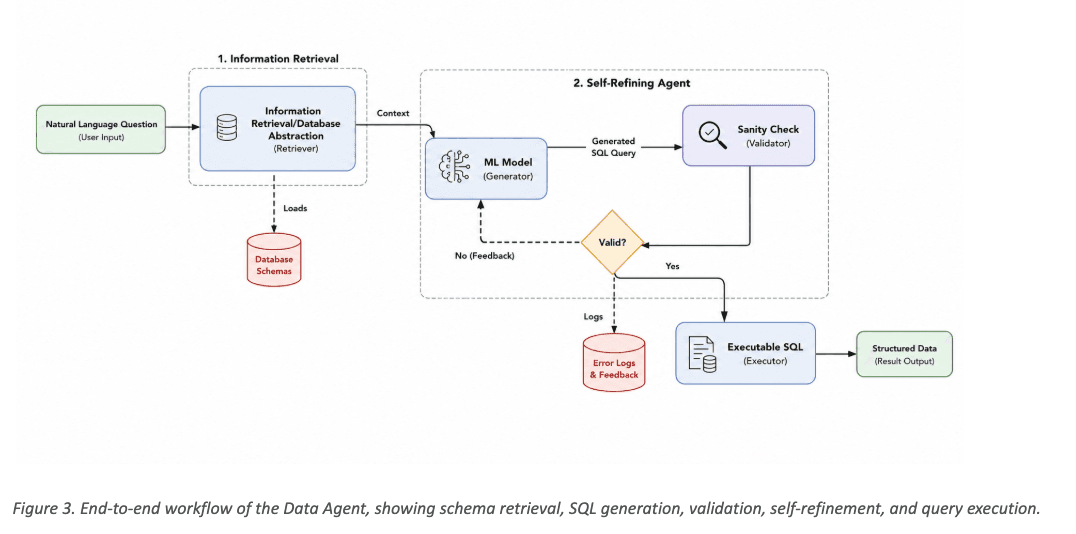
Gennem hele denne undersøgelse fandt vi ud af, at det at bygge et produktionsklart tekst-til-SQL-system handler om langt mere end blot at generere SQL. Forståelse af databaseskemaer, hentning af den rigtige kontekst, validering af genererede forespørgsler og raffinering af forkerte output viste sig at være lige så vigtigt som selve sprogmodellen.
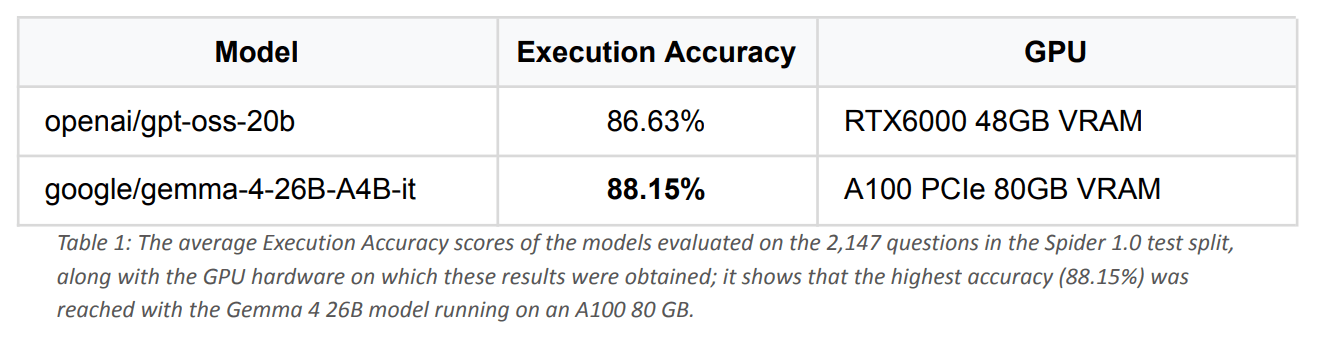
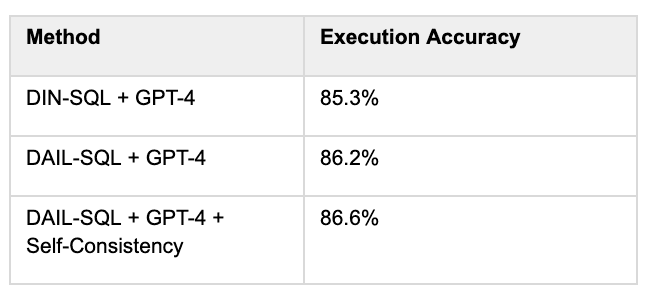
Vores udførelsesnøjagtighed på 88.15 % på Spider 1.0 viser, at open source-modeller kombineret med en veldesignet arkitektur kan levere yderst konkurrencedygtig ydeevne til tekst-til-SQL-opgaver i virksomheder. Endnu vigtigere er det, at det validerer designprincipperne bag vores Data Agent , som blev bygget til at fungere pålideligt på komplekse virksomhedsdatabaser i stedet for kun på benchmarkdatasæt.
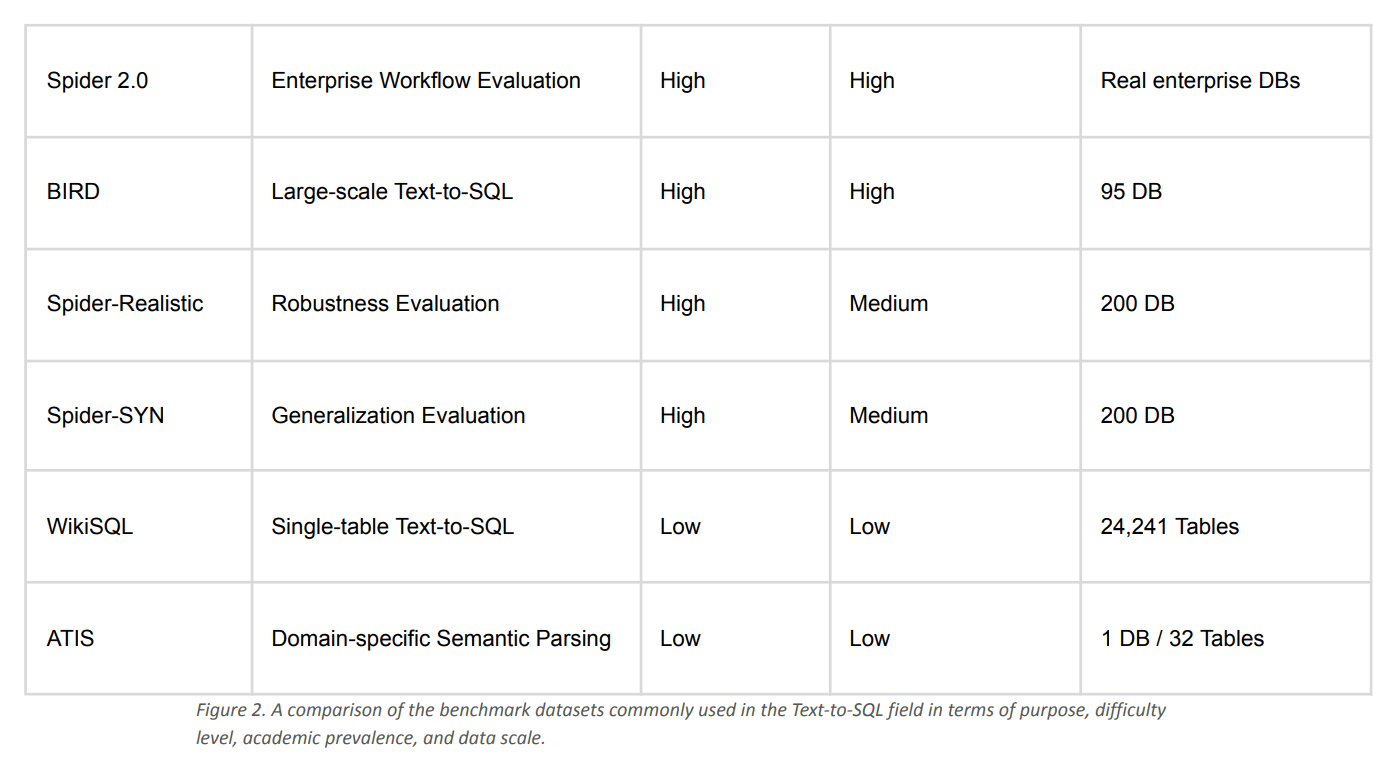
Spider 1.0 repræsenterer en vigtig milepæl, men det er kun begyndelsen på vores rejse. Vores næste skridt inkluderer evaluering af Data Agent på Spider 2.0 , større benchmarks på virksomhedsniveau og, vigtigst af alt, virkelige kundemiljøer, hvor databaseskemaer er betydeligt større, og forretningsspørgsmål er langt mere komplekse.
Vores langsigtede vision er ikke blot at bygge en bedre SQL-generator. Vi sigter mod at bygge intelligente dataagenter, der gør det muligt for organisationer at interagere med virksomhedsdata lige så naturligt, som de kommunikerer med en kollega – og kombinerer hentning, ræsonnement, validering og forklarlig AI i en pålidelig beslutningsstøtteplatform.