Entwicklung eines produktionsreifen Text-zu-SQL-Systems: Erreichen von 88.15 % mit Spider 1.0
Datum der Veröffentlichung
Juli 13, 2026
Teilen
Executive Summary
Der Aufbau eines produktionsreifen Text-zu-SQL-Systems erfordert weit mehr als die Generierung von SQL-Code mit einem umfangreichen Sprachmodell. Unternehmensanwendungen benötigen ein präzises Schemaverständnis, Kontextabruf, Validierung und Fehlerkorrektur, um zuverlässige Ergebnisse auf bisher unbekannten Datenbanken zu erzielen.
In dieser Studie haben wir unseren Datenagenten auf Spider 1.0 getestet und mit dem Gemma 4 26B -Modell eine Ausführungsgenauigkeit von 88.15 % erzielt . Anstatt uns ausschließlich auf die Benchmark-Ergebnisse zu konzentrieren, erläutert dieser Artikel die architektonischen Entscheidungen, die technischen Erkenntnisse und die Benchmark-Einblicke, die diesen Ergebnissen zugrunde liegen.
Jenseits der SQL-Generierung
Große Sprachmodelle haben die SQL-Generierung deutlich verbessert, doch der Aufbau eines produktionsreifen Text-zu-SQL-Systems erfordert weit mehr als die Übersetzung natürlicher Sprache in SQL. Unternehmensanwendungen müssen komplexe Datenbankschemata verstehen, den richtigen Kontext abrufen, generierte Abfragen validieren und zuverlässige Ergebnisse auf Datenbanken liefern, die ihnen unbekannt sind.
Um diese Fähigkeiten zu evaluieren, haben wir unseren Datenagenten mit Spider 1.0, dem am weitesten verbreiteten Text-zu-SQL-Benchmark, getestet. Mit dem Gemma 4 26B -Modell erreichte unser System eine Ausführungsgenauigkeit von 88.15 % . Dies zeigt, dass Architektur und Kontextmanagement genauso wichtig sind wie die Modellauswahl.
Warum Spider 1.0?
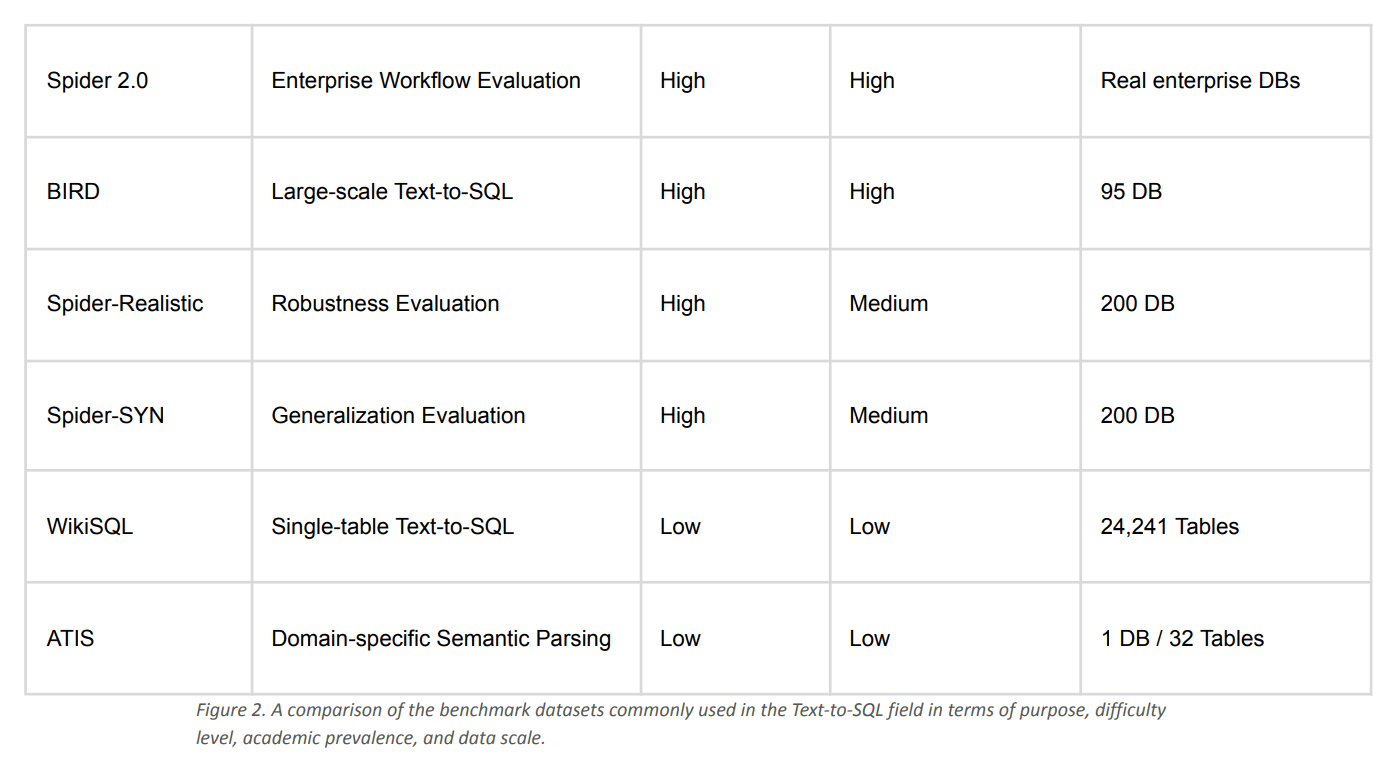
Die Wahl des richtigen Benchmarks ist genauso wichtig wie die Wahl des richtigen Modells. Obwohl neuere Datensätze wie Spider 2.0 und BIRD komplexere Unternehmensszenarien umfassen, ist Spider 1.0 nach wie vor der am weitesten verbreitete Benchmark zur Bewertung von Text-zu-SQL-Systemen und zum Vergleich von Ergebnissen aus der Fachliteratur.
Für unsere erste Evaluierung wählten wir Spider 1.0, da es eine standardisierte und etablierte Basis bietet. Es ermöglicht uns zu messen, wie effektiv unser Datenagent bisher unbekannte Datenbankschemata versteht und unter realistischen Bedingungen korrektes SQL generiert.
Abbildung 2 fasst zusammen, wie Spider 1.0 im Vergleich zu anderen gängigen Text-zu-SQL-Benchmarks abschneidet.
Erstellung des Datenagenten
Eine hohe Genauigkeit bei der Text-zu-SQL-Konvertierung lässt sich nicht allein durch die Verwendung eines größeren Sprachmodells erreichen. Im Rahmen unserer Benchmark-Tests stellten wir fest, dass Architektur und Kontextmanagement einen größeren Einfluss auf die Leistung hatten als die Modellauswahl allein.
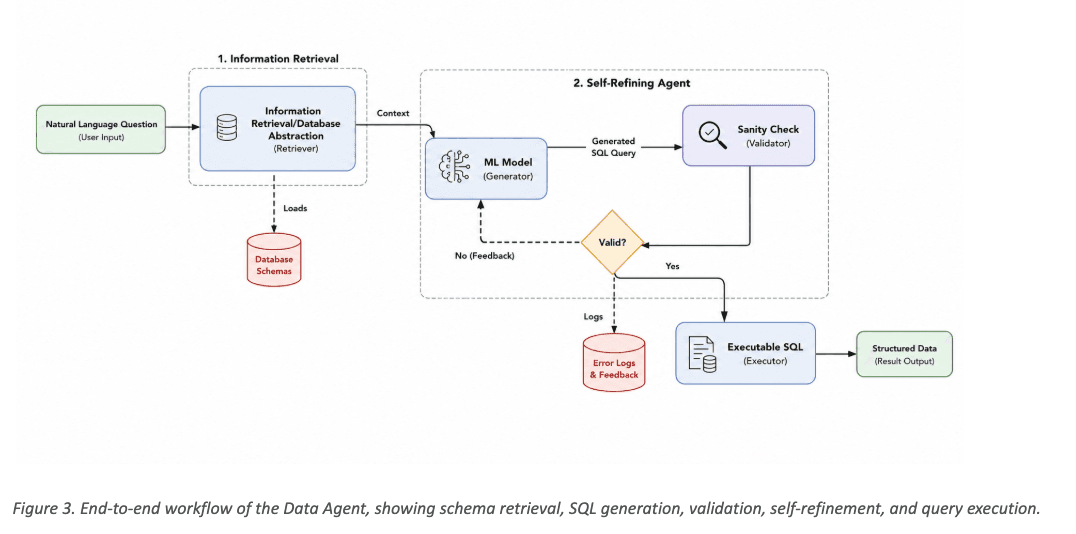
Unser Datenagent ist als mehrstufige Pipeline konzipiert, die das Problem schrittweise eingrenzt, bevor das LLM SQL-Anweisungen generiert. Anstatt dem Modell das gesamte Datenbankschema offenzulegen, ruft das System zunächst nur das relevante Schema und die Kontextinformationen ab, generiert dann eine SQL-Abfrage, validiert das Ergebnis und korrigiert häufige Fehler automatisch vor der Ausführung.
Wie in Abbildung 3 dargestellt , besteht die Architektur aus drei Hauptphasen:
Informationsrückgewinnung – Die Frage des Benutzers wird analysiert, um die relevanten Datenbankobjekte zu identifizieren, und nur die notwendigen Schemainformationen werden aus dem Metadatenspeicher abgerufen.
Selbstverfeinerndes Mittel – Das Sprachmodell generiert SQL-Anweisungen, validiert die Abfrage anhand des abgerufenen Schemas und verfeinert sie automatisch, wenn die Validierung fehlschlägt.
Ausführung und Reaktion – Nach der Validierung wird die SQL-Abfrage in der Zieldatenbank ausgeführt, und die Ergebnisse werden als strukturierte Daten oder als Antwort in natürlicher Sprache zurückgegeben.
Diese produktionsorientierte Architektur ist von Ideen aus DIN-SQL und DAIL-SQL inspiriert und wurde für Unternehmensumgebungen angepasst, in denen Zuverlässigkeit, Erklärbarkeit und Robustheit ebenso wichtig sind wie die Genauigkeit von Benchmarks.
Unsere Benchmarking-Reise
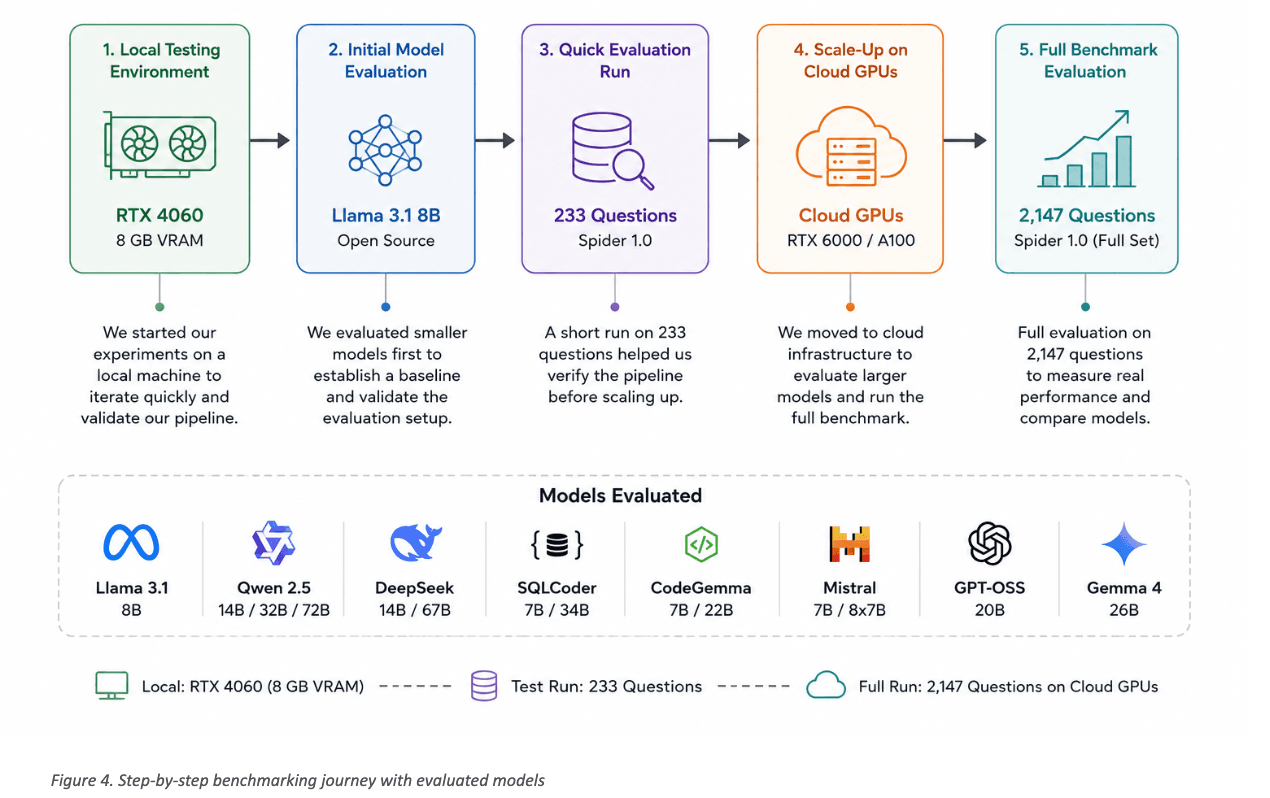
Die Auswahl des richtigen Sprachmodells war ein wichtiger Bestandteil unseres Benchmark-Prozesses. Anstatt ein einzelnes Modell zu evaluieren, experimentierten wir mit einer breiten Palette von Open-Source-Sprachmodellen, darunter Llama 3.1, Qwen 2.5, DeepSeek, SQLCoder, CodeGemma, Mistral, GPT-OSS und Gemma 4.
Um einen fairen Vergleich zu gewährleisten, haben wir jedes Modell anhand der Ausführungsgenauigkeit (Execution Accuracy, EA) bewertet , dem Standardmaß für Text-zu-SQL-Benchmarking. Im Gegensatz zu syntaxbasierten Metriken misst die Ausführungsgenauigkeit, ob das generierte SQL-Statement dasselbe Ergebnis wie die Referenzabfrage liefert, und ist somit ein besserer Indikator für die Leistung in der Praxis.
Unser Benchmarking-Prozess ist in Abbildung 4 dargestellt . Wir begannen mit Experimenten auf einer lokalen Workstation mit einer RTX 4060 (8 GB VRAM) . Kleinere Modelle ermöglichten uns schnelle Iterationen und die Validierung unserer Pipeline. Nachdem wir mit einer Teilmenge von 233 Spider-1.0-Fragen eine stabile Baseline etabliert hatten , wechselten wir zu Cloud-GPUs, um größere Modelle anhand des vollständigen Benchmarks mit 2,147 Fragen zu evaluieren . Dieser stufenweise Ansatz erlaubte uns, die Architektur effizient zu optimieren, bevor wir in umfangreiche Benchmark-Läufe investierten.
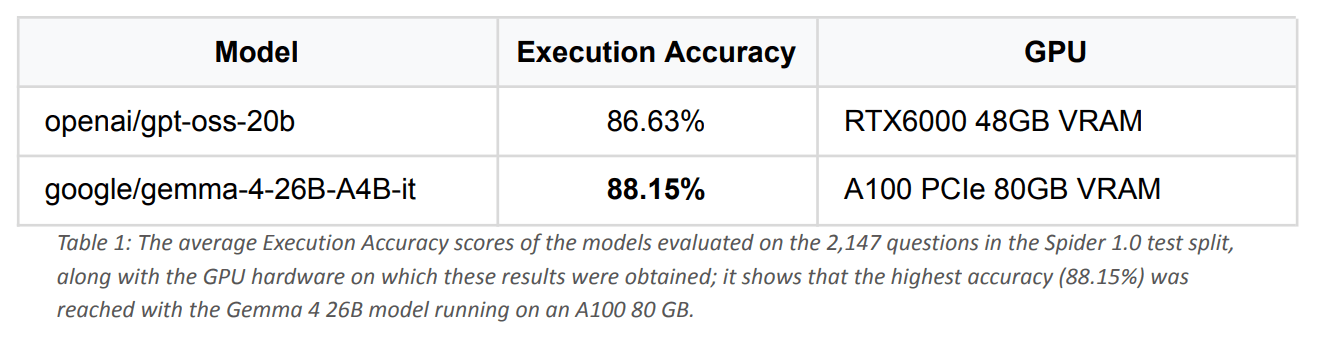
Wir evaluierten die finalen Modelle anhand des vollständigen Spider 1.0-Testdatensatzes mit 2,147 Fragen. Wie Tabelle 1 zeigt, erzielte Gemma 4 26B die höchste Punktzahl (88.15 %), gefolgt von GPT-OSS 20B (86.63 %). Diese Ergebnisse belegen, dass moderne Open-Source-LLMs in Kombination mit einer effizienten Retrieval- und Validierungspipeline eine sehr wettbewerbsfähige Text-zu-SQL-Performance erreichen können.
Wie schneiden diese Ergebnisse im Vergleich ab?
Benchmark-Ergebnisse sind nur dann aussagekräftig, wenn sie mit bereits veröffentlichten Arbeiten verglichen werden können. Um die Bedeutung unserer Ergebnisse besser zu verstehen, haben wir sowohl aktuelle Studien zum Thema Text-zu-SQL als auch vielzitierte Benchmark-Veröffentlichungen analysiert.
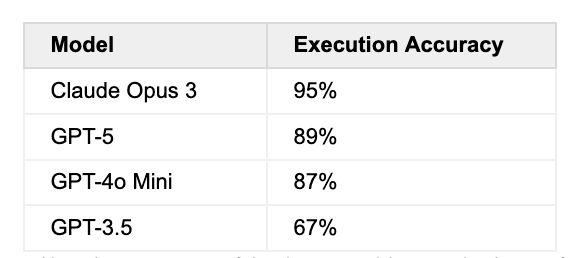
Tabelle 2: Die Genauigkeitsraten der in der SQL-of-Thought-Studie berichteten Closed-Source-Modelle auf einer Teilmenge des Spider-Datensatzes; im Vergleich zeigt sich, dass das in dieser Arbeit erzielte Ergebnis von 88.15 % über GPT-4o Mini (87 %) und auf einem Niveau nahe GPT-5 (89 %) liegt.
Aktuelle Arbeiten wie SQL-of-Thought [1] zeigen, dass führende proprietäre Modelle – darunter Claude Opus 3, GPT-5 und GPT-4o Mini – auf Spider-Benchmark-Teilmengen eine hohe Genauigkeit erzielen. Obwohl direkte Vergleiche aufgrund unterschiedlicher Evaluierungseinstellungen, Aufgabenstellungen und Benchmark-Teilmengen mit Vorsicht zu interpretieren sind, belegt unsere Ausführungsgenauigkeit von 88.15 % , dass Open-Source-Modelle eine vergleichbare Leistung erreichen können.
Obwohl diese Ergebnisse aus unterschiedlichen Evaluierungsumgebungen stammen und nicht direkt vergleichbar sind, liefern sie einen nützlichen Kontext für das Verständnis der aktuellen Leistungslandschaft von Text-zu-SQL-Systemen. Unser Benchmark zeigt, dass Open-Source-Modelle in Kombination mit einer gut konzipierten Architektur mittlerweile mit führenden proprietären Alternativen konkurrieren können.
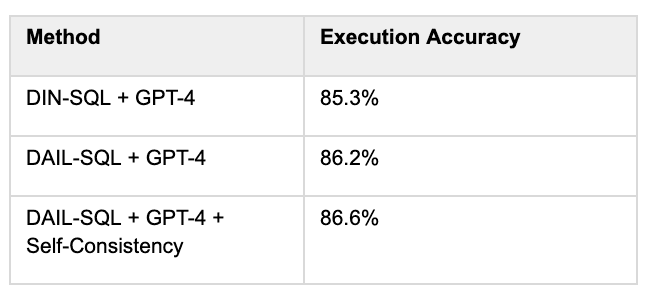
Wir verglichen unsere Ergebnisse auch mit produktionsorientierten Text-zu-SQL-Frameworks wie DIN-SQL [3] und DAIL- SQL, die große Sprachmodelle mit Techniken wie Schema-Verknüpfung, Prompt-Engineering, Selbstkonsistenz und Fehlerkorrektur kombinieren.
Tabelle 3: Die Ergebnisse der Ausführungsgenauigkeit verschiedener Methoden auf Spider 1.0 in der Studie „Text-to-SQL Empowered by Large Language Models: A Benchmark Evaluation“ [2]; sie zeigt den Einfluss auf die Genauigkeit nicht nur der Modellauswahl, sondern auch von Techniken wie Prompt Engineering, Schema-Verknüpfung und Selbstkonsistenz.
Unsere Ergebnisse bestätigen eine in der aktuellen Literatur weit verbreitete Schlussfolgerung: Eine hohe Text-zu-SQL-Performance hängt nicht nur vom Sprachmodell, sondern auch von der umgebenden Architektur ab. Effektives Schema-Abrufen, Kontextmanagement, Validierung und Selbstkorrektur sind oft genauso wichtig wie das Modell selbst.
Was wir gelernt haben
Benchmarking dient nicht nur der Messung der Genauigkeit, sondern auch dem Verständnis, wo und warum ein System versagt. Im Rahmen unserer Evaluierung analysierten wir fehlerhafte Vorhersagen und identifizierten mehrere wiederkehrende Muster, die die Endergebnisse beeinflussten.
Einige Fehler entstanden durch den Benchmark selbst. In wenigen Fällen führten Inkonsistenzen in den Referenz-SQL-Abfragen (Gold-SQL-Abfragen) dazu, dass logisch korrekte Vorhersagen als falsch markiert wurden. Andere Fälle betrafen mehrdeutige natürlichsprachliche Fragen oder Szenarien zur Auflösung von Gleichständen, in denen mehrere SQL-Abfragen gleichermaßen gültige Ergebnisse liefern konnten.
Wir beobachteten außerdem mehrere modellspezifische Verhaltensweisen, darunter unnötige Typkonvertierungen, inkonsistente Behandlung der Groß-/Kleinschreibung und gelegentliche Überkomplizierung ansonsten einfacher SQL-Abfragen. Diese Erkenntnisse unterstreichen die Wichtigkeit der Integration von Validierungs- und Selbstkorrekturmechanismen in die Data-Agent-Pipeline.
Unsere Analyse ergab insgesamt, dass viele der verbleibenden Fehler nicht auf Einschränkungen des Sprachmodells selbst, sondern auf Mehrdeutigkeiten im Benchmark oder auf Sonderfälle bei der SQL-Generierung zurückzuführen sind. Dies deutet darauf hin, dass weitere Verbesserungen bei der Abfrage, Validierung und Kontextverwaltung das System über die Schwelle von 90 % Ausführungsgenauigkeit hinausführen könnten.
Kosten und Effizienz
Hohe Genauigkeit ist nur ein Aspekt eines produktionsreifen Text-zu-SQL-Systems. In Unternehmensumgebungen sind Infrastrukturkosten, Datenschutz und Flexibilität bei der Bereitstellung gleichermaßen wichtige Faktoren.
Einer der Hauptvorteile unseres Ansatzes ist die vollständige Verwendung von Open-Source-Sprachmodellen. Während des gesamten Entwicklungsprozesses konnten wir die meisten Experimente lokal mit einer handelsüblichen RTX 4060 (8 GB VRAM) durchführen . Dies ermöglichte uns schnelle Iterationen ohne API- oder Token-Kosten. Umfangreichere Benchmark-Tests wurden erst nach Validierung der Architektur auf dedizierten Cloud-GPUs ausgeführt.
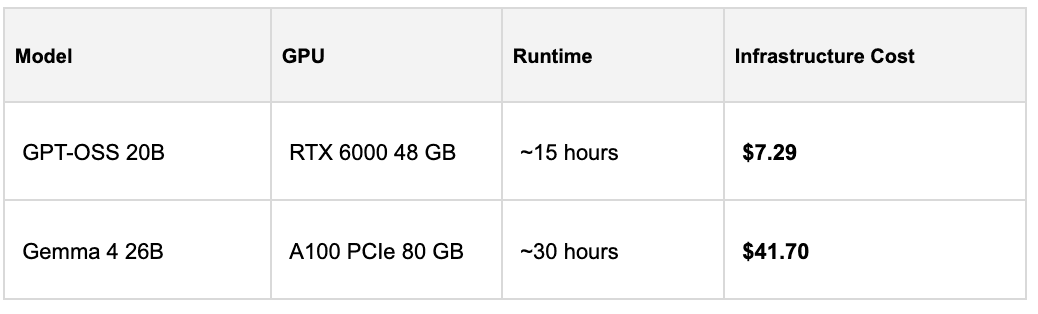
Für die vollständige Evaluierung von Spider 1.0 verwendeten wir RunPod Secure Cloud. Der Gemma 4 26B-Benchmark wurde auf einer A100 PCIe 80 GB GPU ausgeführt, während GPT-OSS 20B auf einer RTX 6000 48 GB GPU lief.
Die Infrastrukturkosten sind in Tabelle 4 zusammengefasst.
Obwohl die größten Benchmark-Tests Cloud-Infrastruktur erforderten, blieb der gesamte Entwicklungsprozess dank lokaler Experimente und Open-Source-Modellen kosteneffizient. Noch wichtiger ist, dass die resultierende Architektur vollständig in der eigenen Infrastruktur eines Unternehmens implementiert werden kann. Dadurch entfällt die Abhängigkeit von externen APIs, und gleichzeitig bietet sie mehr Kontrolle über Datenschutz, Compliance und Betriebskosten.
Dadurch eignet sich die Architektur besonders gut für Organisationen, die in datenschutzsensiblen, regulierten oder abgeschotteten Umgebungen tätig sind, wo Datensicherheit und Flexibilität bei der Bereitstellung entscheidende Anforderungen darstellen.
Jenseits von Spider 1.0
Benchmarks bieten eine objektive Möglichkeit zur Bewertung von KI-Systemen, sind aber nicht das alleinige Ziel. Ein hoher Benchmark-Wert ist nur dann wertvoll, wenn er sich in einer zuverlässigen Leistung in realen Anwendungen niederschlägt.
Im Verlauf dieser Studie stellten wir fest, dass die Entwicklung eines produktionsreifen Text-zu-SQL-Systems weit mehr umfasst als die reine SQL-Generierung. Das Verständnis von Datenbankschemata, das Abrufen des richtigen Kontexts, die Validierung generierter Abfragen und die Korrektur fehlerhafter Ausgaben erwiesen sich als ebenso wichtig wie das Sprachmodell selbst.
Unsere Ausführungsgenauigkeit von 88.15 % auf Spider 1.0 beweist, dass Open-Source-Modelle in Kombination mit einer durchdachten Architektur eine äußerst wettbewerbsfähige Leistung für Text-zu-SQL-Aufgaben in Unternehmen erzielen können. Noch wichtiger ist, dass sie die Designprinzipien unseres Datenagenten bestätigt , der für den zuverlässigen Betrieb auf komplexen Unternehmensdatenbanken und nicht nur auf Benchmark-Datensätzen entwickelt wurde.
Spider 1.0 stellt einen wichtigen Meilenstein dar, ist aber erst der Anfang unserer Reise. Zu den nächsten Schritten gehören die Evaluierung des Data Agents auf Spider 2.0 , umfangreichere Benchmarks im Unternehmensmaßstab und, vor allem, der Einsatz in realen Kundenumgebungen mit deutlich größeren Datenbankschemata und wesentlich komplexeren Geschäftsfragen.
Unsere langfristige Vision ist nicht einfach nur die Entwicklung eines besseren SQL-Generators. Wir wollen intelligente Datenagenten entwickeln, die es Unternehmen ermöglichen, so natürlich mit Unternehmensdaten zu interagieren wie mit einem Kollegen zu kommunizieren – durch die Kombination von Datenabfrage, Schlussfolgerung, Validierung und erklärbarer KI zu einer zuverlässigen Entscheidungsplattform.
Schlüssellektionen
Beim Benchmarking geht es nicht nur um die Messung der Genauigkeit, sondern auch darum zu verstehen, warum ein System erfolgreich ist oder scheitert.
Im Rahmen unserer Evaluierung identifizierten wir mehrere wiederkehrende Fehlermuster. Einige resultierten aus Unklarheiten im Benchmark selbst, darunter Inkonsistenzen in den Referenz-SQL-Abfragen und unzureichend spezifizierte Sortierbedingungen. Andere spiegelten typische Verhaltensweisen von LLM wider, wie unnötige Typumwandlungen oder inkonsistente Behandlung von Werten, die zwischen Groß- und Kleinschreibung unterscheiden.
Diese Beobachtungen untermauerten eine der zentralen Erkenntnisse unserer Arbeit: Die Architektur ist ebenso wichtig wie die Modellauswahl. Retrieval, Schemaverknüpfung, Validierung und Selbstkorrektur trugen ebenso viel zur endgültigen Leistung bei wie das zugrunde liegende Sprachmodell.
Obwohl die Einschränkungen der Benchmarks zwangsläufig das Endergebnis beeinflussen, deutet unsere Analyse darauf hin, dass weitere Verbesserungen im Kontextmanagement und in der Validierung das System über die 90%-Marke der Ausführungsgenauigkeit hinausbringen könnten.
Weiter denken
Spider 1.0 lieferte eine wichtige Grundlage für die Bewertung unseres Datenagenten, stellt aber nur den ersten Schritt hin zu einer produktionsreifen KI für Unternehmen dar.
Unser nächster Schwerpunkt liegt auf der Bewertung der Architektur anhand anspruchsvollerer Benchmarks wie Spider 2.0 und, was noch wichtiger ist, anhand realer Unternehmensdatenbanken, in denen die Schemata wesentlich größer sind, die Dokumentation oft unvollständig ist und die geschäftlichen Fragestellungen weitaus komplexer sind.
Unser Ziel ist es nicht einfach, ein weiteres Text-zu-SQL-System zu entwickeln. Wir entwickeln intelligente Datenagenten , die Abruf, Schlussfolgerung, Validierung und Erklärbarkeit kombinieren, um Unternehmen eine natürliche und zuverlässige Interaktion mit Unternehmensdaten zu ermöglichen.
Referenzen
[1] Saumya Chaturvedi, Aman Chadha, Laurent Bindschaedler. arXiv. „SQL-of-Thought: Multi-agentic Text-to-SQL with Guided Error Correction.“ arXiv. Juni 2026. https://arxiv.org/abs/2509.00581
[2] Dawei Gao, Haibin Wang, Yaliang Li, Xiuyu Sun, Yichen Qian, Bolin Ding, Jingren Zhou „Text-to-SQL unterstützt durch große Sprachmodelle: Eine Benchmark-Bewertung“ arXiv. Juni 2026