Δημιουργία ενός συστήματος μετατροπής κειμένου σε SQL έτοιμου για παραγωγή: Επίτευξη 88.15% στο Spider 1.0
Ημερομηνία δημοσίευσης
Ιούλιος 13, 2026
Κοινοποίηση
Περίληψη
Η δημιουργία ενός συστήματος μετατροπής κειμένου σε SQL, έτοιμου για παραγωγή, απαιτεί πολύ περισσότερα από τη δημιουργία SQL με ένα μεγάλο γλωσσικό μοντέλο. Οι εταιρικές εφαρμογές απαιτούν ακριβή κατανόηση σχήματος, ανάκτηση περιβάλλοντος, επικύρωση και διόρθωση σφαλμάτων για την παραγωγή αξιόπιστων αποτελεσμάτων σε βάσεις δεδομένων που δεν έχουν ακόμη δημοσιευτεί.
Σε αυτήν τη μελέτη, συγκρίνουμε τον Data Agent μας στο Spider 1.0 και επιτυγχάνουμε ακρίβεια εκτέλεσης 88.15% χρησιμοποιώντας το μοντέλο Gemma 4 26B . Αντί να επικεντρωθούμε αποκλειστικά σε βαθμολογίες συγκριτικής αξιολόγησης, αυτό το άρθρο μοιράζεται τις αρχιτεκτονικές αποφάσεις, τα μαθήματα μηχανικής και τις γνώσεις συγκριτικής αξιολόγησης πίσω από αυτά τα αποτελέσματα.
Πέρα από τη δημιουργία SQL
Τα μοντέλα μεγάλων γλωσσών έχουν βελτιώσει σημαντικά την παραγωγή SQL, αλλά η δημιουργία ενός συστήματος Text-to-SQL έτοιμου για παραγωγή απαιτεί πολύ περισσότερα από τη μετάφραση της φυσικής γλώσσας σε SQL. Οι εταιρικές εφαρμογές πρέπει να κατανοούν σύνθετα σχήματα βάσεων δεδομένων, να ανακτούν το σωστό περιβάλλον, να επικυρώνουν τα δημιουργημένα ερωτήματα και να παράγουν αξιόπιστα αποτελέσματα σε βάσεις δεδομένων που δεν έχουν ξαναδεί.
Για να αξιολογήσουμε αυτές τις δυνατότητες, συγκρίναμε τον Data Agent μας με το Spider 1.0, το πιο ευρέως χρησιμοποιούμενο σημείο αναφοράς Text-to-SQL. Χρησιμοποιώντας το μοντέλο Gemma 4 26B , το σύστημά μας πέτυχε ακρίβεια εκτέλεσης 88.15% , αποδεικνύοντας ότι η αρχιτεκτονική και η διαχείριση περιβάλλοντος είναι εξίσου σημαντικά με την επιλογή μοντέλου.
Γιατί Spider 1.0;
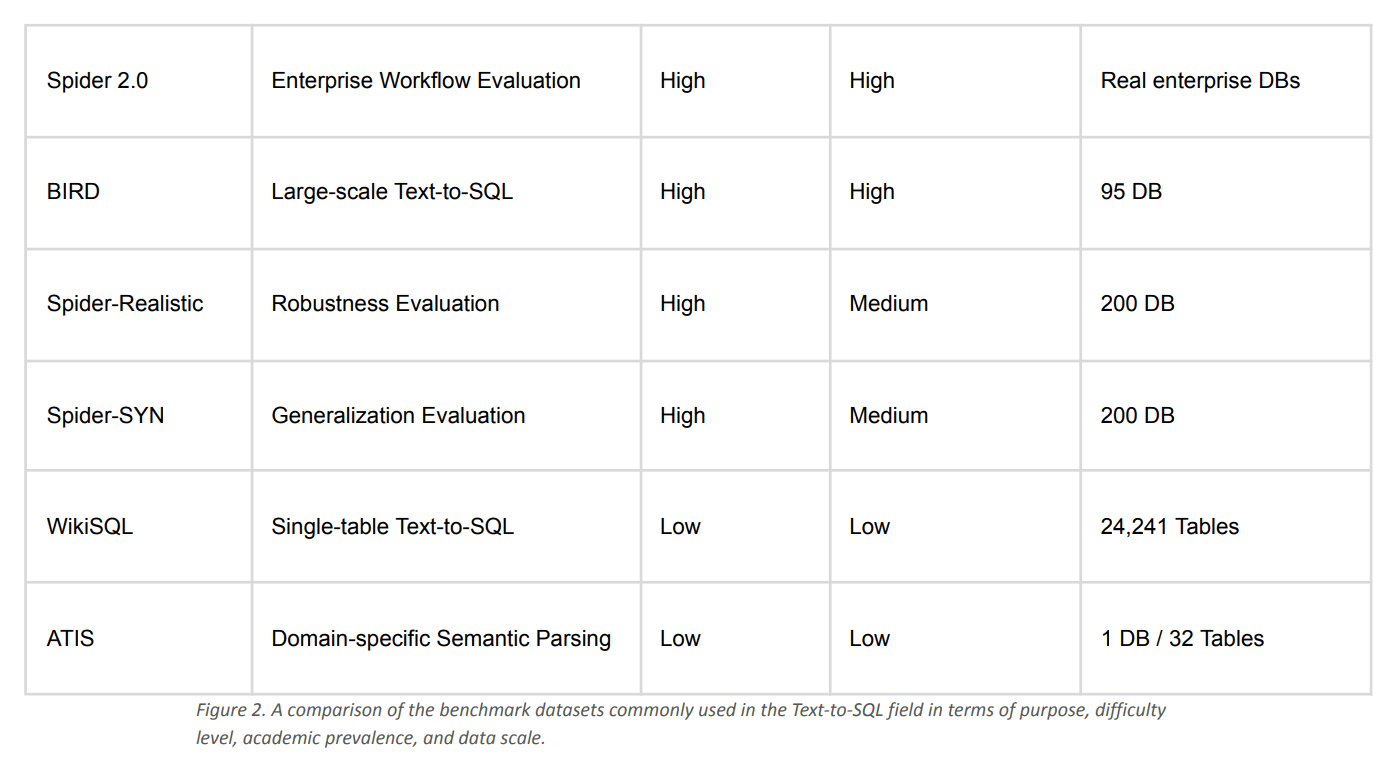
Η επιλογή του σωστού σημείου αναφοράς είναι εξίσου σημαντική με την επιλογή του σωστού μοντέλου. Ενώ τα νεότερα σύνολα δεδομένων, όπως το Spider 2.0 και το BIRD, εισάγουν πιο σύνθετα επιχειρηματικά σενάρια, το Spider 1.0 παραμένει το πιο ευρέως υιοθετημένο σημείο αναφοράς για την αξιολόγηση συστημάτων Text-to-SQL και τη σύγκριση αποτελεσμάτων σε όλη τη βιβλιογραφία.
Για την αρχική μας αξιολόγηση, επιλέξαμε το Spider 1.0 επειδή παρέχει μια τυποποιημένη και καθιερωμένη γραμμή βάσης. Μας επιτρέπει να μετρήσουμε πόσο αποτελεσματικά ο Data Agent μας κατανοεί προηγουμένως απαρατήρητα σχήματα βάσης δεδομένων και παράγει σωστό SQL υπό ρεαλιστικές συνθήκες.
Το Σχήμα 2 συνοψίζει τον τρόπο με τον οποίο το Spider 1.0 συγκρίνεται με άλλα συνήθως χρησιμοποιούμενα benchmarks Text-to-SQL.
Δημιουργία του Data Agent
Η επίτευξη υψηλής ακρίβειας μετατροπής κειμένου σε SQL δεν είναι απλώς θέμα χρήσης ενός μεγαλύτερου γλωσσικού μοντέλου. Καθ' όλη τη διαδικασία συγκριτικής αξιολόγησης, διαπιστώσαμε ότι η αρχιτεκτονική και η διαχείριση περιβάλλοντος είχαν μεγαλύτερο αντίκτυπο στην απόδοση από ό,τι η επιλογή μοντέλου από μόνη της.
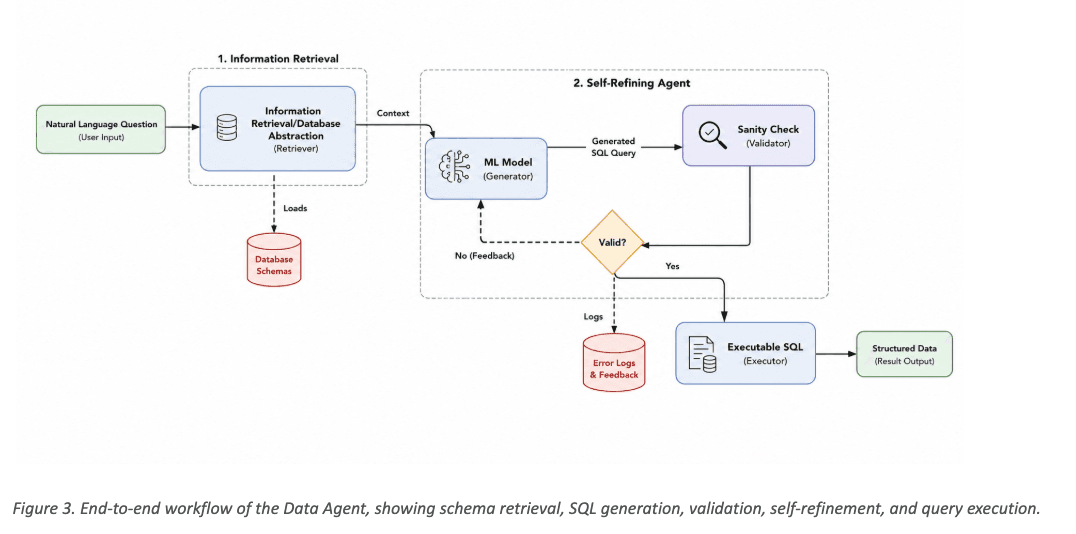
Ο Data Agent μας έχει σχεδιαστεί ως ένας πολυσταδιακός αγωγός που σταδιακά περιορίζει το πρόβλημα πριν ζητήσει από τον LLM να δημιουργήσει SQL. Αντί να εκθέσει ολόκληρο το σχήμα βάσης δεδομένων στο μοντέλο, το σύστημα ανακτά πρώτα μόνο το σχετικό σχήμα και τις πληροφορίες περιβάλλοντος, στη συνέχεια δημιουργεί ένα ερώτημα SQL, επικυρώνει το αποτέλεσμα και διορθώνει αυτόματα τα συνηθισμένα σφάλματα πριν από την εκτέλεση.
Όπως φαίνεται στο Σχήμα 3 , η αρχιτεκτονική αποτελείται από τρία κύρια στάδια:
Ανάκτηση πληροφορίας – Η ερώτηση του χρήστη αναλύεται για τον εντοπισμό των σχετικών αντικειμένων βάσης δεδομένων και μόνο οι απαραίτητες πληροφορίες σχήματος ανακτώνται από το χώρο αποθήκευσης μεταδεδομένων.
Αυτοκαθαριστικός παράγοντας – Το γλωσσικό μοντέλο δημιουργεί SQL, επικυρώνει το ερώτημα σε σχέση με το ανακτημένο σχήμα και το βελτιώνει αυτόματα κάθε φορά που η επικύρωση αποτυγχάνει.
Εκτέλεση & Απόκριση – Μόλις επικυρωθεί, το ερώτημα SQL εκτελείται στη βάση δεδομένων-στόχο και τα αποτελέσματα επιστρέφονται ως δομημένα δεδομένα ή ως απόκριση φυσικής γλώσσας.
Αυτή η αρχιτεκτονική που βασίζεται στην παραγωγή είναι εμπνευσμένη από ιδέες που εισήχθησαν στις γλώσσες DIN-SQL και DAIL-SQL , ενώ παράλληλα προσαρμόζεται σε εταιρικά περιβάλλοντα όπου η αξιοπιστία, η επεξηγηματικότητα και η ευρωστία είναι εξίσου σημαντικές με την ακρίβεια των μετρήσεων αναφοράς.
Το ταξίδι μας για συγκριτική αξιολόγηση
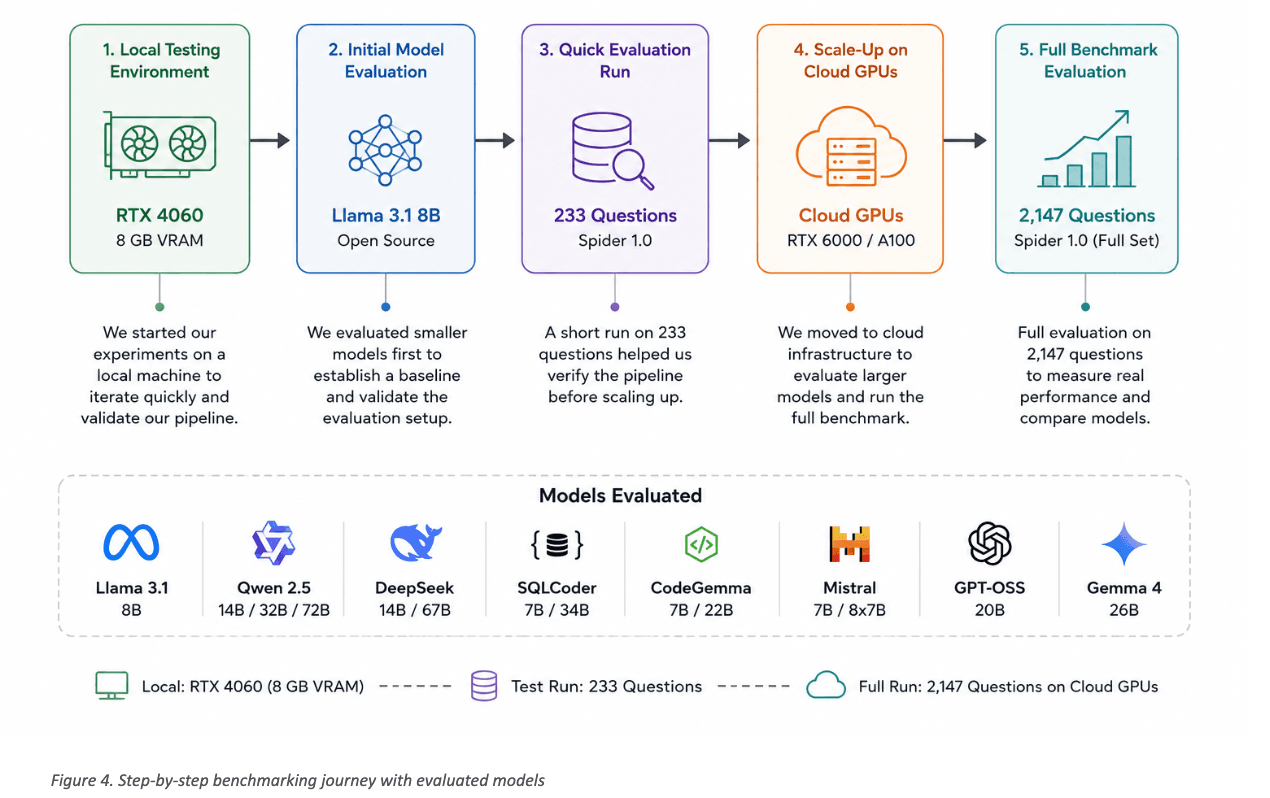
Η επιλογή του σωστού γλωσσικού μοντέλου ήταν ένα σημαντικό μέρος της διαδικασίας συγκριτικής αξιολόγησης. Αντί να αξιολογήσουμε ένα μόνο μοντέλο, πειραματιστήκαμε με ένα ευρύ φάσμα LLM ανοιχτού κώδικα, συμπεριλαμβανομένων των Llama 3.1, Qwen 2.5, DeepSeek, SQLCoder, CodeGemma, Mistral, GPT-OSS και Gemma 4.
Για να διασφαλίσουμε μια δίκαιη σύγκριση, αξιολογήσαμε κάθε μοντέλο χρησιμοποιώντας την Ακρίβεια Εκτέλεσης (EA) , την τυπική μέτρηση για τη συγκριτική αξιολόγηση κειμένου σε SQL. Σε αντίθεση με τις μετρήσεις που βασίζονται στη σύνταξη, η Ακρίβεια Εκτέλεσης μετρά εάν η παραγόμενη SQL επιστρέφει το ίδιο αποτέλεσμα με το ερώτημα αναφοράς, καθιστώντας την καλύτερη ένδειξη της απόδοσης στον πραγματικό κόσμο.
Το ταξίδι μας στη συγκριτική αξιολόγηση απεικονίζεται στο Σχήμα 4. Ξεκινήσαμε πειραματιζόμενοι σε έναν τοπικό σταθμό εργασίας εξοπλισμένο με RTX 4060 (8 GB VRAM) , όπου τα μικρότερα μοντέλα μας επέτρεψαν να επαναλάβουμε γρήγορα και να επικυρώσουμε τον αγωγό μας. Αφού δημιουργήσαμε μια σταθερή γραμμή βάσης χρησιμοποιώντας ένα υποσύνολο 233 ερωτήσεων Spider 1.0, προχωρήσαμε σε GPU cloud για να αξιολογήσουμε μεγαλύτερα μοντέλα στο πλήρες benchmark των 2,147 ερωτήσεων . Αυτή η σταδιακή προσέγγιση μας επέτρεψε να βελτιστοποιήσουμε αποτελεσματικά την αρχιτεκτονική πριν επενδύσουμε σε εκτελέσεις benchmark μεγάλης κλίμακας.
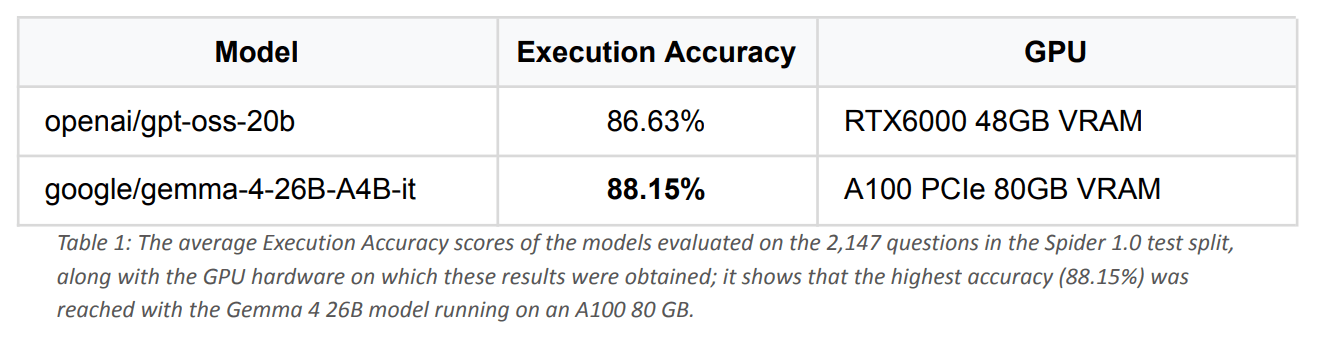
Αξιολογήσαμε τα τελικά μοντέλα στο πλήρες τεστ Spider 1.0 που περιείχε 2,147 ερωτήσεις. Όπως φαίνεται στον Πίνακα 1, το Gemma 4 26B πέτυχε την υψηλότερη βαθμολογία (88.15%), ακολουθούμενο από το GPT-OSS 20B (86.63%). Αυτά τα αποτελέσματα καταδεικνύουν ότι τα σύγχρονα LLM ανοιχτού κώδικα, όταν συνδυάζονται με έναν αποτελεσματικό αγωγό ανάκτησης και επικύρωσης, μπορούν να επιτύχουν εξαιρετικά ανταγωνιστική απόδοση μετατροπής κειμένου σε SQL.
Πώς συγκρίνονται αυτά τα αποτελέσματα;
Οι βαθμολογίες αναφοράς έχουν νόημα μόνο όταν μπορούν να συγκριθούν με προηγουμένως δημοσιευμένες εργασίες. Για να κατανοήσουμε καλύτερα τη σημασία των αποτελεσμάτων μας, εξετάσαμε τόσο πρόσφατες μελέτες Text-to-SQL όσο και ευρέως αναφερόμενες εργασίες αναφοράς.
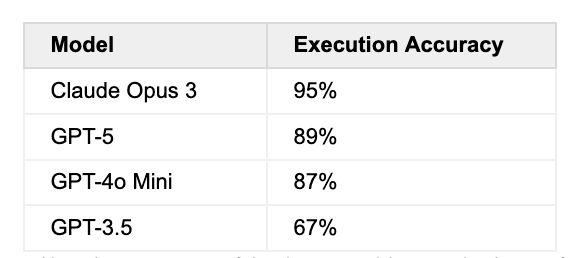
Πίνακας 2: Τα ποσοστά ακρίβειας των μοντέλων κλειστού κώδικα που αναφέρθηκαν στη μελέτη SQL-of-Thought σε ένα υποσύνολο του συνόλου δεδομένων Spider. Δείχνει, συγκριτικά, ότι το αποτέλεσμα 88.15% που λήφθηκε σε αυτήν την εργασία τοποθετείται πάνω από το GPT-4o Mini (87%) και σε επίπεδο κοντά στο GPT-5 (89%).
Πρόσφατες εργασίες όπως το SQL-of-Thought [1] αναφέρουν ότι κορυφαία μοντέλα κλειστού κώδικα—συμπεριλαμβανομένων των Claude Opus 3, GPT-5 και GPT-4o Mini —επιτυγχάνουν υψηλή ακρίβεια σε υποσύνολα αναφοράς Spider. Ενώ οι άμεσες συγκρίσεις θα πρέπει να ερμηνεύονται προσεκτικά λόγω διαφορών στις ρυθμίσεις αξιολόγησης, τα μηνύματα και τα υποσύνολα αναφοράς, η ακρίβεια εκτέλεσης 88.15% που παρουσιάζουμε καταδεικνύει ότι τα μοντέλα ανοιχτού κώδικα μπορούν να επιτύχουν απόδοση εντός του ίδιου ανταγωνιστικού εύρους.
Παρόλο που αυτά τα αποτελέσματα προέρχονται από διαφορετικά περιβάλλοντα αξιολόγησης και δεν θα πρέπει να συγκρίνονται άμεσα, παρέχουν χρήσιμο πλαίσιο για την κατανόηση του τρέχοντος τοπίου απόδοσης των συστημάτων Text-to-SQL. Η συγκριτική μας αξιολόγηση καταδεικνύει ότι τα μοντέλα ανοιχτού κώδικα μπορούν πλέον να ανταγωνιστούν τις κορυφαίες εναλλακτικές λύσεις κλειστού κώδικα όταν συνδυάζονται με μια καλά σχεδιασμένη αρχιτεκτονική.
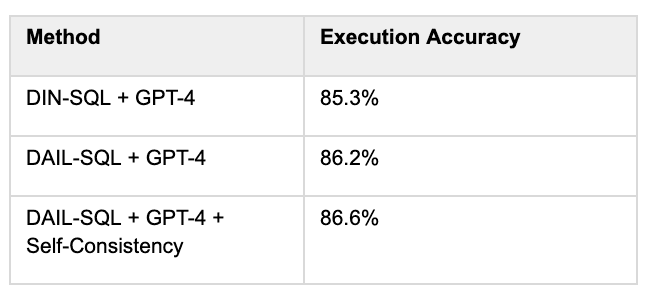
Συγκρίναμε επίσης τα αποτελέσματά μας με πλαίσια μετατροπής κειμένου σε SQL που είναι προσανατολισμένα στην παραγωγή, όπως το DIN-SQL [3] και το DAIL-SQ L, τα οποία συνδυάζουν μεγάλα γλωσσικά μοντέλα με τεχνικές όπως η σύνδεση σχημάτων, η άμεση μηχανική, η αυτοσυνέπεια και η διόρθωση σφαλμάτων.
Πίνακας 3: Τα αποτελέσματα ακρίβειας εκτέλεσης διαφορετικών μεθόδων στο Spider 1.0 στη μελέτη "Text-to-SQL Empowered by Large Language Models: A Benchmark Evaluation" [2]. Αποκαλύπτει τον αντίκτυπο στην ακρίβεια όχι μόνο της επιλογής μοντέλου αλλά και τεχνικών όπως η άμεση μηχανική, η σύνδεση σχημάτων και η αυτοσυνέπεια.
Τα ευρήματά μας ενισχύουν ένα συμπέρασμα που είναι κοινό σε όλη την πρόσφατη βιβλιογραφία: η υψηλή απόδοση της μετατροπής κειμένου σε SQL εξαρτάται όχι μόνο από το γλωσσικό μοντέλο, αλλά και από την περιβάλλουσα αρχιτεκτονική. Η αποτελεσματική ανάκτηση σχήματος, η διαχείριση περιβάλλοντος, η επικύρωση και η αυτοδιόρθωση είναι συχνά εξίσου σημαντικά με το ίδιο το μοντέλο.
Τι μάθαμε
Η συγκριτική αξιολόγηση δεν αφορά μόνο τη μέτρηση της ακρίβειας — αφορά επίσης την κατανόηση του πού και του γιατί ένα σύστημα αποτυγχάνει. Καθ' όλη τη διάρκεια της αξιολόγησής μας, αναλύσαμε λανθασμένες προβλέψεις και εντοπίσαμε διάφορα επαναλαμβανόμενα μοτίβα που επηρέασαν τις τελικές βαθμολογίες.
Ορισμένα σφάλματα προήλθαν από το ίδιο το benchmark. Σε έναν μικρό αριθμό περιπτώσεων, ασυνέπειες στα ερωτήματα SQL αναφοράς (χρυσά) προκάλεσαν την επισήμανση λογικά σωστών προβλέψεων ως λανθασμένων. Άλλες περιπτώσεις αφορούσαν ασαφείς ερωτήσεις φυσικής γλώσσας ή σενάρια ισοβαθμίας, όπου πολλά ερωτήματα SQL μπορούσαν νόμιμα να παράγουν εξίσου έγκυρες απαντήσεις.
Παρατηρήσαμε επίσης αρκετές συμπεριφορές που αφορούν συγκεκριμένα μοντέλα, όπως περιττές μετατροπές τύπων, ασυνεπή χειρισμό της ευαισθησίας πεζών-κεφαλαίων και περιστασιακή υπερβολική πολυπλοκότητα απλών κατά τα άλλα ερωτημάτων SQL. Αυτά τα ευρήματα ενίσχυσαν τη σημασία της ενσωμάτωσης μηχανισμών επικύρωσης και αυτοδιόρθωσης στη διοχέτευση του Data Agent.
Συνολικά, η ανάλυσή μας έδειξε ότι πολλά από τα εναπομείναντα σφάλματα δεν προκλήθηκαν από περιορισμούς του ίδιου του γλωσσικού μοντέλου, αλλά από ασάφειες στις περιπτώσεις αναφοράς ή στα όρια της δημιουργίας SQL. Αυτό υποδηλώνει ότι περαιτέρω βελτιώσεις στην ανάκτηση, την επικύρωση και τη διαχείριση περιβάλλοντος θα μπορούσαν να ωθήσουν το σύστημα πέρα από το όριο ακρίβειας εκτέλεσης 90%.
Κόστος και Αποδοτικότητα
Η υψηλή ακρίβεια είναι μόνο μία πτυχή ενός συστήματος μετατροπής κειμένου σε SQL, έτοιμου για παραγωγή. Σε εταιρικά περιβάλλοντα, το κόστος υποδομής, το απόρρητο δεδομένων και η ευελιξία ανάπτυξης είναι εξίσου σημαντικά ζητήματα.
Ένα από τα βασικά πλεονεκτήματα της προσέγγισής μας είναι ότι βασίζεται εξ ολοκλήρου σε μοντέλα γλώσσας ανοιχτού κώδικα. Καθ' όλη τη διάρκεια της διαδικασίας ανάπτυξης, καταφέραμε να εκτελέσουμε τα περισσότερα πειράματα τοπικά χρησιμοποιώντας μια κάρτα γραφικών RTX 4060 (8 GB VRAM) καταναλωτικού επιπέδου , επιτρέποντάς μας να κάνουμε γρήγορα επαναλήψεις χωρίς να επιβαρυνθούμε με κόστος API ή token. Μεγαλύτερες δοκιμές benchmark εκτελέστηκαν στη συνέχεια σε αποκλειστικές GPU cloud μόνο μετά την επικύρωση της αρχιτεκτονικής.
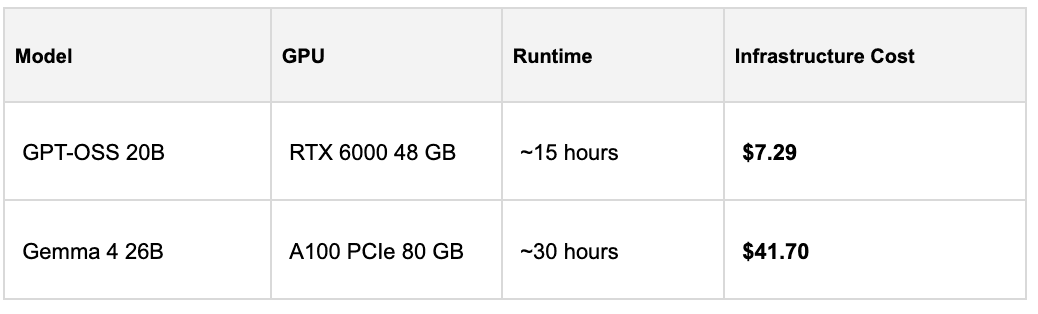
Χρησιμοποιήσαμε το RunPod Secure Cloud για την πλήρη αξιολόγηση του Spider 1.0. Το benchmark Gemma 4 26B εκτελέστηκε σε μια GPU A100 PCIe 80 GB, ενώ το GPT-OSS 20B εκτελέστηκε σε μια GPU RTX 6000 48 GB.
Το κόστος των υποδομών συνοψίζεται στον Πίνακα 4.
Παρόλο που οι μεγαλύτερες δοκιμές benchmark απαιτούσαν υποδομή cloud, η συνολική διαδικασία ανάπτυξης παρέμεινε οικονομικά αποδοτική χάρη στον τοπικό πειραματισμό και τα μοντέλα ανοιχτού κώδικα. Το πιο σημαντικό είναι ότι η προκύπτουσα αρχιτεκτονική μπορεί να αναπτυχθεί εξ ολοκλήρου εντός της υποδομής ενός οργανισμού, εξαλείφοντας την εξάρτηση από εξωτερικά API, παρέχοντας παράλληλα μεγαλύτερο έλεγχο στο απόρρητο των δεδομένων, τη συμμόρφωση και το λειτουργικό κόστος.
Αυτό καθιστά την αρχιτεκτονική ιδιαίτερα κατάλληλη για οργανισμούς που λειτουργούν σε περιβάλλοντα ευαίσθητα στην προστασία της ιδιωτικής ζωής, σε ρυθμιζόμενα περιβάλλοντα ή σε περιβάλλοντα με κενά ασφαλείας, όπου η ασφάλεια των δεδομένων και η ευελιξία ανάπτυξης αποτελούν κρίσιμες απαιτήσεις.
Πέρα από την Αράχνη 1.0
Τα benchmarks παρέχουν έναν αντικειμενικό τρόπο αξιολόγησης συστημάτων Τεχνητής Νοημοσύνης, αλλά δεν αποτελούν τον τελικό στόχο. Μια υψηλή βαθμολογία benchmark είναι πολύτιμη μόνο εάν μεταφράζεται σε αξιόπιστη απόδοση σε εφαρμογές του πραγματικού κόσμου.
Σε όλη τη διάρκεια αυτής της μελέτης, διαπιστώσαμε ότι η δημιουργία ενός συστήματος μετατροπής κειμένου σε SQL, έτοιμου για παραγωγή, είναι πολύ περισσότερο από την απλή δημιουργία SQL. Η κατανόηση των σχημάτων βάσης δεδομένων, η ανάκτηση του σωστού περιβάλλοντος, η επικύρωση των δημιουργημένων ερωτημάτων και η βελτίωση των λανθασμένων εξόδων αποδείχθηκαν εξίσου σημαντικές με το ίδιο το γλωσσικό μοντέλο.
Η ακρίβεια εκτέλεσης 88.15% στο Spider 1.0 καταδεικνύει ότι τα μοντέλα ανοιχτού κώδικα, σε συνδυασμό με μια καλά σχεδιασμένη αρχιτεκτονική, μπορούν να προσφέρουν εξαιρετικά ανταγωνιστική απόδοση για εταιρικές εργασίες μετατροπής κειμένου σε SQL. Το πιο σημαντικό είναι ότι επικυρώνει τις αρχές σχεδιασμού πίσω από τον Data Agent μας , ο οποίος δημιουργήθηκε για να λειτουργεί αξιόπιστα σε σύνθετες εταιρικές βάσεις δεδομένων και όχι μόνο σε σύνολα δεδομένων αναφοράς.
Το Spider 1.0 αποτελεί ένα σημαντικό ορόσημο, αλλά είναι μόνο η αρχή του ταξιδιού μας. Τα επόμενα βήματά μας περιλαμβάνουν την αξιολόγηση του Data Agent στο Spider 2.0 , μεγαλύτερα benchmarks σε εταιρική κλίμακα και, το πιο σημαντικό, πραγματικά περιβάλλοντα πελατών όπου τα σχήματα βάσεων δεδομένων είναι σημαντικά μεγαλύτερα και τα επιχειρηματικά ερωτήματα πολύ πιο περίπλοκα.
Το μακροπρόθεσμο όραμά μας δεν είναι απλώς να κατασκευάσουμε μια καλύτερη γεννήτρια SQL. Στόχος μας είναι να δημιουργήσουμε έξυπνους Data Agents που θα επιτρέπουν στους οργανισμούς να αλληλεπιδρούν με τα εταιρικά δεδομένα τόσο φυσικά όσο επικοινωνούν με έναν συνάδελφο — συνδυάζοντας την ανάκτηση, τη συλλογιστική, την επικύρωση και την επεξηγήσιμη Τεχνητή Νοημοσύνη σε μια αξιόπιστη πλατφόρμα υποστήριξης αποφάσεων.
Βασικά μαθήματα
Η συγκριτική αξιολόγηση δεν αφορά μόνο τη μέτρηση της ακρίβειας — αφορά την κατανόηση των λόγων για τους οποίους ένα σύστημα επιτυγχάνει ή αποτυγχάνει.
Καθ' όλη τη διάρκεια της αξιολόγησής μας, εντοπίσαμε αρκετά επαναλαμβανόμενα μοτίβα σφαλμάτων. Μερικά προέρχονταν από ασάφειες στο ίδιο το benchmark, συμπεριλαμβανομένων ασυνεπειών σε ερωτήματα SQL αναφοράς και μη καθορισμένων συνθηκών ταξινόμησης. Άλλα αντανακλούσαν συνήθεις συμπεριφορές LLM, όπως περιττή μετατροπή τύπων ή ασυνεπή χειρισμό τιμών που κάνουν διάκριση πεζών-κεφαλαίων.
Αυτές οι παρατηρήσεις ενίσχυσαν ένα από τα κεντρικά ευρήματα της εργασίας μας: η αρχιτεκτονική έχει την ίδια σημασία με την επιλογή μοντέλου. Η ανάκτηση, η σύνδεση σχημάτων, η επικύρωση και η αυτοδιόρθωση συνέβαλαν στην τελική απόδοση εξίσου με το υποκείμενο γλωσσικό μοντέλο.
Ενώ οι περιορισμοί των benchmarks αναπόφευκτα επηρεάζουν την τελική βαθμολογία, η ανάλυσή μας υποδηλώνει ότι περαιτέρω βελτιώσεις στη διαχείριση και την επικύρωση περιβάλλοντος θα μπορούσαν να ωθήσουν το σύστημα πέρα από το όριο ακρίβειας εκτέλεσης 90%.
Κοιτάζοντας μπροστά
Το Spider 1.0 παρείχε μια σημαντική βάση για την αξιολόγηση του Data Agent μας, αλλά αντιπροσωπεύει μόνο το πρώτο βήμα προς μια επιχειρηματική Τεχνητή Νοημοσύνη έτοιμη για παραγωγή.
Η επόμενη εστίασή μας είναι να αξιολογήσουμε την αρχιτεκτονική σε πιο απαιτητικά benchmarks όπως το Spider 2.0 και, το πιο σημαντικό, σε πραγματικές εταιρικές βάσεις δεδομένων όπου τα σχήματα είναι σημαντικά μεγαλύτερα, η τεκμηρίωση είναι συχνά ελλιπής και τα επιχειρηματικά ερωτήματα είναι πολύ πιο περίπλοκα.
Στόχος μας δεν είναι απλώς να δημιουργήσουμε ένα ακόμη σύστημα μετατροπής κειμένου σε SQL. Δημιουργούμε έξυπνους πράκτορες δεδομένων που συνδυάζουν την ανάκτηση, τη συλλογιστική, την επικύρωση και την επεξήγηση, για να βοηθήσουν τους οργανισμούς να αλληλεπιδρούν με τα εταιρικά δεδομένα με φυσικό και αξιόπιστο τρόπο.
Αναφορές
[1] Saumya Chaturvedi, Aman Chadha, Laurent Bindschaedler arXiv. «SQL-of-Thought: Πολυπρακτορική μετατροπή κειμένου σε SQL με καθοδηγούμενη διόρθωση σφαλμάτων». arXiv. Ιούνιος 2026 https://arxiv.org/abs/2509.00581
[2] Dawei Gao, Haibin Wang, Yaliang Li, Xiuyu Sun, Yichen Qian, Bolin Ding, Jingren Zhou “Text-to-SQL Empowered by Large Language Models: A Benchmark Evaluation” arXiv. Ιούνιος 2026