Creación de un sistema de conversión de texto a SQL listo para producción: Logrando un 88.15 % en Spider 1.0
Fecha de publicación
13 de julio de 2026
Compartir
Resumen Ejecutivo
Crear un sistema de conversión de texto a SQL listo para producción requiere mucho más que generar SQL con un modelo de lenguaje extenso. Las aplicaciones empresariales exigen una comprensión precisa del esquema, recuperación de contexto, validación y corrección de errores para obtener resultados fiables en bases de datos desconocidas.
En este estudio, comparamos el rendimiento de nuestro Agente de Datos en Spider 1.0 y logramos una precisión de ejecución del 88.15 % utilizando el modelo Gemma 4 26B . En lugar de centrarnos únicamente en las puntuaciones de referencia, este artículo comparte las decisiones arquitectónicas, las lecciones de ingeniería y las conclusiones de las pruebas de rendimiento que respaldan estos resultados.
Más allá de la generación SQL
Los modelos de lenguaje de gran tamaño han mejorado significativamente la generación de SQL, pero la creación de un sistema de conversión de texto a SQL listo para producción requiere mucho más que simplemente traducir el lenguaje natural a SQL. Las aplicaciones empresariales deben comprender esquemas de bases de datos complejos, recuperar el contexto adecuado, validar las consultas generadas y producir resultados fiables en bases de datos que nunca antes han visto.
Para evaluar estas capacidades, realizamos pruebas comparativas con nuestro Data Agent en Spider 1.0, la herramienta de evaluación comparativa de conversión de texto a SQL más utilizada. Con el modelo Gemma 4 26B , nuestro sistema alcanzó una precisión de ejecución del 88.15 % , lo que demuestra que la arquitectura y la gestión del contexto son tan importantes como la selección del modelo.
¿Por qué Spider 1.0?
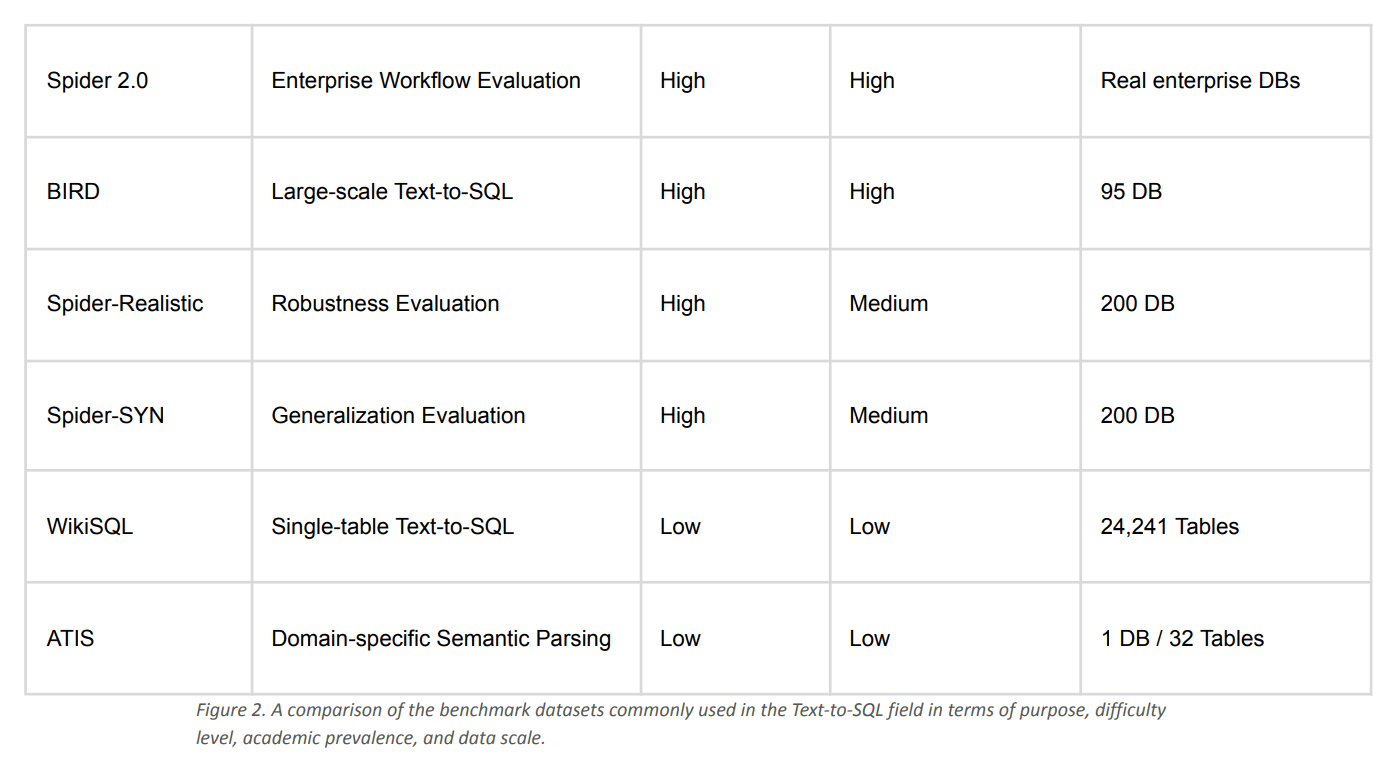
Elegir el referente adecuado es tan importante como elegir el modelo adecuado. Si bien los conjuntos de datos más recientes, como Spider 2.0 y BIRD, presentan escenarios empresariales más complejos, Spider 1.0 sigue siendo el referente más utilizado para evaluar sistemas de conversión de texto a SQL y comparar resultados en la literatura especializada.
Para nuestra evaluación inicial, seleccionamos Spider 1.0 porque proporciona una base de referencia estandarizada y bien establecida. Nos permite medir la eficacia con la que nuestro Agente de Datos comprende esquemas de bases de datos desconocidos y genera SQL correcto en condiciones realistas.
La figura 2 resume cómo se compara Spider 1.0 con otros benchmarks de texto a SQL de uso común.
Creación del agente de datos
Lograr una alta precisión en la conversión de texto a SQL no se reduce simplemente a usar un modelo de lenguaje más extenso. Durante nuestro proceso de evaluación comparativa, descubrimos que la arquitectura y la gestión del contexto tenían un mayor impacto en el rendimiento que la selección del modelo por sí sola.
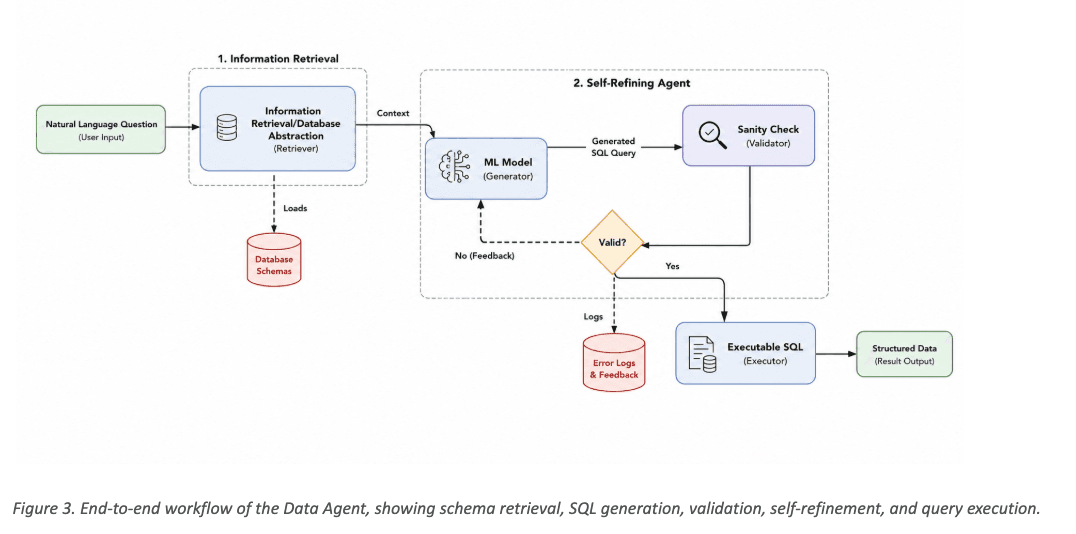
Nuestro agente de datos está diseñado como un proceso multietapa que reduce progresivamente el problema antes de solicitar al LLM que genere SQL. En lugar de exponer todo el esquema de la base de datos al modelo, el sistema primero recupera solo el esquema relevante y la información contextual, luego genera una consulta SQL, valida el resultado y corrige automáticamente los errores comunes antes de la ejecución.
Como se ilustra en la Figura 3 , la arquitectura consta de tres etapas principales:
Recuperación de información – Se analiza la pregunta del usuario para identificar los objetos relevantes de la base de datos y solo se recupera la información de esquema necesaria del almacén de metadatos.
Agente autorrefinador – El modelo de lenguaje genera código SQL, valida la consulta con respecto al esquema recuperado y la refina automáticamente cuando falla la validación.
Ejecución y respuesta Una vez validada, la consulta SQL se ejecuta en la base de datos de destino y los resultados se devuelven como datos estructurados o como respuesta en lenguaje natural.
Esta arquitectura orientada a la producción se inspira en ideas introducidas en DIN-SQL y DAIL-SQL , al tiempo que se adapta a entornos empresariales donde la fiabilidad, la explicabilidad y la robustez son tan importantes como la precisión de referencia.
Nuestro camino hacia la evaluación comparativa
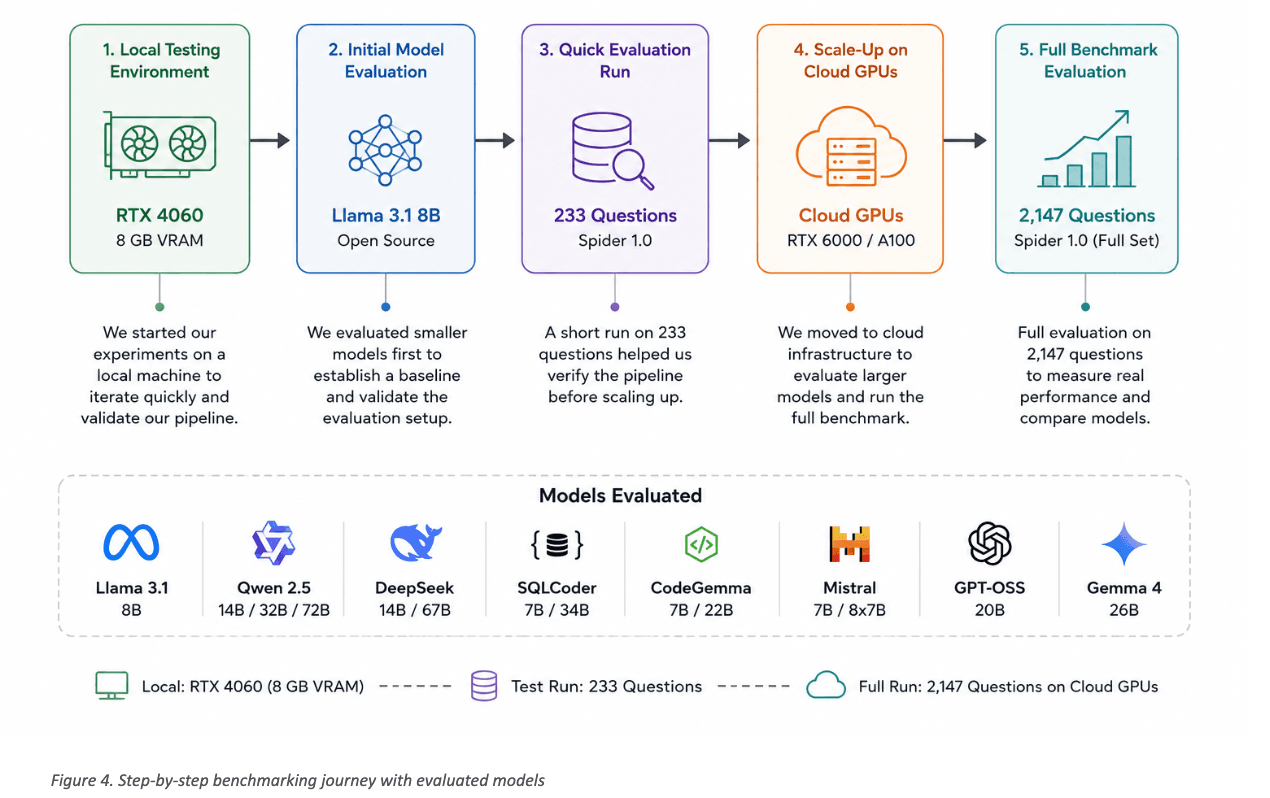
Seleccionar el modelo de lenguaje adecuado fue una parte importante de nuestro proceso de evaluación comparativa. En lugar de evaluar un solo modelo, experimentamos con una amplia gama de modelos de lenguaje de código abierto, incluidos Llama 3.1, Qwen 2.5, DeepSeek, SQLCoder, CodeGemma, Mistral, GPT-OSS y Gemma 4.
Para garantizar una comparación justa, evaluamos cada modelo utilizando la Precisión de Ejecución (EA) , la métrica estándar para la evaluación comparativa de Text-to-SQL. A diferencia de las métricas basadas en la sintaxis, la Precisión de Ejecución mide si el SQL generado devuelve el mismo resultado que la consulta de referencia, lo que la convierte en un mejor indicador del rendimiento en situaciones reales.
Nuestro proceso de evaluación comparativa se ilustra en la Figura 4. Comenzamos experimentando en una estación de trabajo local equipada con una RTX 4060 (8 GB de VRAM) , donde los modelos más pequeños nos permitieron iterar rápidamente y validar nuestro flujo de trabajo. Tras establecer una base estable utilizando un subconjunto de 233 preguntas de Spider 1.0, pasamos a las GPU en la nube para evaluar modelos más grandes en el conjunto completo de 2,147 preguntas . Este enfoque gradual nos permitió optimizar la arquitectura de manera eficiente antes de invertir en ejecuciones de evaluación comparativa a gran escala.
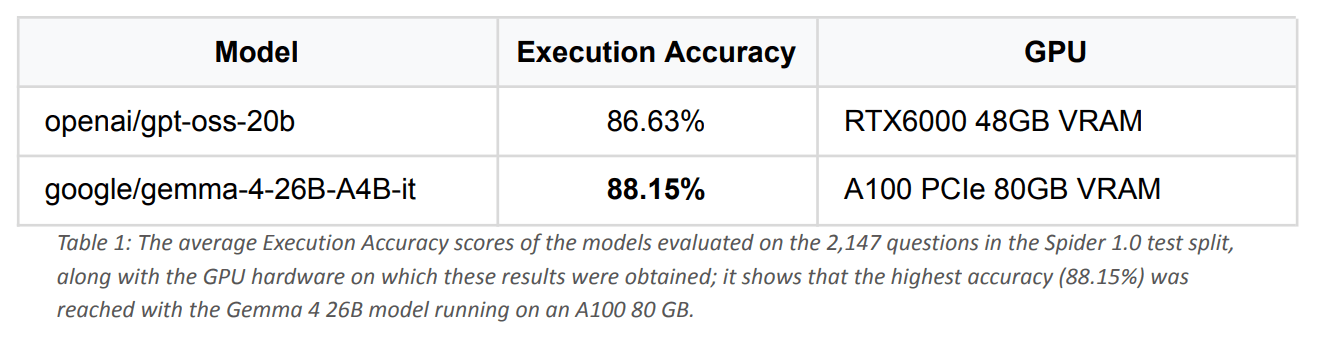
Evaluamos los modelos finales en la prueba completa de Spider 1.0, que consta de 2,147 preguntas. Como se muestra en la Tabla 1, Gemma 4 26B obtuvo la puntuación más alta (88.15 %), seguida de GPT-OSS 20B (86.63 %). Estos resultados demuestran que los modelos LLM de código abierto modernos, combinados con un sistema eficaz de recuperación y validación, pueden lograr un rendimiento de conversión de texto a SQL altamente competitivo.
¿Cómo se comparan estos resultados?
Las puntuaciones de referencia solo son significativas cuando se pueden comparar con trabajos publicados anteriormente. Para comprender mejor la importancia de nuestros resultados, revisamos tanto estudios recientes sobre conversión de texto a SQL como artículos de referencia ampliamente citados.
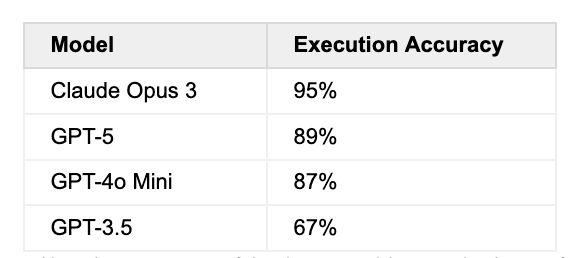
Tabla 2: Tasas de precisión de los modelos de código cerrado reportados en el estudio SQL-of-Thought sobre un subconjunto del conjunto de datos Spider; muestra, en términos comparativos, que el resultado del 88.15% obtenido en este trabajo se sitúa por encima de GPT-4o Mini (87%) y en un nivel cercano a GPT-5 (89%).
Trabajos recientes como SQL-of-Thought [1] indican que los principales modelos de código cerrado —incluidos Claude Opus 3, GPT-5 y GPT-4o Mini— alcanzan una alta precisión en subconjuntos de referencia de Spider. Si bien las comparaciones directas deben interpretarse con cautela debido a las diferencias en la configuración de evaluación, las indicaciones y los subconjuntos de referencia, nuestra precisión de ejecución del 88.15 % demuestra que los modelos de código abierto pueden lograr un rendimiento dentro del mismo rango competitivo.
Si bien estos resultados provienen de diferentes entornos de evaluación y no deben compararse directamente, proporcionan un contexto útil para comprender el panorama actual del rendimiento de los sistemas de conversión de texto a SQL. Nuestra prueba comparativa demuestra que los modelos de código abierto pueden competir con las principales alternativas de código cerrado cuando se combinan con una arquitectura bien diseñada.
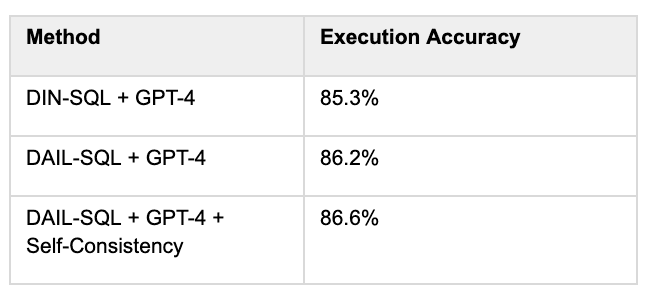
También comparamos nuestros resultados con marcos de trabajo de texto a SQL orientados a la producción, como DIN-SQL [3] y DAIL-SQL , que combinan grandes modelos de lenguaje con técnicas que incluyen la vinculación de esquemas, la ingeniería de indicaciones, la autoconsistencia y la corrección de errores.
Tabla 3: Resultados de precisión de ejecución de diferentes métodos en Spider 1.0 en el estudio "Text-to-SQL potenciado por grandes modelos de lenguaje: una evaluación comparativa" [2]; revela el impacto en la precisión no solo de la selección del modelo sino también de técnicas como la ingeniería de indicaciones, la vinculación de esquemas y la autoconsistencia.
Nuestros hallazgos refuerzan una conclusión común en la literatura reciente: el alto rendimiento de la conversión de texto a SQL depende no solo del modelo de lenguaje, sino también de la arquitectura circundante. La recuperación eficaz del esquema, la gestión del contexto, la validación y la autocorrección suelen ser tan importantes como el propio modelo.
Lo que aprendimos
La evaluación comparativa no solo consiste en medir la precisión, sino también en comprender dónde y por qué falla un sistema. A lo largo de nuestra evaluación, analizamos las predicciones incorrectas e identificamos varios patrones recurrentes que afectaron las puntuaciones finales.
Algunos errores se originaron en la propia prueba de rendimiento. En algunos casos, las inconsistencias en las consultas SQL de referencia provocaron que predicciones lógicamente correctas se marcaran como incorrectas. Otros casos involucraron preguntas ambiguas en lenguaje natural o situaciones de desempate, donde varias consultas SQL podían producir legítimamente respuestas igualmente válidas.
También observamos varios comportamientos específicos del modelo, como conversiones de tipo innecesarias, manejo inconsistente de la distinción entre mayúsculas y minúsculas, y una complicación excesiva, en ocasiones, de consultas SQL sencillas. Estos hallazgos reforzaron la importancia de incorporar mecanismos de validación y autocorrección en el flujo de trabajo del Agente de Datos.
En general, nuestro análisis demostró que muchos de los errores restantes no se debían a limitaciones del modelo de lenguaje en sí, sino a ambigüedades en la evaluación comparativa o a casos límite en la generación de SQL. Esto sugiere que futuras mejoras en la recuperación, la validación y la gestión del contexto podrían llevar al sistema más allá del umbral de precisión de ejecución del 90 %.
Costo y Eficiencia
La alta precisión es solo uno de los aspectos de un sistema de conversión de texto a SQL listo para producción. En entornos empresariales, el costo de la infraestructura, la privacidad de los datos y la flexibilidad de implementación son consideraciones igualmente importantes.
Una de las principales ventajas de nuestro enfoque es que se basa completamente en modelos de lenguaje de código abierto. Durante todo el proceso de desarrollo, pudimos realizar la mayoría de los experimentos localmente utilizando una RTX 4060 de consumo (8 GB de VRAM) , lo que nos permitió iterar rápidamente sin incurrir en costos de API ni tokens. Las pruebas de rendimiento más exigentes se ejecutaron en GPU dedicadas en la nube solo después de que la arquitectura fue validada.
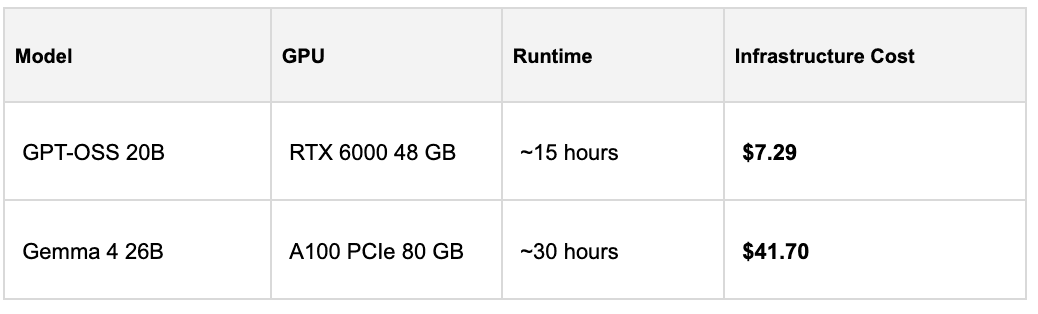
Para la evaluación completa de Spider 1.0, utilizamos RunPod Secure Cloud. La prueba de rendimiento Gemma 4 de 26 bits se ejecutó en una GPU A100 PCIe de 80 GB, mientras que GPT-OSS de 20 bits se ejecutó en una GPU RTX 6000 de 48 GB.
Los costos de infraestructura se resumen en la Tabla 4.
Si bien las pruebas de referencia más exigentes requirieron infraestructura en la nube, el proceso de desarrollo general se mantuvo rentable gracias a la experimentación local y los modelos de código abierto. Más importante aún, la arquitectura resultante puede implementarse completamente dentro de la infraestructura de la propia organización, eliminando la dependencia de API externas y brindando un mayor control sobre la privacidad de los datos, el cumplimiento normativo y los costos operativos.
Esto hace que la arquitectura sea especialmente adecuada para organizaciones que operan en entornos sensibles a la privacidad, regulados o aislados de la red, donde la seguridad de los datos y la flexibilidad de implementación son requisitos fundamentales.
Más allá de Spider 1.0
Los benchmarks ofrecen una forma objetiva de evaluar los sistemas de IA, pero no son el objetivo final. Una puntuación alta en un benchmark solo es valiosa si se traduce en un rendimiento fiable en aplicaciones del mundo real.
A lo largo de este estudio, descubrimos que construir un sistema de conversión de texto a SQL listo para producción implica mucho más que simplemente generar SQL. Comprender los esquemas de la base de datos, recuperar el contexto adecuado, validar las consultas generadas y corregir los resultados incorrectos resultó ser tan importante como el propio modelo de lenguaje.
Nuestra precisión de ejecución del 88.15 % en Spider 1.0 demuestra que los modelos de código abierto, combinados con una arquitectura bien diseñada, pueden ofrecer un rendimiento altamente competitivo para tareas de conversión de texto a SQL en entornos empresariales. Y lo que es más importante, valida los principios de diseño de nuestro Agente de Datos , que se creó para operar de forma fiable en bases de datos empresariales complejas, en lugar de limitarse a conjuntos de datos de referencia.
Spider 1.0 representa un hito importante, pero es solo el comienzo de nuestro camino. Nuestros próximos pasos incluyen la evaluación del Agente de Datos en Spider 2.0 , pruebas comparativas a escala empresarial y, lo que es más importante, entornos reales de clientes donde los esquemas de bases de datos son significativamente mayores y las preguntas de negocio son mucho más complejas.
Nuestra visión a largo plazo no se limita a crear un mejor generador de SQL. Nuestro objetivo es desarrollar agentes de datos inteligentes que permitan a las organizaciones interactuar con los datos empresariales con la misma naturalidad con la que se comunican con un compañero, combinando recuperación, razonamiento, validación e inteligencia artificial explicable en una plataforma fiable de apoyo a la toma de decisiones.
Lecciones clave
La evaluación comparativa no se trata solo de medir la precisión, sino de comprender por qué un sistema tiene éxito o fracasa.
Durante nuestra evaluación, identificamos varios patrones de error recurrentes. Algunos se originaron por ambigüedades en el propio benchmark, como inconsistencias en las consultas SQL de referencia y condiciones de ordenación insuficientemente especificadas. Otros reflejaban comportamientos comunes de LLM, como conversiones de tipo innecesarias o un manejo inconsistente de valores que distinguen entre mayúsculas y minúsculas.
Estas observaciones reforzaron una de las conclusiones centrales de nuestro trabajo: la arquitectura es tan importante como la selección del modelo. La recuperación, la vinculación de esquemas, la validación y la autocorrección contribuyeron al rendimiento final en la misma medida que el modelo de lenguaje subyacente.
Si bien las limitaciones de los puntos de referencia afectan inevitablemente la puntuación final, nuestro análisis sugiere que nuevas mejoras en la gestión del contexto y la validación podrían llevar al sistema más allá del 90 % de precisión de ejecución.
Mirando hacia el futuro
Spider 1.0 proporcionó una base importante para evaluar nuestro Agente de Datos, pero representa solo el primer paso hacia una IA empresarial lista para la producción.
Nuestro siguiente objetivo es evaluar la arquitectura en pruebas de rendimiento más exigentes, como Spider 2.0 , y, lo que es más importante, en bases de datos empresariales reales, donde los esquemas son significativamente más grandes, la documentación suele ser incompleta y las cuestiones empresariales son mucho más complejas.
Nuestro objetivo no es simplemente crear otro sistema de conversión de texto a SQL. Estamos creando agentes de datos inteligentes que combinan recuperación, razonamiento, validación y explicabilidad para ayudar a las organizaciones a interactuar con los datos empresariales de forma natural y fiable.
Referencias
[1] Saumya Chaturvedi, Aman Chadha, Laurent Bindschaedler arXiv. “SQL-of-Thought: Multi-agentic Text-to-SQL with Guided Error Correction.” arXiv. Junio de 2026 https://arxiv.org/abs/2509.00581
[2] Dawei Gao, Haibin Wang, Yaliang Li, Xiuyu Sun, Yichen Qian, Bolin Ding, Jingren Zhou “Texto a SQL potenciado por modelos de lenguaje grandes: una evaluación comparativa” arXiv. junio 2026