• Julkaisupäivä
    Heinäkuu 13, 2026
  • Jaa:
Ekran Resmi 2026-07-10 15.13.39.png

Tiivistelmä

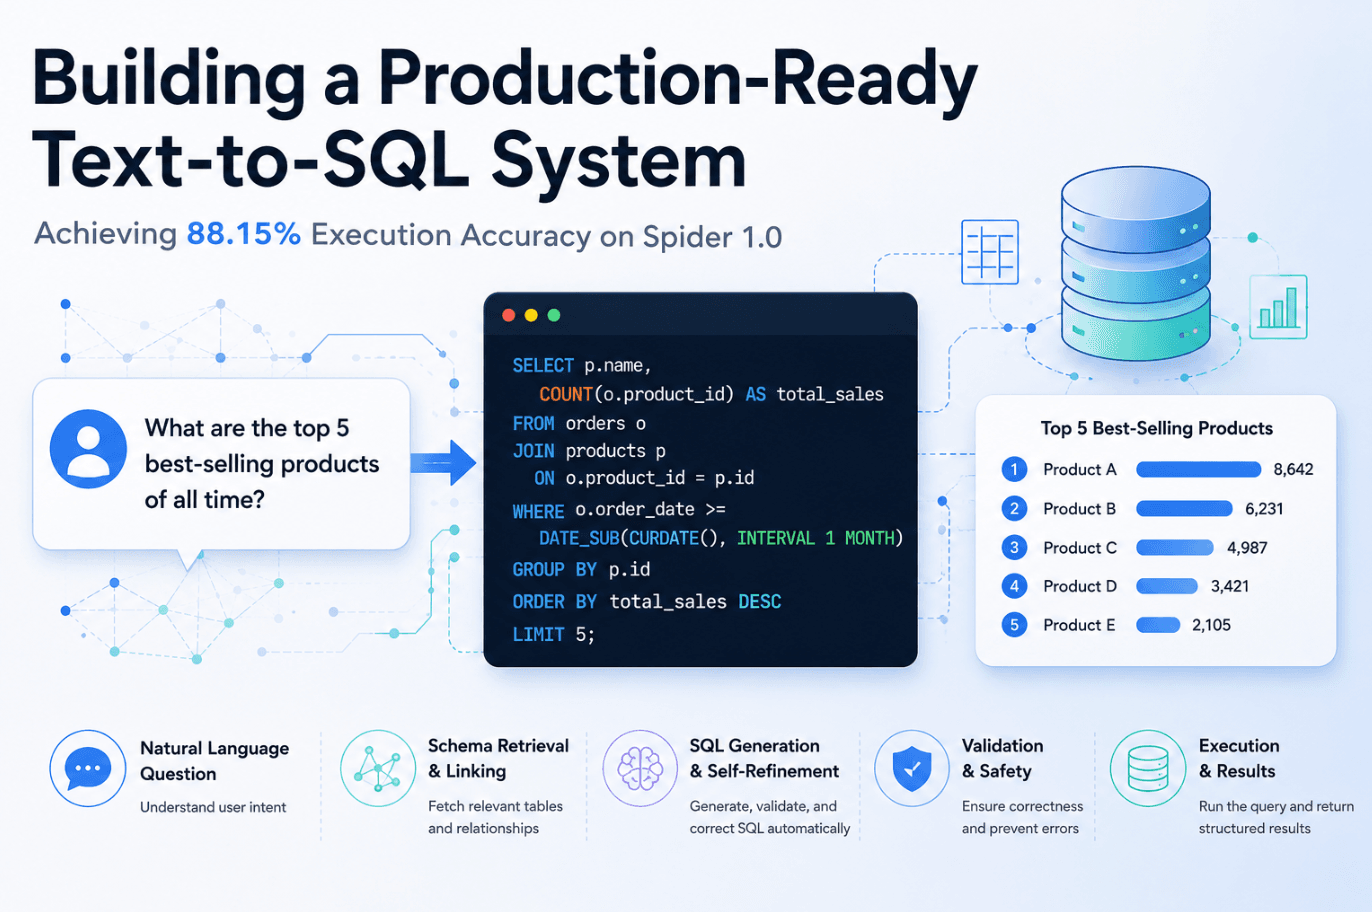
Tuotantovalmiin tekstistä SQL:ään -järjestelmän rakentaminen vaatii paljon enemmän kuin SQL:n luomista laajalla kielimallilla. Yrityssovellukset vaativat tarkkaa skeeman ymmärtämistä, kontekstin hakua, validointia ja virheenkorjausta tuottaakseen luotettavia tuloksia aiemmin näkemättömissä tietokannoissa.

Tässä tutkimuksessa vertailimme data-agenttiamme Spider 1.0:lla ja saavutimme 88.15 %:n suoritustarkkuuden Gemma 4 26B -mallilla . Sen sijaan, että keskityttäisiin pelkästään vertailupisteisiin, tässä artikkelissa jaetaan näiden tulosten taustalla olevia arkkitehtuuripäätöksiä, suunnittelun opetuksia ja vertailuanalyysin näkemyksiä.

SQL-sukupolven tuolla puolen

SQL-sukupolven tuolla puolen

Suuret kielimallit ovat parantaneet SQL-generointia merkittävästi, mutta tuotantovalmiiden tekstistä SQL-muotoon -järjestelmien rakentaminen vaatii paljon enemmän kuin luonnollisen kielen kääntämisen SQL-muotoon. Yrityssovellusten on ymmärrettävä monimutkaisia ​​tietokantakaavoja, haettava oikea konteksti, validoitava luotuja kyselyitä ja tuotettava luotettavia tuloksia tietokannoista, joita ne eivät ole aiemmin nähneet.

Näiden ominaisuuksien arvioimiseksi testasimme Data Agenttiamme Spider 1.0:lla, joka on eniten käytetty tekstistä SQL:ään -vertailuarvo. Gemma 4 26B -mallia käyttäen järjestelmämme saavutti 88.15 %:n suoritustarkkuuden , mikä osoittaa, että arkkitehtuurin ja kontekstin hallinta ovat aivan yhtä tärkeitä kuin mallin valinta.

Miksi Hämähäkki 1.0?

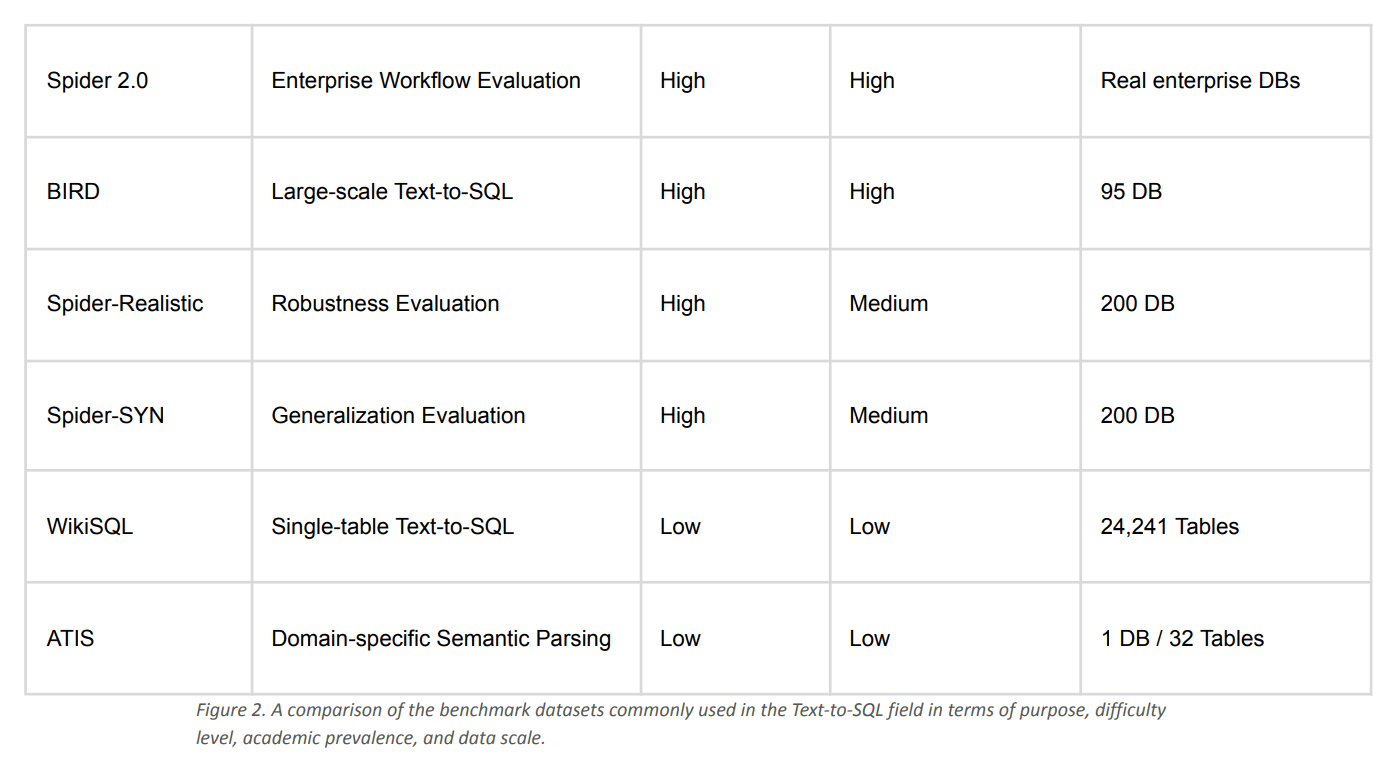
Oikean vertailuarvon valitseminen on aivan yhtä tärkeää kuin oikean mallin valitseminen. Vaikka uudemmat tietojoukot, kuten Spider 2.0 ja BIRD, esittelevät monimutkaisempia yritysskenaarioita, Spider 1.0 on edelleen laajimmin käytetty vertailuarvo Text-to-SQL-järjestelmien arviointiin ja tulosten vertailuun eri kirjallisuudessa.

Ekran Resmi 2026-07-13 15.13.56.png

Alustavaan arviointiimme valitsimme Spider 1.0:n, koska se tarjoaa standardoidun ja vakiintuneen lähtötason. Sen avulla voimme mitata, kuinka tehokkaasti data-agenttimme ymmärtää aiemmin näkemättömiä tietokantakaavoja ja luo oikean SQL-koodin realistisissa olosuhteissa.

Kuvio 2 esittää yhteenvedon siitä, miten Spider 1.0 vertautuu muihin yleisesti käytettyihin Text-to-SQL-vertailuarvoihin.

Data-agentin rakentaminen

Korkean Text-to-SQL-tarkkuuden saavuttaminen ei ole pelkästään suuremman kielimallin käyttöä. Vertailuanalyysiprosessimme aikana havaitsimme, että arkkitehtuurilla ja kontekstinhallinnalla oli suurempi vaikutus suorituskykyyn kuin pelkällä mallinvalinnalla.

Ekran Resmi 2026-07-10 15.31.28.png

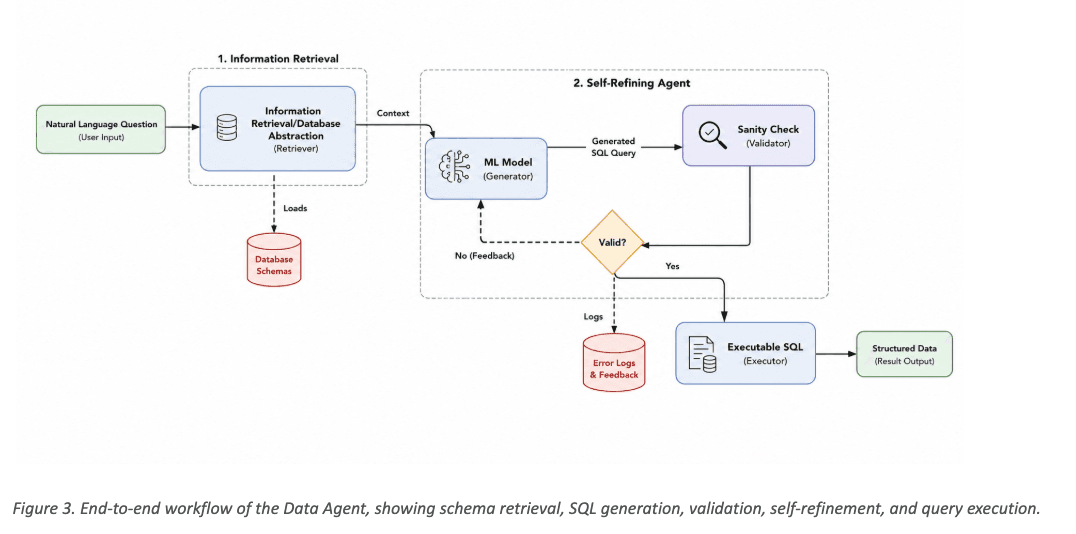
Data-agenttimme on suunniteltu monivaiheiseksi prosessiksi, joka rajaa ongelmaa asteittain ennen kuin pyytää oikeustieteen lisenssin haltijaa luomaan SQL-kyselyn. Sen sijaan, että koko tietokannan kaava näytettäisiin mallille, järjestelmä hakee ensin vain asiaankuuluvan kaavan ja kontekstuaalisen tiedon, luo sitten SQL-kyselyn, validoi tuloksen ja korjaa automaattisesti yleiset virheet ennen suorittamista.

Kuten kuvassa 3 on esitetty , arkkitehtuuri koostuu kolmesta päävaiheesta:

  • Tiedonhaku – Käyttäjän kysymys analysoidaan asiaankuuluvien tietokantaobjektien tunnistamiseksi, ja metatietosäilöstä noudetaan vain tarvittavat skeematiedot.
  • Itsepuhdistuva aine – Kielimalli luo SQL-kyselyn, validoi kyselyn noudettua skeemaa vasten ja tarkentaa sitä automaattisesti, jos validointi epäonnistuu.
  • Toteutus ja vastaus – Kun SQL-kysely on validoitu, se suoritetaan kohdetietokantaa vasten, ja tulokset palautetaan strukturoituna datana tai luonnollisella kielellä kirjoitetuna vastauksena.

Tämä tuotantoon suuntautunut arkkitehtuuri on saanut inspiraationsa DIN-SQL: ssä ja DAIL-SQL: ssä esitellyistä ideoista , ja sitä on mukautettu yritysympäristöihin, joissa luotettavuus, selitettävyys ja vankkuus ovat yhtä tärkeitä kuin vertailuarvojen tarkkuus.

Vertailuanalyysimme

Ekran Resmi 2026-07-10 15.32.47.png

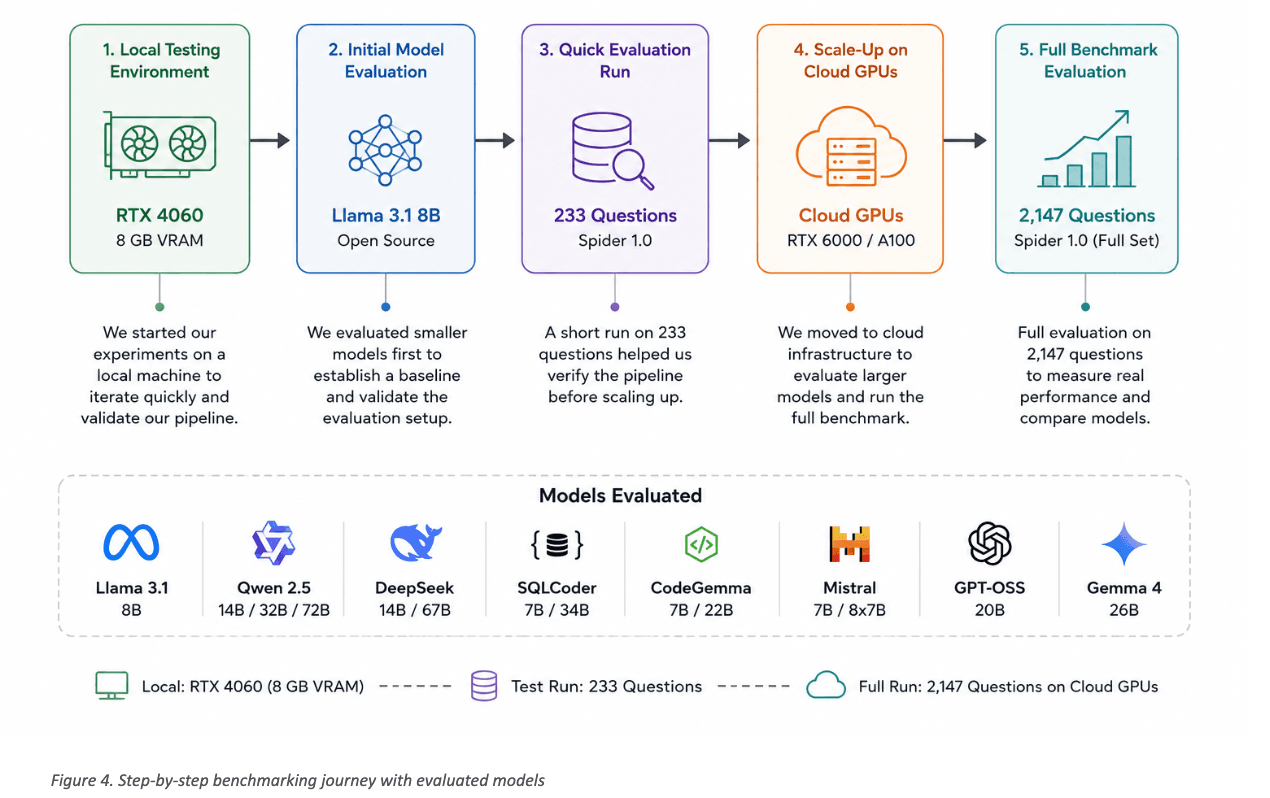
Oikean kielimallin valinta oli tärkeä osa benchmark-analyysiprosessiamme. Yhden mallin arvioinnin sijaan kokeilimme laajaa valikoimaa avoimen lähdekoodin LLM-järjestelmiä, kuten Llama 3.1, Qwen 2.5, DeepSeek, SQLCoder, CodeGemma, Mistral, GPT-OSS ja Gemma 4.

Jotta vertailu olisi tasapuolinen, arvioimme jokaisen mallin käyttäen Execution Accuracy (EA) -mittausta, joka on Text-to-SQL-vertailuanalyysin vakiomittari. Toisin kuin syntaksipohjaiset mittarit, Execution Accuracy mittaa, palauttaako luotu SQL saman tuloksen kuin referenssikysely, mikä tekee siitä paremman indikaattorin todellisesta suorituskyvystä.

Vertailuanalyysiprosessimme on havainnollistettu kuvassa 4. Aloitimme kokeilemalla paikallisella työasemalla, jossa oli RTX 4060 -näytönohjain (8 Gt VRAM) , jossa pienemmät mallit mahdollistivat nopean iteroinnin ja project-putkemme validoinnin. Kun olimme määrittäneet vakaan lähtötason käyttämällä 233 Spider 1.0 -kysymyksen osajoukkoa, siirryimme pilvipohjaisiin näytönohjaimiin arvioidaksemme suurempia malleja koko 2 147 kysymyksen vertailuanalyysin perusteella. Tämä vaiheittainen lähestymistapa mahdollisti arkkitehtuurin tehokkaan optimoinnin ennen investointeja laajamittaisiin vertailutestauksiin.

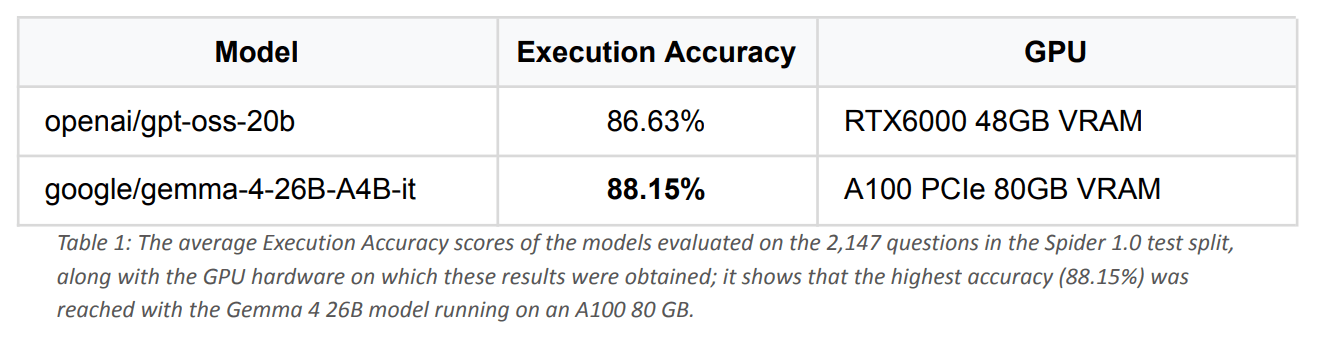
Arvioimme lopulliset mallit Spider 1.0 -testin täydellisellä 2 147 kysymyksen jaolla. Kuten taulukosta 1 käy ilmi, Gemma 4 26B saavutti korkeimman pistemäärän (88.15 %), jota seurasi GPT-OSS 20B (86.63 %). Nämä tulokset osoittavat, että nykyaikaiset avoimen lähdekoodin oikeustieteen maisterit (LLM) voivat yhdistettynä tehokkaaseen haku- ja validointiprosessiin saavuttaa erittäin kilpailukykyisen tekstistä SQL:ksi -suorituskyvyn. 

Ekran Resmi 2026-07-13 15.15.08.png


Miten nämä tulokset vertautuvat?

Vertailuarvosanat ovat merkityksellisiä vain, jos niitä voidaan verrata aiemmin julkaistuihin töihin. Ymmärtääksemme tulostemme merkitystä paremmin, tarkastelimme sekä viimeaikaisia ​​Text-to-SQL-tutkimuksia että laajalti viitattuja vertailuarvopapereita.

Ekran Resmi 2026-07-13 13.07.55.png

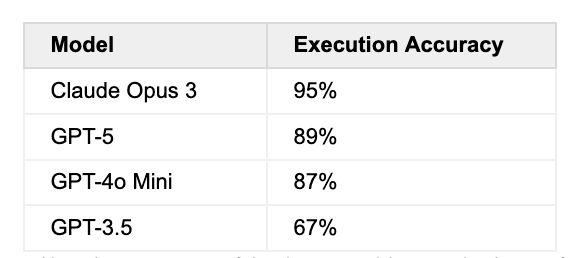
Taulukko 2: SQL-of-Thought-tutkimuksessa raportoitujen suljetun lähdekoodin mallien tarkkuusasteet Spider-aineiston osajoukolla; taulukko osoittaa vertailussa, että tässä työssä saatu 88.15 %:n tulos on GPT-4o Minin (87 %) yläpuolella ja lähellä GPT-5:n (89 %) tasoa.

Viimeaikaiset tutkimukset, kuten SQL-of-Thought [1], raportoivat, että johtavat suljetun lähdekoodin mallit – mukaan lukien Claude Opus 3, GPT-5 ja GPT-4o Mini – saavuttavat korkean tarkkuuden Spiderin vertailuarvojen osajoukoissa. Vaikka suoria vertailuja tulisi tulkita varoen arviointiasetusten, kehotteiden ja vertailuarvojen osajoukkojen erojen vuoksi, 88.15 %:n suoritustarkkuutemme osoittaa, että avoimen lähdekoodin mallit voivat saavuttaa suorituskyvyn samalla kilpailukykyisellä alueella.

Vaikka nämä tulokset ovat peräisin eri arviointiympäristöistä eikä niitä pitäisi verrata suoraan, ne tarjoavat hyödyllistä kontekstia Text-to-SQL-järjestelmien nykyisen suorituskykytilanteen ymmärtämiseksi. Vertailuanalyysimme osoittaa, että avoimen lähdekoodin mallit voivat nyt kilpailla johtavien suljetun lähdekoodin vaihtoehtojen kanssa, kun ne yhdistetään hyvin suunniteltuun arkkitehtuuriin.

Ekran Resmi 2026-07-13 15.17.45.png

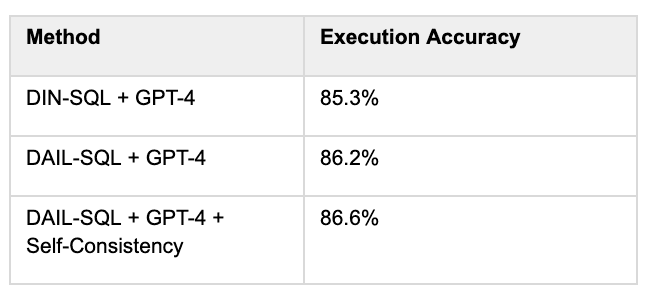
Vertailimme tuloksiamme myös tuotantoon suuntautuneisiin Text-to-SQL-kehyksiin, kuten DIN-SQL:ään [3] ja DAIL-SQ L:ään, jotka yhdistävät laajoja kielimalleja tekniikoihin, kuten skeemalinkitykseen, prompt engineeringiin, itsejohdonmukaisuuteen ja virheenkorjaukseen.

Ekran Resmi 2026-07-13 13.10.44.png

Taulukko 3: Eri menetelmien suoritustarkkuustulokset Spider 1.0:ssa "Text-to-SQL Empowered by Large Language Models: A Benchmark Evaluation" [2] -tutkimuksessa; se paljastaa paitsi mallivalinnan myös sellaisten tekniikoiden kuin kehotesuunnittelun, skeemalinkityksen ja itsekonsistenssin vaikutuksen tarkkuuteen.

Löydöksemme vahvistavat viimeaikaisessa kirjallisuudessa jaettua johtopäätöstä: korkea Text-to-SQL-suorituskyky ei riipu pelkästään kielimallista, vaan myös ympäröivästä arkkitehtuurista. Tehokas skeeman haku, kontekstinhallinta, validointi ja itsekorjaus ovat usein yhtä tärkeitä kuin itse malli.

Mitä opimme

Vertailuanalyysissä ei ole kyse pelkästään tarkkuuden mittaamisesta, vaan myös ymmärryksestä siitä, missä ja miksi järjestelmä epäonnistuu. Arviointimme aikana analysoimme virheellisiä ennusteita ja tunnistimme useita toistuvia malleja, jotka vaikuttivat loppupisteisiin.

Jotkin virheet johtuivat itse vertailutestistä. Muutamassa tapauksessa epäjohdonmukaisuudet referenssi-SQL-kyselyissä johtivat loogisesti oikeiden ennusteiden merkitsemiseen virheellisiksi. Muissa tapauksissa oli kyse epäselvistä luonnollisen kielen kysymyksistä tai tasapelitilanteista, joissa useat SQL-kyselyt saattoivat tuottaa yhtä päteviä vastauksia.

Havaitsimme myös useita mallikohtaisia ​​toimintatapoja, kuten tarpeettomia tyyppimuunnoksia, epäjohdonmukaista kirjainkoon huomioimista ja muuten yksinkertaisten SQL-kyselyiden satunnaista ylimonimutkaisuutta. Nämä havainnot vahvistivat validointi- ja itsekorjausmekanismien sisällyttämisen tärkeyttä Data Agent -prosessiin.

Kaiken kaikkiaan analyysimme osoitti, että monet jäljellä olevat virheet eivät johtuneet itse kielimallin rajoituksista, vaan SQL-generoinnin vertailuarvojen tai reunatapausten epäselvyyksistä. Tämä viittaa siihen, että haun, validoinnin ja kontekstin hallinnan lisäparannukset voisivat nostaa järjestelmän suoritustarkkuuden yli 90 %:n kynnyksen.

Kustannus ja tehokkuus

Korkea tarkkuus on vain yksi osa tuotantovalmiista Text-to-SQL-järjestelmästä. Yritysympäristöissä infrastruktuurikustannukset, tietosuoja ja käyttöönoton joustavuus ovat yhtä tärkeitä huomioitavia seikkoja.

Yksi lähestymistapamme keskeisistä eduista on, että se perustuu kokonaan avoimen lähdekoodin kielimalleihin. Koko kehitysprosessin ajan pystyimme suorittamaan useimmat kokeet paikallisesti käyttämällä kuluttajaluokan RTX 4060 -näytönohjainta (8 Gt VRAM) , mikä mahdollisti nopean iteroinnin ilman API- tai token-kustannuksia. Suuremmat vertailutestit suoritettiin sitten erillisillä pilvipohjaisilla näytönohjaimilla vasta arkkitehtuurin validoinnin jälkeen.

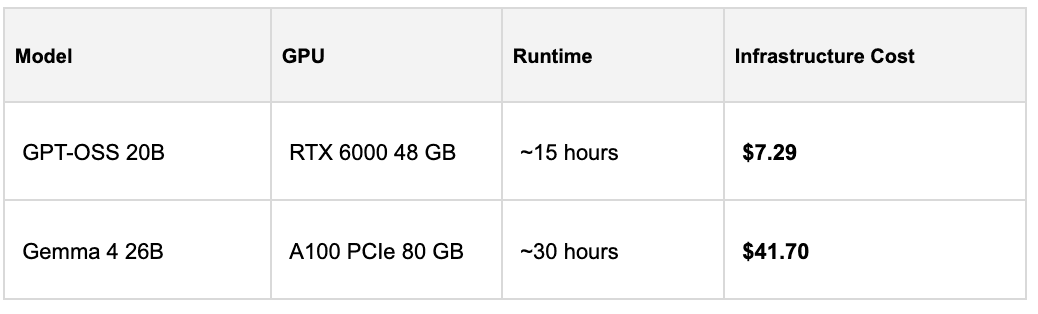
Käytimme RunPod Secure Cloudia Spider 1.0:n täydelliseen arviointiin. Gemma 4 26B -vertailutesti suoritettiin A100 PCIe 80 Gt:n näytönohjaimella, kun taas GPT-OSS 20B suoritettiin RTX 6000 48 Gt:n näytönohjaimella.

Infrastruktuurikustannukset on esitetty yhteenvetona taulukossa 4.

Ekran Resmi 2026-07-13 13.11.54.png

Vaikka suurimmat vertailutestit vaativat pilvi-infrastruktuuria, kokonaiskehitysprosessi pysyi kustannustehokkaana paikallisten kokeilujen ja avoimen lähdekoodin mallien ansiosta. Vielä tärkeämpää on, että tuloksena oleva arkkitehtuuri voidaan ottaa käyttöön kokonaan organisaation omassa infrastruktuurissa, mikä poistaa riippuvuuden ulkoisista API-rajapinnoista ja tarjoaa samalla paremman hallinnan tietosuojaan, vaatimustenmukaisuuteen ja käyttökustannuksiin.

Tämä tekee arkkitehtuurista erityisen sopivan organisaatioille, jotka toimivat yksityisyyttä suojaavissa, säännellyissä tai ilmaraoilla varustetuissa ympäristöissä, joissa tietoturva ja käyttöönoton joustavuus ovat kriittisiä vaatimuksia.

Hämähäkin ulkopuolella 1.0

Vertailuanalyysit tarjoavat objektiivisen tavan arvioida tekoälyjärjestelmiä, mutta ne eivät ole lopullinen tavoite. Korkea vertailuanalyysipistemäärä on arvokas vain, jos se tarkoittaa luotettavaa suorituskykyä tosielämän sovelluksissa.

Tämän tutkimuksen aikana havaitsimme, että tuotantovalmiin Text-to-SQL-järjestelmän rakentaminen on paljon enemmän kuin SQL-koodin luomista. Tietokantamallien ymmärtäminen, oikean kontekstin hakeminen, luotujen kyselyiden validointi ja virheellisten tulosteiden tarkentaminen osoittautuivat aivan yhtä tärkeiksi kuin itse kielimalli.

Spider 1.0:n 88.15 %: n suoritustarkkuus osoittaa, että avoimen lähdekoodin mallit yhdistettynä hyvin suunniteltuun arkkitehtuuriin voivat tarjota erittäin kilpailukykyisen suorituskyvyn yritysten Text-to-SQL-tehtävissä. Mikä tärkeintä, se validoi Data Agenttimme suunnitteluperiaatteet , joka on rakennettu toimimaan luotettavasti monimutkaisissa yritystietokannoissa eikä vain vertailuaineistoissa.

Spider 1.0 on tärkeä virstanpylväs, mutta vasta matkamme alku. Seuraaviin vaiheisiimme kuuluvat Data Agentin arviointi Spider 2.0: ssa , laajemmat yritystason vertailutestit ja ennen kaikkea todelliset asiakasympäristöt, joissa tietokantamallit ovat huomattavasti suurempia ja liiketoimintakysymykset paljon monimutkaisempia.

Pitkän aikavälin visiomme ei ole pelkästään paremman SQL-generaattorin rakentaminen. Tavoitteenamme on rakentaa älykkäitä data-agentteja, joiden avulla organisaatiot voivat olla vuorovaikutuksessa yritysdatan kanssa yhtä luonnollisesti kuin ne kommunikoivat kollegan kanssa – yhdistäen haun, päättelyn, validoinnin ja selitettävän tekoälyn luotettavaksi päätöksenteon tukialustaksi.
Keskeiset oppitunnit

Vertailuanalyysi ei tarkoita pelkästään tarkkuuden mittaamista – se tarkoittaa myös ymmärrystä siitä, miksi järjestelmä onnistuu tai epäonnistuu.

Arviointimme aikana tunnistimme useita toistuvia virhemalleja. Jotkut johtuivat itse vertailuanalyysin epäselvyyksistä, kuten epäjohdonmukaisuuksista referenssi-SQL-kyselyissä ja aliarvostetuista järjestysehdoista. Toiset heijastivat yleisiä LLM-käyttäytymismalleja, kuten tarpeetonta tyypinmuokkausta tai kirjainkoon mukaan erottavien arvojen epäjohdonmukaista käsittelyä.

Nämä havainnot vahvistivat yhtä työmme keskeisistä löydöksistä: arkkitehtuurilla on yhtä paljon merkitystä kuin mallin valinnalla. Haku, skeemojen linkittäminen, validointi ja itsekorjaus vaikuttivat lopulliseen suorituskykyyn aivan yhtä paljon kuin pohjana oleva kielimalli.

Vaikka vertailuarvojen rajoitukset väistämättä vaikuttavat lopulliseen pistemäärään, analyysimme viittaa siihen, että kontekstinhallinnan ja validoinnin lisäparannukset voisivat nostaa järjestelmän yli 90 %:n suoritustarkkuuden rajan.

Katse tulevaisuuteen

Spider 1.0 tarjosi tärkeän lähtökohdan data-agenttimme arvioinnille, mutta se on vasta ensimmäinen askel kohti tuotantovalmista yritystason tekoälyä.

Seuraavaksi keskitymme arvioimaan arkkitehtuuria haastavammissa vertailuissa, kuten Spider 2.0: ssa , ja mikä tärkeämpää, oikeissa yritystietokannoissa, joissa skeemat ovat huomattavasti suurempia, dokumentaatio usein puutteellista ja liiketoimintakysymykset paljon monimutkaisempia.

Tavoitteenamme ei ole vain rakentaa uutta tekstistä SQL:ään -järjestelmää. Rakennamme älykkäitä data-agentteja , jotka yhdistävät haun, päättelyn, validoinnin ja selitettävyyden auttaakseen organisaatioita olemaan vuorovaikutuksessa yritysdatan kanssa luonnollisesti ja luotettavasti.

Ekran Resmi 2026-07-10 15.41.38.png

Viitteet

[1] Saumya Chaturvedi, Aman Chadha, Laurent Bindschaedler, arXiv. ”SQL-of-Thought: Moniagenttinen tekstistä SQL:ksi ohjatulla virheenkorjauksella.” arXiv. Kesäkuu 2026 https://arxiv.org/abs/2509.00581

[2] Dawei Gao, Haibin Wang, Yaliang Li, Xiuyu Sun, Yichen Qian, Bolin Ding, Jingren Zhou "Text-to-SQL Enpowered by Large Language Models: A Benchmark Evaluation" arXiv. Kesäkuu 2026

https://arxiv.org/pdf/2308.15363 

[3] Mohammadreza Pourreza, Davood Rafiei. ”DIN-SQL: Tekstistä SQL:ksi muuntamisen kontekstissa tapahtuva oppiminen itsekorjauksella”, arXiv. Kesäkuu 2026

https://arxiv.org/pdf/2304.11015


Dilşen YILDAR HAVAYLAR, 

Vanhempi ohjelmistoinsinööri, MSc