Les benchmarks offrent une méthode objective d'évaluation des systèmes d'IA, mais ils ne constituent pas une fin en soi. Un score élevé à un benchmark n'a de valeur que s'il se traduit par des performances fiables dans des applications concrètes.
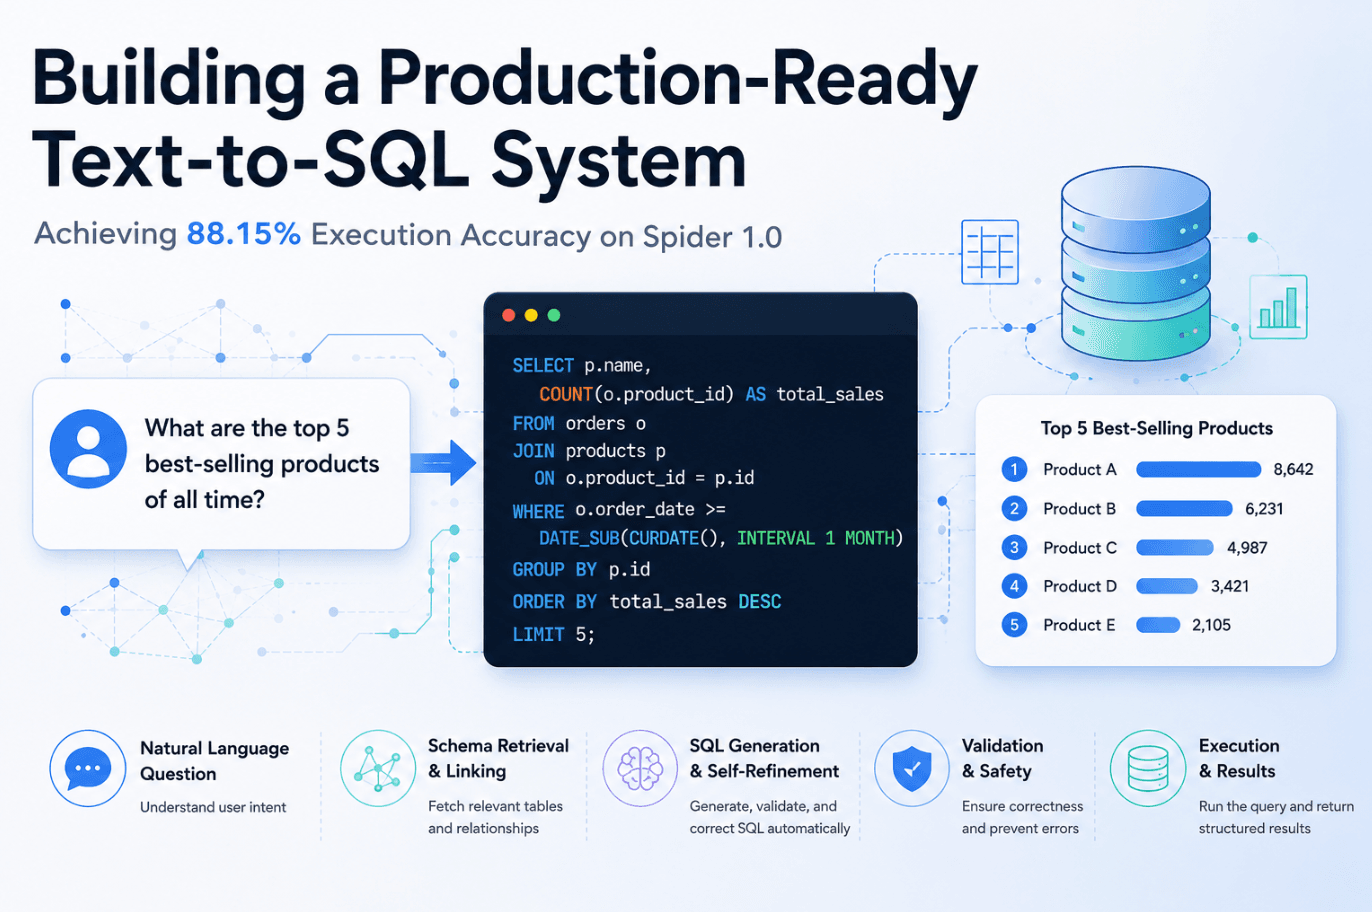
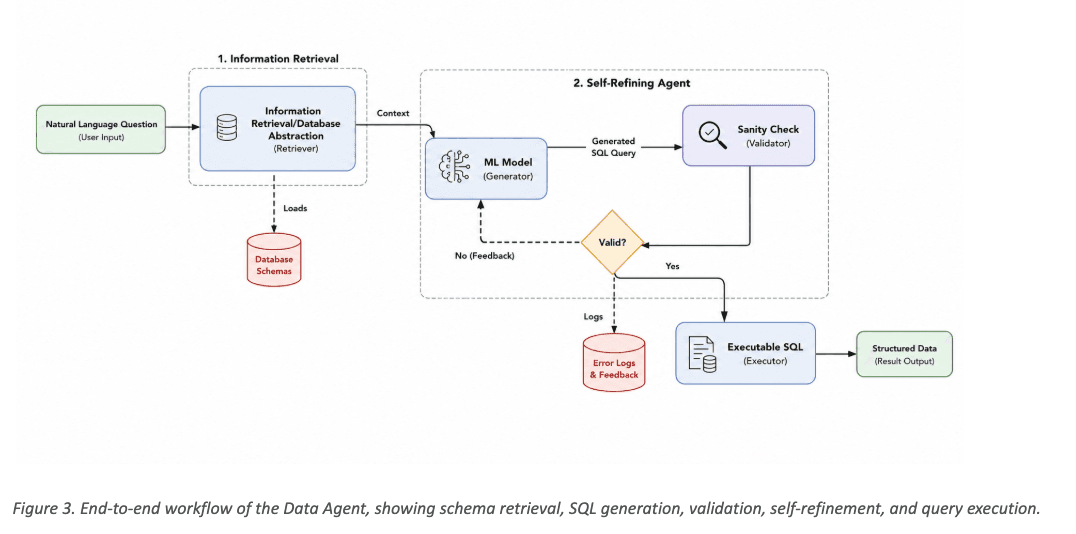
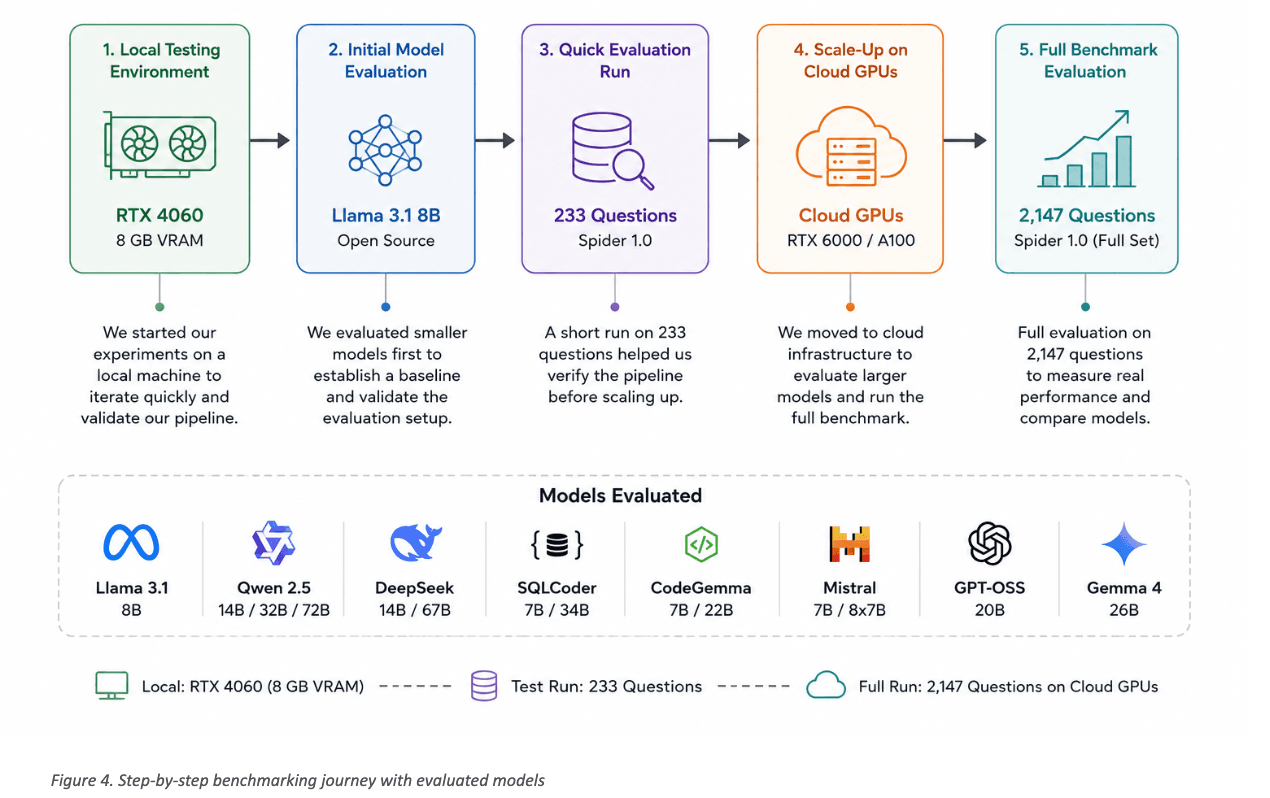
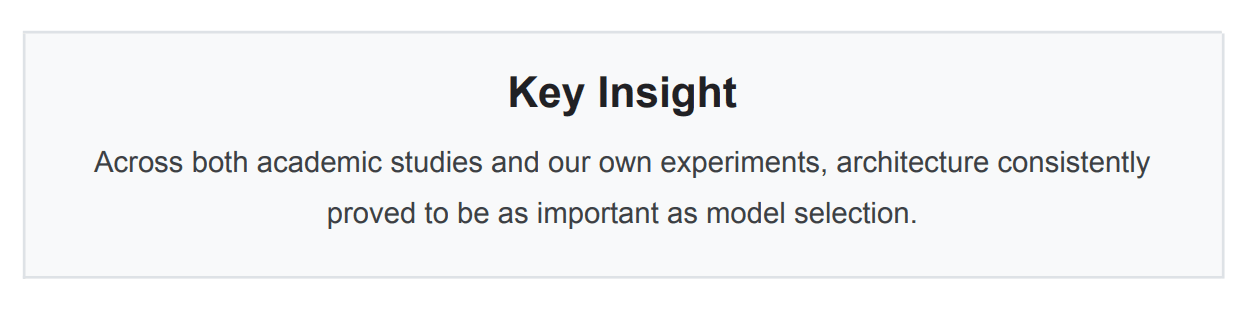
Tout au long de cette étude, nous avons constaté que la création d'un système Text-to-SQL prêt pour la production ne se limite pas à la génération de SQL. La compréhension des schémas de base de données, la récupération du contexte approprié, la validation des requêtes générées et l'amélioration des résultats incorrects se sont avérées tout aussi importantes que le modèle de langage lui-même.
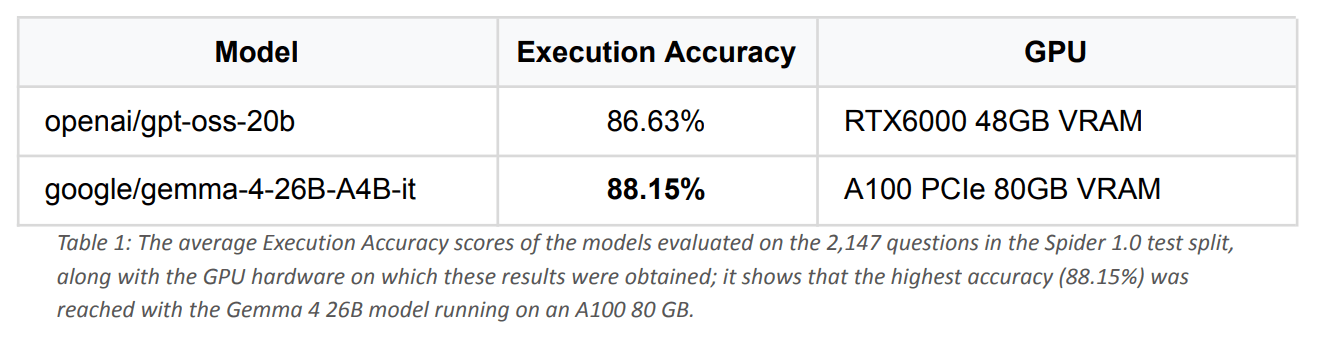
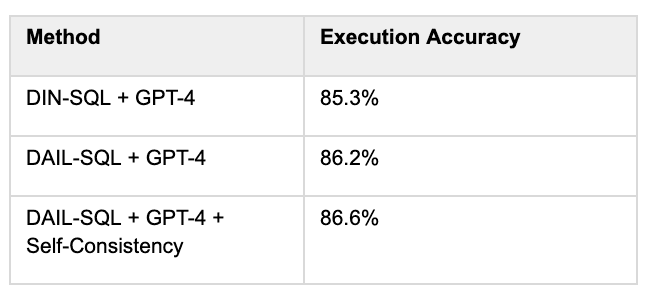
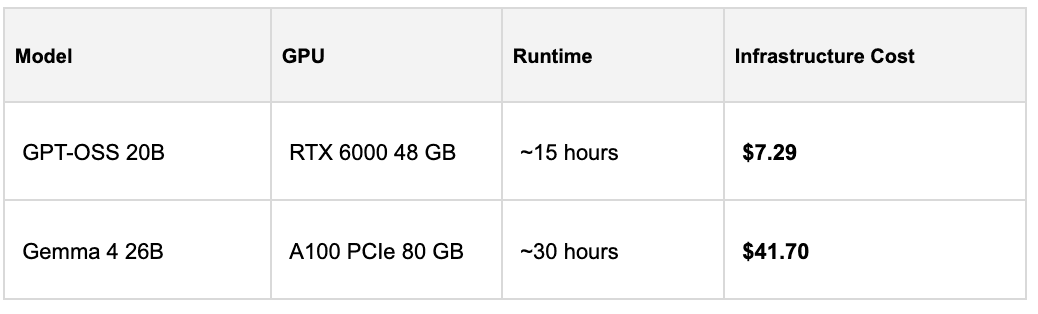
Notre taux de réussite de 88.15 % sur Spider 1.0 démontre que les modèles open source, associés à une architecture bien conçue, peuvent offrir des performances très compétitives pour les tâches de conversion de texte en SQL en entreprise. Plus important encore, ce résultat valide les principes de conception de notre agent de données , conçu pour fonctionner de manière fiable sur des bases de données d'entreprise complexes et non uniquement sur des jeux de données de référence.
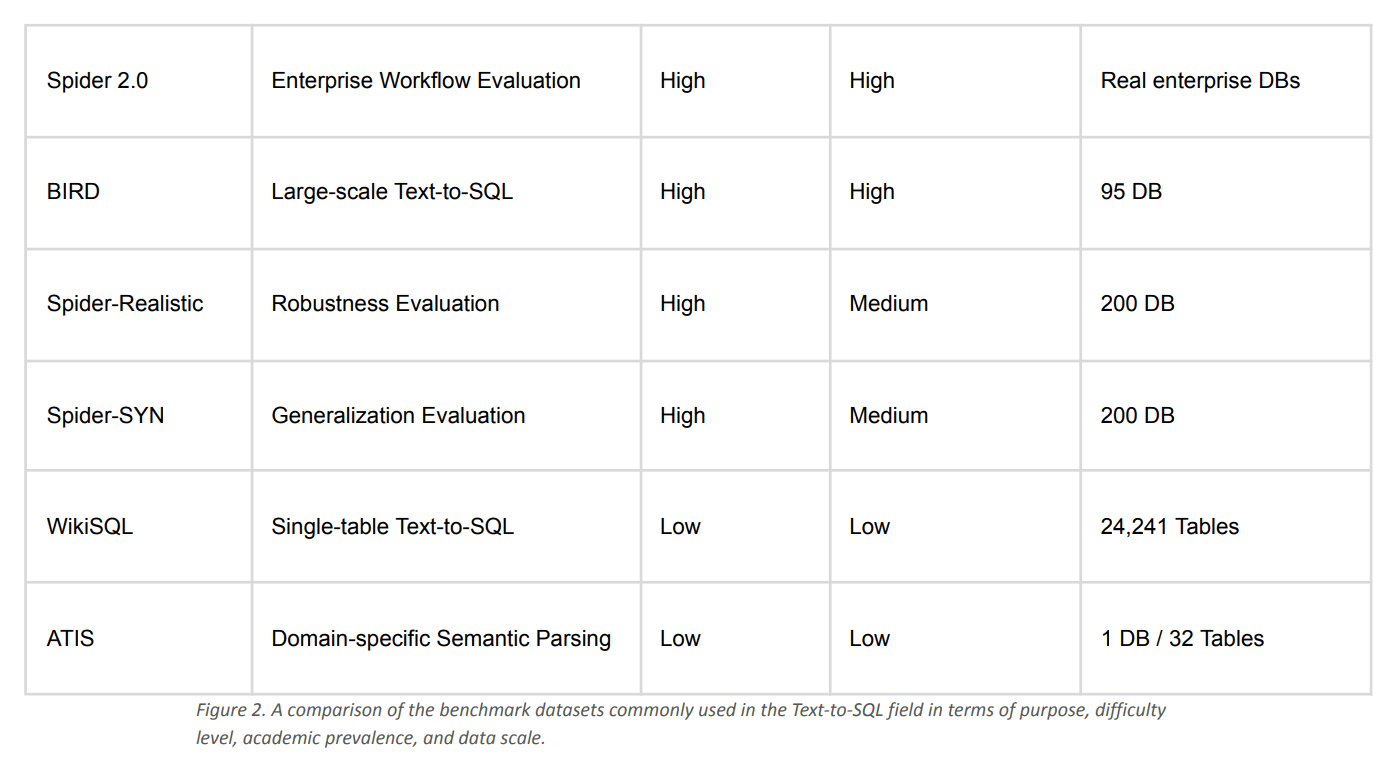
Spider 1.0 représente une étape importante, mais ce n'est que le début de notre aventure. Nos prochaines étapes comprennent l'évaluation de l'agent de données sur Spider 2.0 , des tests de performance à plus grande échelle en entreprise et, surtout, des environnements clients réels où les schémas de bases de données sont considérablement plus volumineux et les problématiques métier bien plus complexes.
Notre vision à long terme ne se limite pas à la création d'un générateur SQL plus performant. Nous ambitionnons de concevoir des agents de données intelligents permettant aux organisations d'interagir avec leurs données d'entreprise aussi naturellement qu'avec un collègue, en combinant extraction, raisonnement, validation et IA explicable au sein d'une plateforme d'aide à la décision fiable.