उत्पादन के लिए तैयार टेक्स्ट-टू-एसक्यूएल सिस्टम का निर्माण: स्पाइडर 1.0 पर 88.15% की उपलब्धि
प्रकाशित तिथि
जुलाई 13, 2026
साझा करें
कार्यकारी सारांश
उत्पादन के लिए तैयार टेक्स्ट-टू-एसक्यूएल सिस्टम बनाने के लिए केवल एक बड़े भाषा मॉडल के साथ एसक्यूएल उत्पन्न करने से कहीं अधिक की आवश्यकता होती है। एंटरप्राइज़ अनुप्रयोगों को पहले से अनदेखे डेटाबेस पर विश्वसनीय परिणाम उत्पन्न करने के लिए सटीक स्कीमा समझ, संदर्भ पुनर्प्राप्ति, सत्यापन और त्रुटि सुधार की आवश्यकता होती है।
इस अध्ययन में, हमने स्पाइडर 1.0 पर अपने डेटा एजेंट का बेंचमार्किंग किया और जेम्मा 4 26B मॉडल का उपयोग करके 88.15% निष्पादन सटीकता प्राप्त की । केवल बेंचमार्क स्कोर पर ध्यान केंद्रित करने के बजाय, यह लेख इन परिणामों के पीछे के आर्किटेक्चरल निर्णयों, इंजीनियरिंग संबंधी सीखों और बेंचमार्किंग संबंधी जानकारियों को साझा करता है।
SQL जनरेशन से परे
बड़े भाषा मॉडलों ने SQL जनरेशन में उल्लेखनीय सुधार किया है, लेकिन उत्पादन के लिए तैयार टेक्स्ट-टू-SQL सिस्टम बनाने के लिए प्राकृतिक भाषा को SQL में अनुवाद करने से कहीं अधिक की आवश्यकता होती है। एंटरप्राइज़ अनुप्रयोगों को जटिल डेटाबेस स्कीमा को समझना, सही संदर्भ प्राप्त करना, उत्पन्न क्वेरी को मान्य करना और उन डेटाबेस पर विश्वसनीय परिणाम उत्पन्न करना आवश्यक है जिन्हें उन्होंने पहले कभी नहीं देखा है।
इन क्षमताओं का मूल्यांकन करने के लिए, हमने अपने डेटा एजेंट का परीक्षण स्पाइडर 1.0 पर किया, जो टेक्स्ट-टू-एसक्यूएल का सबसे व्यापक रूप से उपयोग किया जाने वाला बेंचमार्क है। जेम्मा 4 26बी मॉडल का उपयोग करते हुए, हमारे सिस्टम ने 88.15% निष्पादन सटीकता हासिल की , जिससे यह सिद्ध होता है कि आर्किटेक्चर और संदर्भ प्रबंधन मॉडल चयन जितना ही महत्वपूर्ण है।
स्पाइडर 1.0 क्यों?
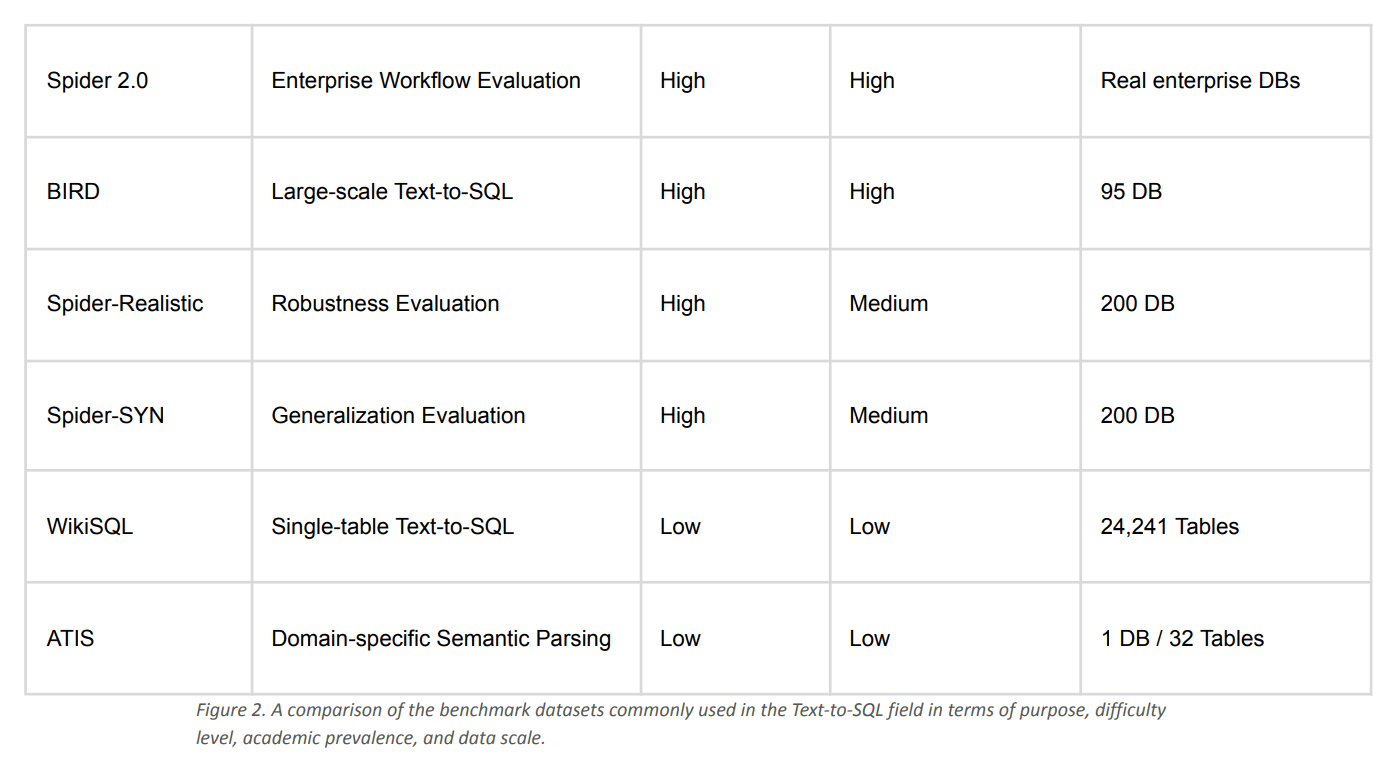
सही बेंचमार्क चुनना उतना ही महत्वपूर्ण है जितना सही मॉडल चुनना। हालांकि स्पाइडर 2.0 और बर्ड जैसे नए डेटासेट अधिक जटिल उद्यम परिदृश्यों को प्रस्तुत करते हैं, स्पाइडर 1.0 टेक्स्ट-टू-एसक्यूएल सिस्टम का मूल्यांकन करने और साहित्य में परिणामों की तुलना करने के लिए सबसे व्यापक रूप से अपनाया जाने वाला बेंचमार्क बना हुआ है।
प्रारंभिक मूल्यांकन के लिए, हमने स्पाइडर 1.0 को चुना क्योंकि यह एक मानकीकृत और सुस्थापित आधार प्रदान करता है। यह हमें यह मापने की अनुमति देता है कि हमारा डेटा एजेंट वास्तविक परिस्थितियों में पहले से अनदेखे डेटाबेस स्कीमा को कितनी प्रभावी ढंग से समझता है और सही SQL उत्पन्न करता है।
चित्र 2 में संक्षेप में बताया गया है कि स्पाइडर 1.0 की तुलना अन्य आमतौर पर उपयोग किए जाने वाले टेक्स्ट-टू-एसक्यूएल बेंचमार्क से कैसे की जाती है।
डेटा एजेंट का निर्माण
टेक्स्ट-टू-एसक्यूएल में उच्च सटीकता प्राप्त करना केवल एक बड़े भाषा मॉडल का उपयोग करने का मामला नहीं है। हमारी बेंचमार्किंग प्रक्रिया के दौरान, हमने पाया कि मॉडल चयन की तुलना में आर्किटेक्चर और कॉन्टेक्स्ट मैनेजमेंट का प्रदर्शन पर कहीं अधिक प्रभाव पड़ता है।
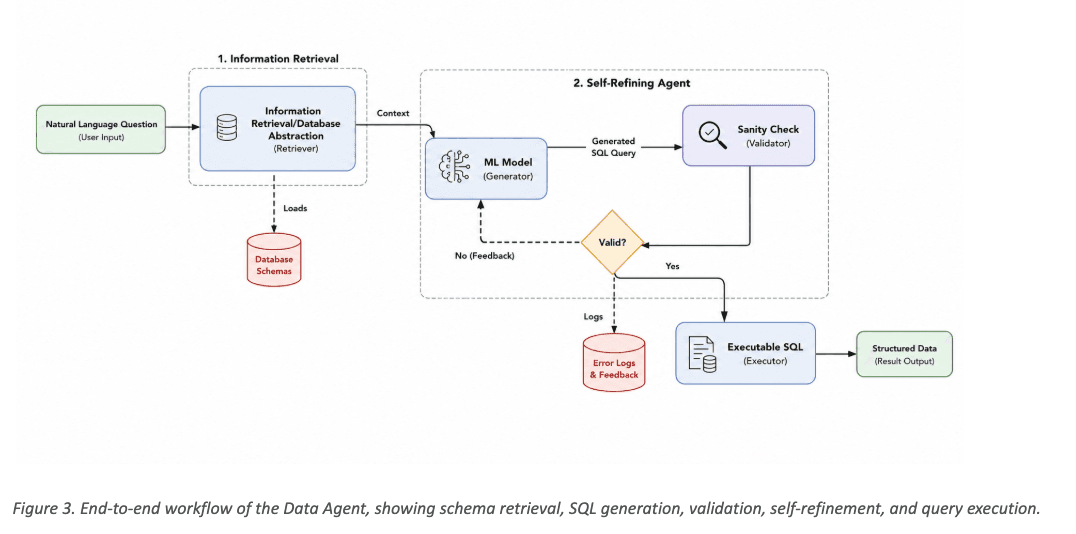
हमारा डेटा एजेंट एक बहु-स्तरीय पाइपलाइन के रूप में डिज़ाइन किया गया है जो LLM से SQL उत्पन्न करने का अनुरोध करने से पहले समस्या को धीरे-धीरे सीमित करता है। संपूर्ण डेटाबेस स्कीमा को मॉडल के सामने प्रस्तुत करने के बजाय, सिस्टम पहले केवल प्रासंगिक स्कीमा और संदर्भ संबंधी जानकारी प्राप्त करता है, फिर एक SQL क्वेरी उत्पन्न करता है, परिणाम को मान्य करता है, और निष्पादन से पहले सामान्य त्रुटियों को स्वचालित रूप से ठीक करता है।
चित्र 3 में दर्शाए अनुसार , इस संरचना में तीन मुख्य चरण शामिल हैं:
सूचना पुनर्प्राप्ति उपयोगकर्ता के प्रश्न का विश्लेषण करके प्रासंगिक डेटाबेस ऑब्जेक्ट्स की पहचान की जाती है, और मेटाडेटा स्टोर से केवल आवश्यक स्कीमा जानकारी ही प्राप्त की जाती है।
स्व-परिष्करण एजेंट – लैंग्वेज मॉडल SQL जनरेट करता है, प्राप्त स्कीमा के आधार पर क्वेरी को मान्य करता है, और जब भी सत्यापन विफल होता है तो उसे स्वचालित रूप से परिष्कृत करता है।
निष्पादन और प्रतिक्रिया – सत्यापन हो जाने के बाद, SQL क्वेरी को लक्ष्य डेटाबेस के विरुद्ध निष्पादित किया जाता है, और परिणाम संरचित डेटा या प्राकृतिक भाषा प्रतिक्रिया के रूप में वापस कर दिए जाते हैं।
यह उत्पादन-उन्मुख आर्किटेक्चर DIN-SQL और DAIL-SQL में प्रस्तुत विचारों से प्रेरित है , जबकि इसे उद्यम परिवेशों के लिए अनुकूलित किया गया है जहां विश्वसनीयता, व्याख्यात्मकता और मजबूती बेंचमार्क सटीकता जितनी ही महत्वपूर्ण हैं।
हमारी बेंचमार्किंग यात्रा
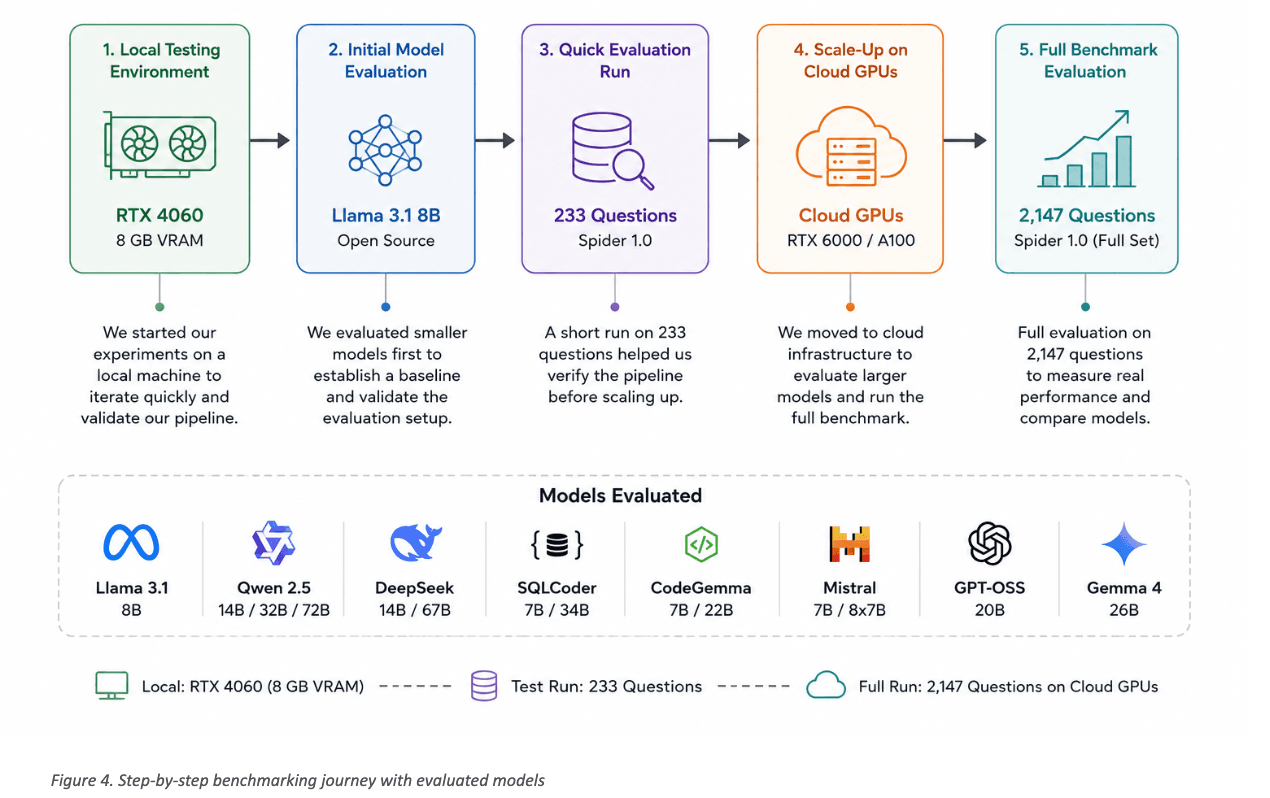
सही भाषा मॉडल का चयन हमारी बेंचमार्किंग प्रक्रिया का एक महत्वपूर्ण हिस्सा था। किसी एक मॉडल का मूल्यांकन करने के बजाय, हमने लामा 3.1, क्वेन 2.5, डीपसीक, एसक्यूएलकोडर, कोडजेम्मा, मिस्ट्रल, जीपीटी-ओएसएस और जेम्मा 4 सहित कई ओपन-सोर्स एलएलएम के साथ प्रयोग किया।
निष्पक्ष तुलना सुनिश्चित करने के लिए, हमने टेक्स्ट-टू-एसक्यूएल बेंचमार्किंग के मानक मापदंड, एक्ज़ीक्यूशन एक्यूरेसी (ईए) का उपयोग करके प्रत्येक मॉडल का मूल्यांकन किया । सिंटैक्स-आधारित मापदंडों के विपरीत, एक्ज़ीक्यूशन एक्यूरेसी यह मापती है कि क्या उत्पन्न एसक्यूएल संदर्भ क्वेरी के समान परिणाम देता है, जिससे यह वास्तविक दुनिया के प्रदर्शन का बेहतर संकेतक बन जाता है।
हमारी बेंचमार्किंग यात्रा चित्र 4 में दर्शाई गई है । हमने एक स्थानीय वर्कस्टेशन पर प्रयोग करना शुरू किया, जिसमें RTX 4060 (8 GB VRAM) लगा हुआ था । छोटे मॉडलों ने हमें तेजी से प्रयोग करने और अपनी पाइपलाइन को मान्य करने में मदद की। 233 स्पाइडर 1.0 प्रश्नों के एक उपसमूह का उपयोग करके एक स्थिर आधार रेखा स्थापित करने के बाद, हम क्लाउड जीपीयू पर चले गए ताकि 2,147 प्रश्नों वाले पूर्ण बेंचमार्क पर बड़े मॉडलों का मूल्यांकन कर सकें। इस चरणबद्ध दृष्टिकोण ने हमें बड़े पैमाने पर बेंचमार्क चलाने से पहले आर्किटेक्चर को कुशलतापूर्वक अनुकूलित करने में सक्षम बनाया।
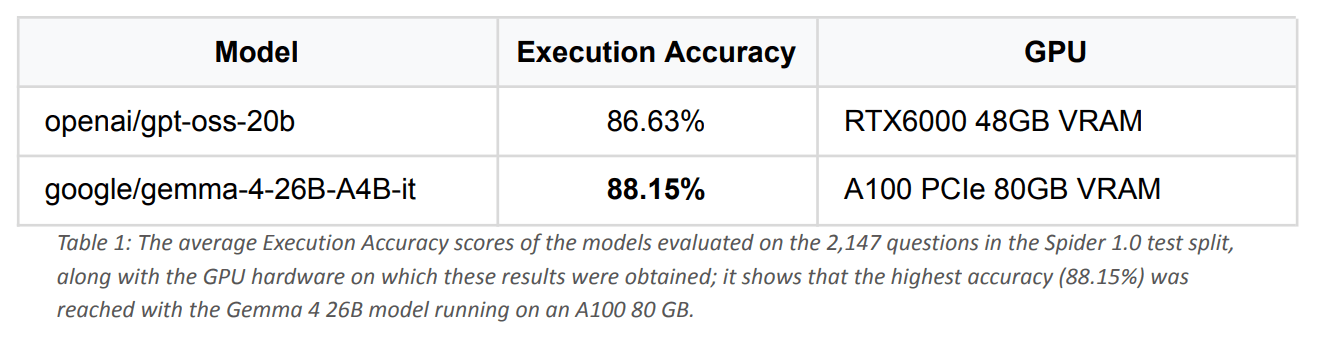
हमने 2,147 प्रश्नों वाले संपूर्ण स्पाइडर 1.0 परीक्षण विभाजन पर अंतिम मॉडलों का मूल्यांकन किया। तालिका 1 में दर्शाए अनुसार, जेम्मा 4 26B ने उच्चतम स्कोर (88.15%) प्राप्त किया, उसके बाद जीपीटी-ओएसएस 20B (86.63%) का स्थान रहा। ये परिणाम दर्शाते हैं कि आधुनिक ओपन-सोर्स एलएलएम, जब एक प्रभावी पुनर्प्राप्ति और सत्यापन पाइपलाइन के साथ संयोजित होते हैं, तो टेक्स्ट-टू-एसक्यूएल में उच्च प्रतिस्पर्धी प्रदर्शन प्राप्त कर सकते हैं।
इन परिणामों की तुलना कैसे की जाए?
बेंचमार्क स्कोर तभी सार्थक होते हैं जब उनकी तुलना पहले प्रकाशित कार्यों से की जा सके। अपने परिणामों के महत्व को बेहतर ढंग से समझने के लिए, हमने टेक्स्ट-टू-एसक्यूएल पर हाल ही में किए गए अध्ययनों और व्यापक रूप से संदर्भित बेंचमार्क पत्रों की समीक्षा की।
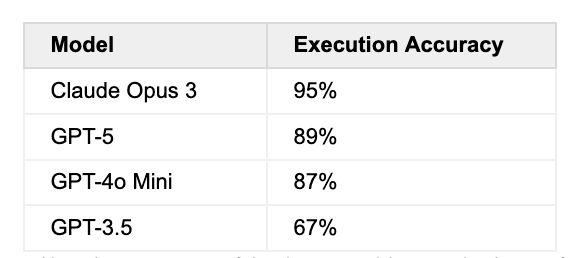
तालिका 2: स्पाइडर डेटासेट के एक उपसमूह पर SQL-ऑफ-थॉट अध्ययन में रिपोर्ट किए गए क्लोज्ड-सोर्स मॉडल की सटीकता दरें; यह तुलनात्मक रूप से दर्शाता है कि इस कार्य में प्राप्त 88.15% परिणाम GPT-4o मिनी (87%) से ऊपर और GPT-5 (89%) के करीब है।
हाल ही में हुए शोध जैसे कि SQL-of-Thought [1] से पता चलता है कि क्लाउड ओपस 3, GPT-5 और GPT-4o मिनी सहित प्रमुख क्लोज्ड-सोर्स मॉडल स्पाइडर बेंचमार्क उपसमूहों पर उच्च सटीकता प्राप्त करते हैं। हालांकि मूल्यांकन सेटिंग्स, प्रॉम्प्ट और बेंचमार्क उपसमूहों में अंतर के कारण प्रत्यक्ष तुलनाओं की सावधानीपूर्वक व्याख्या की जानी चाहिए, हमारी 88.15% निष्पादन सटीकता दर्शाती है कि ओपन-सोर्स मॉडल भी समान प्रतिस्पर्धी सीमा के भीतर प्रदर्शन प्राप्त कर सकते हैं।
हालांकि ये परिणाम अलग-अलग मूल्यांकन स्थितियों से प्राप्त हुए हैं और इनकी सीधे तुलना नहीं की जानी चाहिए, फिर भी ये टेक्स्ट-टू-एसक्यूएल सिस्टम के वर्तमान प्रदर्शन परिदृश्य को समझने के लिए उपयोगी संदर्भ प्रदान करते हैं। हमारा बेंचमार्क दर्शाता है कि अच्छी तरह से डिज़ाइन किए गए आर्किटेक्चर के साथ संयुक्त होने पर ओपन-सोर्स मॉडल अब अग्रणी क्लोज्ड-सोर्स विकल्पों के साथ प्रतिस्पर्धा कर सकते हैं।
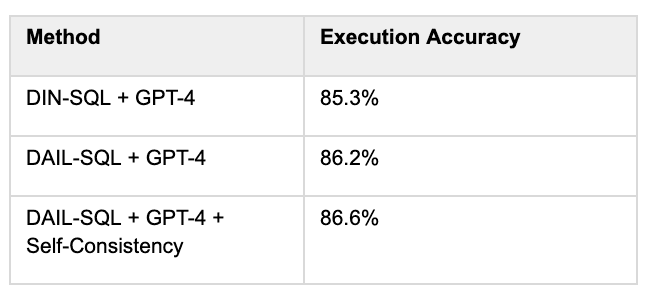
हमने अपने परिणामों की तुलना उत्पादन-उन्मुख टेक्स्ट-टू-एसक्यूएल फ्रेमवर्क जैसे डीआईएन-एसक्यूएल [3] और डीएआईएल- एसक्यूएल से भी की, जो स्कीमा लिंकिंग, प्रॉम्प्ट इंजीनियरिंग, स्व-संगति और त्रुटि सुधार सहित तकनीकों के साथ बड़े भाषा मॉडल को जोड़ते हैं।
तालिका 3: "टेक्स्ट-टू-एसक्यूएल एम्पावर्ड बाय लार्ज लैंग्वेज मॉडल्स: ए बेंचमार्क इवैल्यूएशन" [2] अध्ययन में स्पाइडर 1.0 पर विभिन्न विधियों के निष्पादन सटीकता परिणाम; यह न केवल मॉडल चयन बल्कि प्रॉम्प्ट इंजीनियरिंग, स्कीमा लिंकिंग और स्व-संगति जैसी तकनीकों की सटीकता पर प्रभाव को दर्शाता है।
हमारे निष्कर्ष हाल के साहित्य में साझा किए गए एक निष्कर्ष की पुष्टि करते हैं: उच्च टेक्स्ट-टू-एसक्यूएल प्रदर्शन न केवल भाषा मॉडल पर, बल्कि आसपास की वास्तुकला पर भी निर्भर करता है। प्रभावी स्कीमा पुनर्प्राप्ति, संदर्भ प्रबंधन, सत्यापन और स्व-सुधार अक्सर मॉडल जितना ही महत्वपूर्ण होते हैं।
जो हमने सीखा
बेंचमार्किंग का मतलब सिर्फ सटीकता मापना ही नहीं है—इसका मतलब यह भी समझना है कि कोई सिस्टम कहां और क्यों विफल होता है। अपने मूल्यांकन के दौरान, हमने गलत भविष्यवाणियों का विश्लेषण किया और कई ऐसे दोहराए जाने वाले पैटर्न की पहचान की जिन्होंने अंतिम स्कोर को प्रभावित किया।
कुछ त्रुटियाँ स्वयं बेंचमार्क से उत्पन्न हुईं। कुछ मामलों में, संदर्भ (गोल्ड) SQL क्वेरी में विसंगतियों के कारण तार्किक रूप से सही भविष्यवाणियों को गलत के रूप में चिह्नित किया गया। अन्य मामलों में अस्पष्ट प्राकृतिक भाषा के प्रश्न या टाई-ब्रेकिंग परिदृश्य शामिल थे, जहाँ कई SQL क्वेरी वैध रूप से समान रूप से मान्य उत्तर दे सकती थीं।
हमने कई मॉडल-विशिष्ट व्यवहार भी देखे, जिनमें अनावश्यक टाइप रूपांतरण, केस संवेदनशीलता का असंगत प्रबंधन और सरल SQL क्वेरीज़ का कभी-कभी अत्यधिक जटिल हो जाना शामिल है। इन निष्कर्षों ने डेटा एजेंट पाइपलाइन में सत्यापन और स्व-सुधार तंत्रों को शामिल करने के महत्व को रेखांकित किया।
कुल मिलाकर, हमारे विश्लेषण से पता चला कि कई शेष त्रुटियाँ भाषा मॉडल की सीमाओं के कारण नहीं, बल्कि बेंचमार्क में अस्पष्टताओं या SQL जनरेशन में अपवादों के कारण थीं। इससे पता चलता है कि पुनर्प्राप्ति, सत्यापन और संदर्भ प्रबंधन में और सुधार करने से सिस्टम 90% निष्पादन सटीकता की सीमा को पार कर सकता है।
लागत और दक्षता
उत्पादन के लिए तैयार टेक्स्ट-टू-एसक्यूएल सिस्टम में उच्च सटीकता केवल एक पहलू है। उद्यम परिवेश में, बुनियादी ढांचे की लागत, डेटा गोपनीयता और परिनियोजन लचीलापन भी समान रूप से महत्वपूर्ण विचारणीय बिंदु हैं।
हमारे दृष्टिकोण का एक प्रमुख लाभ यह है कि यह पूरी तरह से ओपन-सोर्स भाषा मॉडल पर आधारित है। विकास प्रक्रिया के दौरान, हम उपभोक्ता-स्तरीय RTX 4060 (8 GB VRAM) का उपयोग करके अधिकांश प्रयोग स्थानीय रूप से करने में सक्षम रहे , जिससे हमें बिना किसी API या टोकन लागत के तेजी से सुधार करने की सुविधा मिली। आर्किटेक्चर के मान्य होने के बाद ही बड़े बेंचमार्क परीक्षण समर्पित क्लाउड GPU पर किए गए।
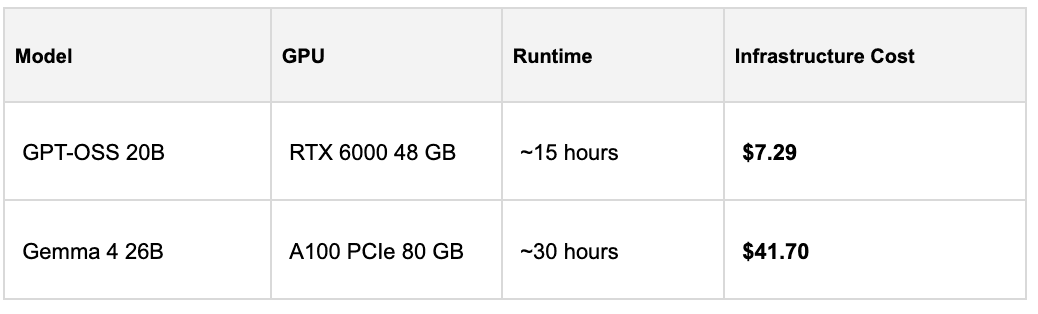
हमने स्पाइडर 1.0 के संपूर्ण मूल्यांकन के लिए रनपॉड सिक्योर क्लाउड का उपयोग किया। जेम्मा 4 26बी बेंचमार्क को A100 PCIe 80 GB GPU पर चलाया गया, जबकि GPT-OSS 20B को RTX 6000 48 GB GPU पर चलाया गया ।
बुनियादी ढांचे की लागत का सारांश तालिका 4 में दिया गया है।
हालांकि सबसे बड़े बेंचमार्क परीक्षणों के लिए क्लाउड इंफ्रास्ट्रक्चर की आवश्यकता थी, स्थानीय प्रयोगों और ओपन-सोर्स मॉडल की बदौलत समग्र विकास प्रक्रिया लागत-प्रभावी बनी रही। इससे भी महत्वपूर्ण बात यह है कि परिणामी आर्किटेक्चर को किसी संगठन के अपने इंफ्रास्ट्रक्चर के भीतर ही पूरी तरह से तैनात किया जा सकता है, जिससे बाहरी API पर निर्भरता समाप्त हो जाती है और डेटा गोपनीयता, अनुपालन और परिचालन लागत पर बेहतर नियंत्रण मिलता है।
यह आर्किटेक्चर उन संगठनों के लिए विशेष रूप से उपयुक्त है जो गोपनीयता के प्रति संवेदनशील, विनियमित या एयर-गैप्ड वातावरण में काम करते हैं, जहां डेटा सुरक्षा और परिनियोजन लचीलापन महत्वपूर्ण आवश्यकताएं हैं।
बियॉन्ड स्पाइडर 1.0
बेंचमार्क कृत्रिम बुद्धिमत्ता प्रणालियों का मूल्यांकन करने का एक वस्तुनिष्ठ तरीका प्रदान करते हैं, लेकिन वे अंतिम लक्ष्य नहीं हैं। उच्च बेंचमार्क स्कोर तभी मूल्यवान होता है जब वह वास्तविक दुनिया के अनुप्रयोगों में विश्वसनीय प्रदर्शन में परिणत हो।
इस अध्ययन के दौरान, हमने पाया कि उत्पादन के लिए तैयार टेक्स्ट-टू-एसक्यूएल सिस्टम बनाना केवल एसक्यूएल उत्पन्न करने से कहीं अधिक है। डेटाबेस स्कीमा को समझना, सही संदर्भ प्राप्त करना, उत्पन्न क्वेरी को मान्य करना और गलत आउटपुट को परिष्कृत करना भाषा मॉडल जितना ही महत्वपूर्ण साबित हुआ।
स्पाइडर 1.0 पर हमारी 88.15% निष्पादन सटीकता यह दर्शाती है कि ओपन-सोर्स मॉडल, एक सुव्यवस्थित आर्किटेक्चर के साथ मिलकर, एंटरप्राइज़ टेक्स्ट-टू-एसक्यूएल कार्यों के लिए उच्च प्रतिस्पर्धी प्रदर्शन प्रदान कर सकते हैं। इससे भी महत्वपूर्ण बात यह है कि यह हमारे डेटा एजेंट के पीछे के डिज़ाइन सिद्धांतों को प्रमाणित करता है , जिसे केवल बेंचमार्क डेटासेट पर ही नहीं, बल्कि जटिल एंटरप्राइज़ डेटाबेस पर भी विश्वसनीय रूप से कार्य करने के लिए बनाया गया था।
स्पाइडर 1.0 एक महत्वपूर्ण उपलब्धि है, लेकिन यह हमारी यात्रा की मात्र शुरुआत है। हमारे अगले कदमों में स्पाइडर 2.0 पर डेटा एजेंट का मूल्यांकन , बड़े उद्यम-स्तरीय बेंचमार्क और सबसे महत्वपूर्ण बात, वास्तविक ग्राहक परिवेश शामिल हैं, जहां डेटाबेस स्कीमा काफी बड़े होते हैं और व्यावसायिक प्रश्न कहीं अधिक जटिल होते हैं।
हमारा दीर्घकालिक लक्ष्य केवल एक बेहतर SQL जनरेटर बनाना नहीं है। हमारा उद्देश्य ऐसे बुद्धिमान डेटा एजेंट बनाना है जो संगठनों को उद्यम डेटा के साथ उसी सहजता से बातचीत करने में सक्षम बनाएँ जैसे वे किसी सहकर्मी से बात करते हैं—जिसमें डेटा पुनर्प्राप्ति, तर्क, सत्यापन और व्याख्या योग्य AI को एक विश्वसनीय निर्णय-सहायता मंच में संयोजित किया जा सके।
कुंजी सबक
बेंचमार्किंग केवल सटीकता मापने के बारे में नहीं है - यह समझने के बारे में है कि कोई प्रणाली सफल क्यों होती है या विफल क्यों होती है।
हमारे मूल्यांकन के दौरान, हमने कई बार दोहराई जाने वाली त्रुटि पैटर्न की पहचान की। इनमें से कुछ बेंचमार्क में ही अस्पष्टताओं के कारण उत्पन्न हुईं, जिनमें संदर्भ SQL क्वेरी में असंगतताएँ और अपर्याप्त रूप से निर्दिष्ट क्रम शर्तें शामिल हैं। अन्य त्रुटियाँ सामान्य LLM व्यवहारों को दर्शाती हैं, जैसे अनावश्यक टाइप कास्टिंग या केस-संवेदनशील मानों का असंगत प्रबंधन।
इन अवलोकनों ने हमारे कार्य के एक प्रमुख निष्कर्ष को पुष्ट किया: मॉडल चयन जितना ही महत्वपूर्ण आर्किटेक्चर भी है। पुनर्प्राप्ति, स्कीमा लिंकिंग, सत्यापन और स्व-सुधार ने अंतर्निहित भाषा मॉडल की तरह ही अंतिम प्रदर्शन में महत्वपूर्ण योगदान दिया।
हालांकि बेंचमार्क की सीमाएं अनिवार्य रूप से अंतिम स्कोर को प्रभावित करती हैं, लेकिन हमारे विश्लेषण से पता चलता है कि संदर्भ प्रबंधन और सत्यापन में और सुधार से सिस्टम को 90% निष्पादन सटीकता के निशान से आगे बढ़ाया जा सकता है।
आगे देख रहे हैं
स्पाइडर 1.0 ने हमारे डेटा एजेंट के मूल्यांकन के लिए एक महत्वपूर्ण आधार प्रदान किया, लेकिन यह उत्पादन के लिए तैयार एंटरप्राइज एआई की दिशा में केवल पहला कदम है।
हमारा अगला लक्ष्य स्पाइडर 2.0 जैसे अधिक चुनौतीपूर्ण बेंचमार्क पर आर्किटेक्चर का मूल्यांकन करना है और, इससे भी महत्वपूर्ण बात यह है कि वास्तविक एंटरप्राइज डेटाबेस पर इसका मूल्यांकन करना है जहां स्कीमा काफी बड़े होते हैं, दस्तावेज़ीकरण अक्सर अधूरा होता है और व्यावसायिक प्रश्न कहीं अधिक जटिल होते हैं।
हमारा लक्ष्य केवल एक और टेक्स्ट-टू-एसक्यूएल सिस्टम बनाना नहीं है। हम ऐसे बुद्धिमान डेटा एजेंट बना रहे हैं जो संगठनों को उद्यम डेटा के साथ स्वाभाविक और विश्वसनीय रूप से बातचीत करने में मदद करने के लिए पुनर्प्राप्ति, तर्क, सत्यापन और व्याख्यात्मकता को संयोजित करते हैं।
संदर्भ
[1] सौम्या चतुर्वेदी, अमन चड्ढा, लॉरेंट बिंडशेडलर arXiv. “SQL-of-Thought: गाइडेड एरर करेक्शन के साथ मल्टी-एजेंटिक टेक्स्ट-टू-SQL.” arXiv. जून 2026 https://arxiv.org/abs/2509.00581
[2] दावेई गाओ, हैबिन वांग, यालियांग ली, ज़ियू सन, यिचेन कियान, बोलिन डिंग, जिंगरेन झोउ "टेक्स्ट-टू-एसक्यूएल बड़े भाषा मॉडल द्वारा सशक्त: एक बेंचमार्क मूल्यांकन" arXiv। जून 2026