Benchmark memberikan cara objektif untuk mengevaluasi sistem AI, tetapi bukan tujuan utama. Skor benchmark yang tinggi hanya berharga jika diterjemahkan ke dalam kinerja yang andal dalam aplikasi dunia nyata.
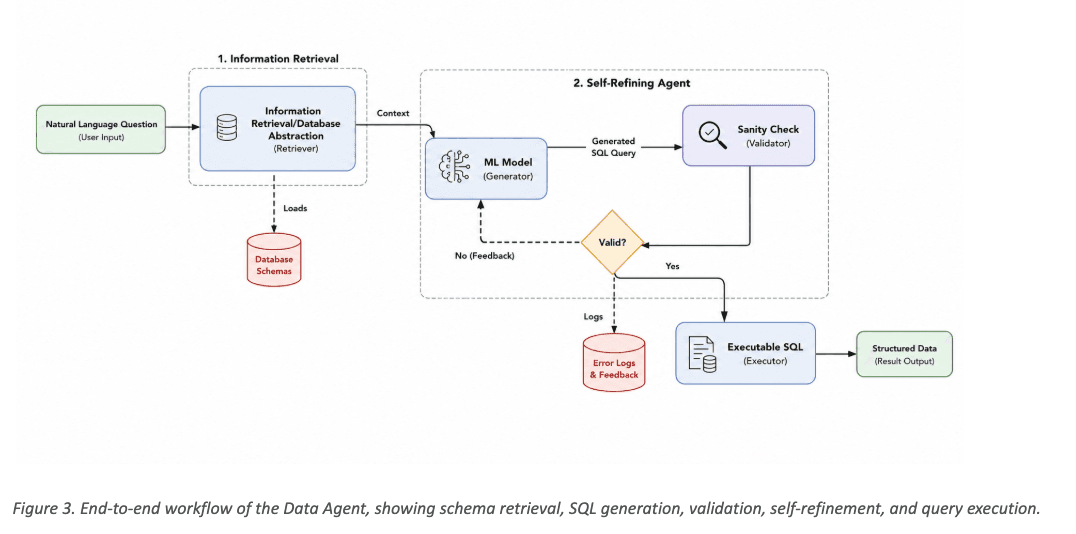
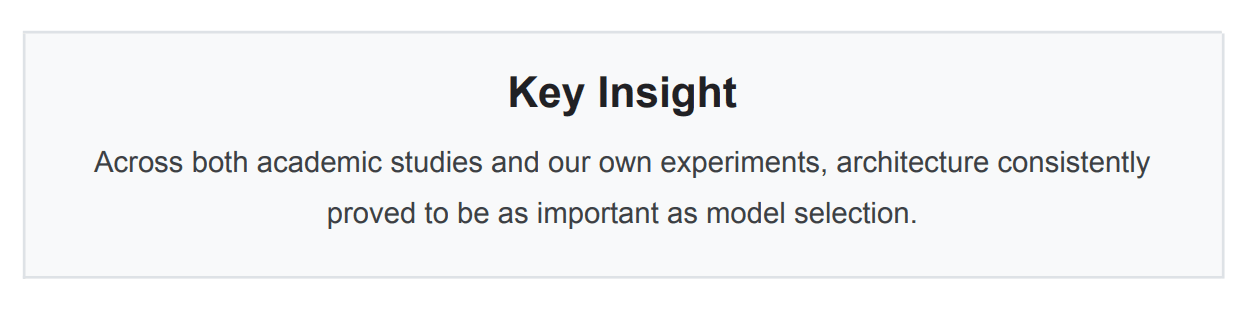
Sepanjang studi ini, kami menemukan bahwa membangun sistem Text-to-SQL yang siap produksi jauh lebih dari sekadar menghasilkan SQL. Memahami skema basis data, mengambil konteks yang tepat, memvalidasi kueri yang dihasilkan, dan memperbaiki keluaran yang salah terbukti sama pentingnya dengan model bahasa itu sendiri.
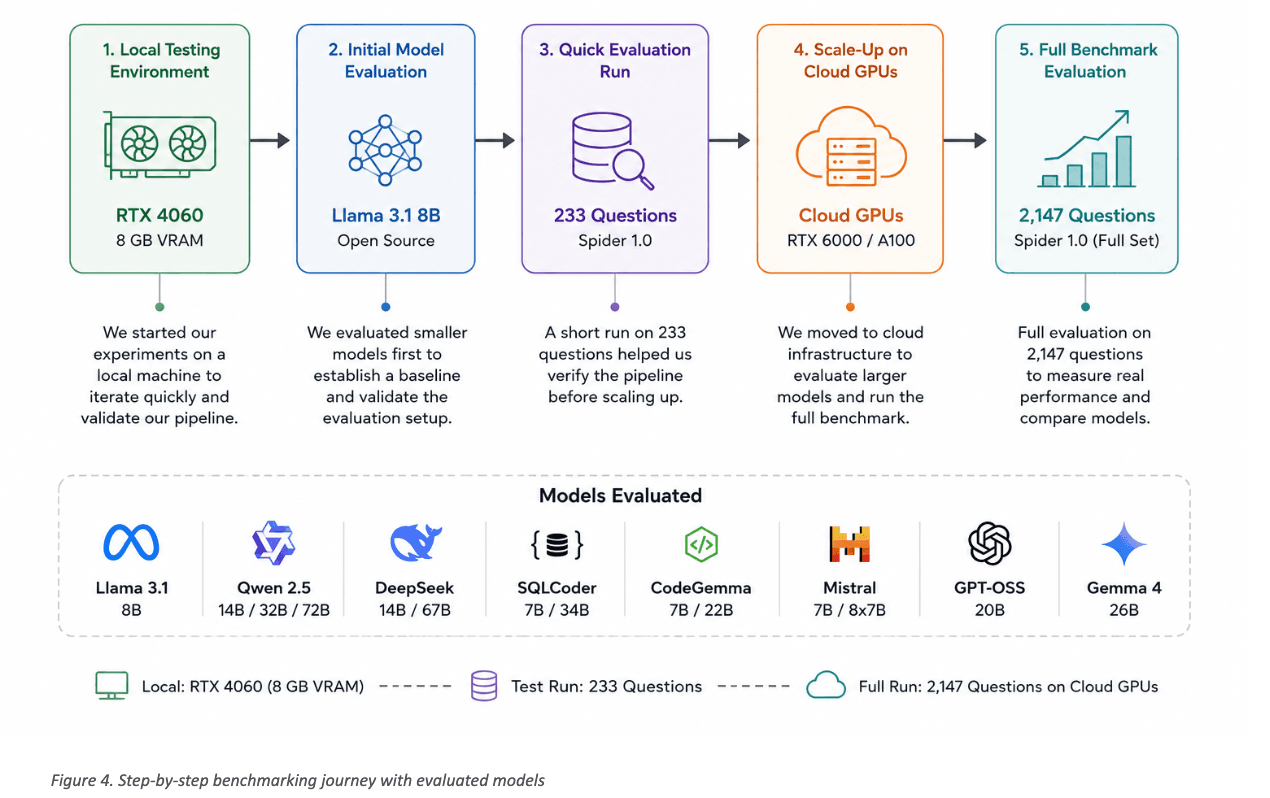
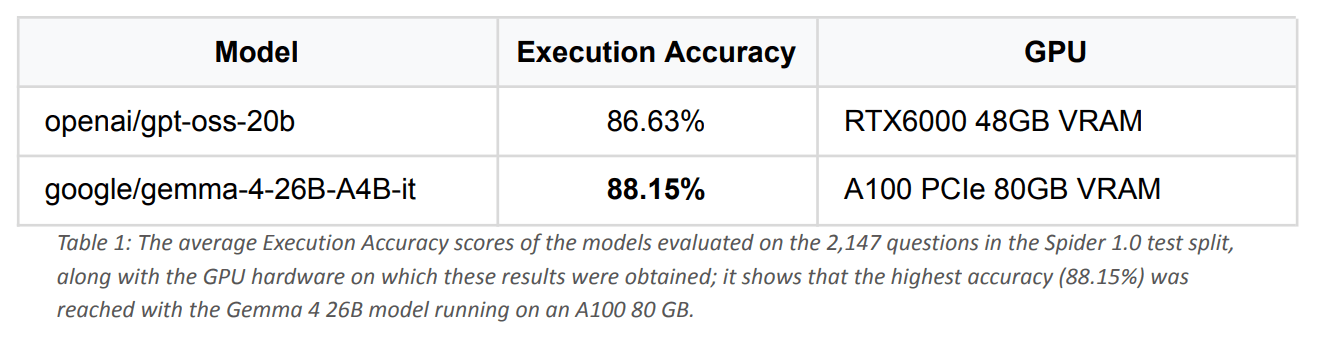
Akurasi Eksekusi 88.15% kami pada Spider 1.0 menunjukkan bahwa model sumber terbuka, dikombinasikan dengan arsitektur yang dirancang dengan baik, dapat memberikan kinerja yang sangat kompetitif untuk tugas Text-to-SQL perusahaan. Lebih penting lagi, ini memvalidasi prinsip-prinsip desain di balik Agen Data kami , yang dibangun untuk beroperasi secara andal pada basis data perusahaan yang kompleks, bukan hanya pada kumpulan data benchmark.
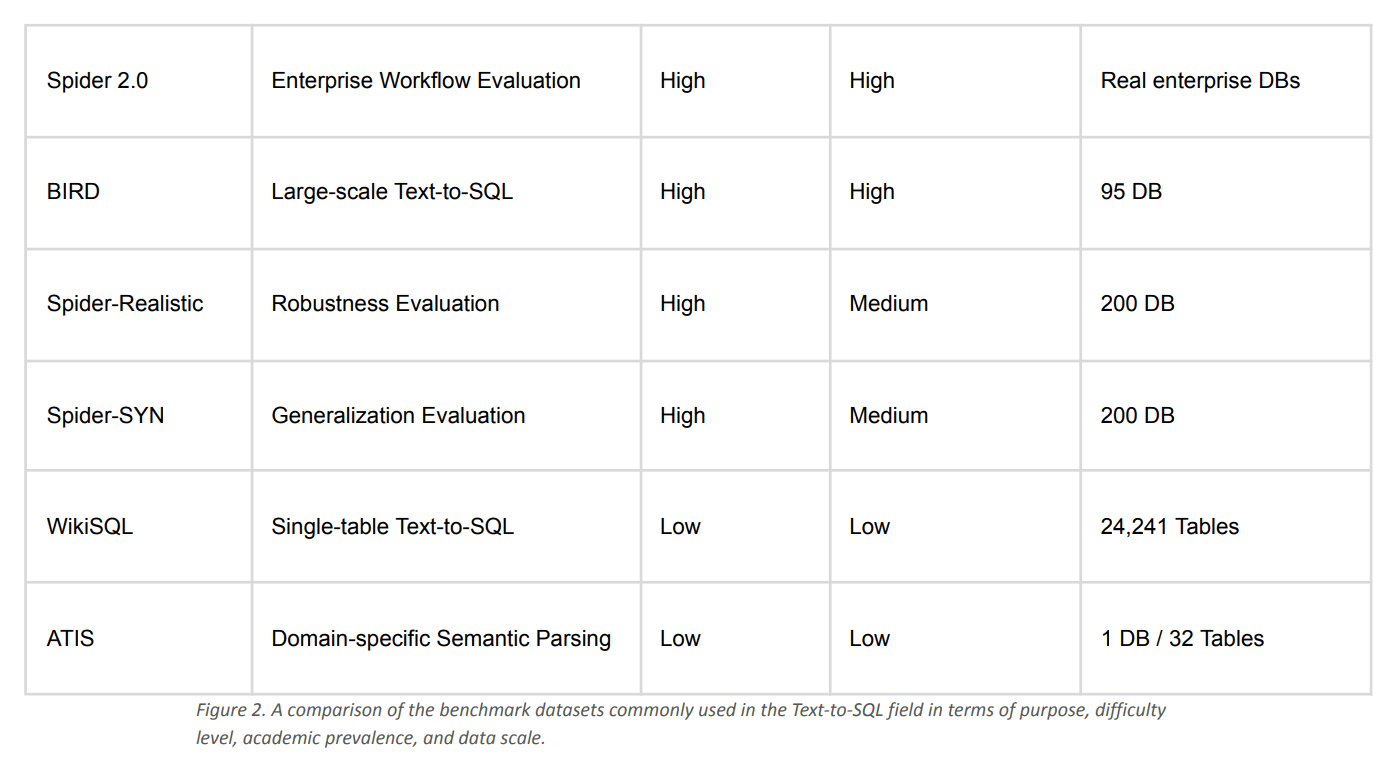
Spider 1.0 merupakan tonggak penting, tetapi ini hanyalah awal dari perjalanan kami. Langkah selanjutnya meliputi evaluasi Data Agent pada Spider 2.0 , tolok ukur skala perusahaan yang lebih besar, dan yang terpenting, lingkungan pelanggan nyata di mana skema basis data jauh lebih besar dan pertanyaan bisnis jauh lebih kompleks.
Visi jangka panjang kami bukan sekadar membangun generator SQL yang lebih baik. Kami bertujuan untuk membangun Agen Data cerdas yang memungkinkan organisasi berinteraksi dengan data perusahaan senatural mungkin seperti berkomunikasi dengan kolega—menggabungkan pengambilan, penalaran, validasi, dan AI yang dapat dijelaskan ke dalam platform pendukung keputusan yang andal.