Realizzazione di un sistema Text-to-SQL pronto per la produzione: raggiungimento dell'88.15% su Spider 1.0
Data di pubblicazione
Luglio 13, 2026
Condividi
Sintesi
La creazione di un sistema Text-to-SQL pronto per la produzione richiede molto più della semplice generazione di SQL con un modello linguistico di grandi dimensioni. Le applicazioni aziendali richiedono una comprensione accurata dello schema, il recupero del contesto, la convalida e la correzione degli errori per produrre risultati affidabili su database mai visti prima.
In questo studio, abbiamo testato le prestazioni del nostro Data Agent su Spider 1.0 , ottenendo un'accuratezza di esecuzione dell'88.15% utilizzando il modello Gemma 4 26B . Anziché concentrarci esclusivamente sui punteggi di benchmark, questo articolo condivide le decisioni architetturali, le lezioni di ingegneria e le informazioni derivanti dal benchmarking che hanno portato a questi risultati.
Oltre la generazione SQL
I modelli linguistici di grandi dimensioni hanno migliorato significativamente la generazione di SQL, ma la creazione di un sistema Text-to-SQL pronto per la produzione richiede molto più della semplice traduzione del linguaggio naturale in SQL. Le applicazioni aziendali devono comprendere schemi di database complessi, recuperare il contesto corretto, convalidare le query generate e produrre risultati affidabili su database mai visti prima.
Per valutare queste capacità, abbiamo eseguito un benchmark del nostro Data Agent su Spider 1.0, il benchmark Text-to-SQL più diffuso. Utilizzando il modello Gemma 4 26B , il nostro sistema ha raggiunto un'accuratezza di esecuzione dell'88.15% , dimostrando che l'architettura e la gestione del contesto sono importanti quanto la selezione del modello.
Perché Spider 1.0?
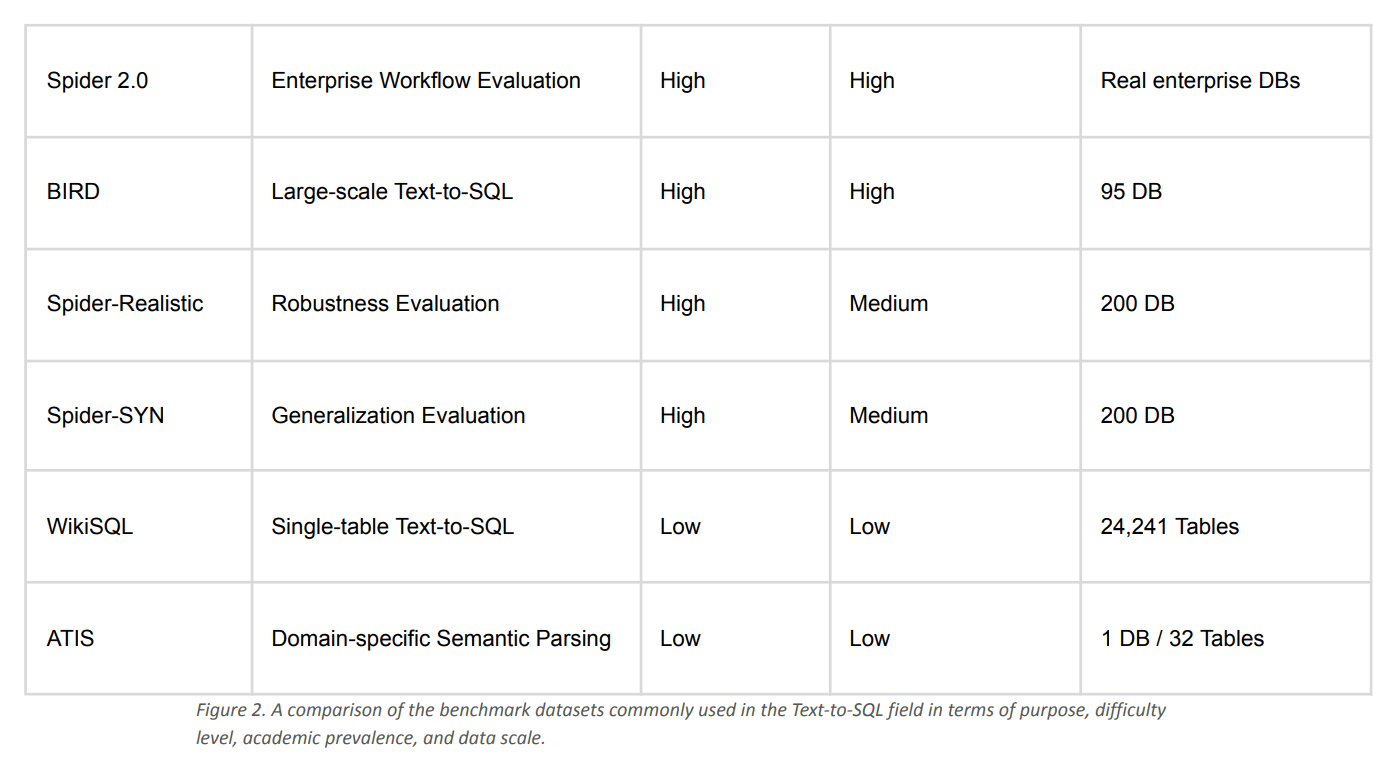
La scelta del benchmark giusto è altrettanto importante quanto la scelta del modello giusto. Sebbene i dataset più recenti, come Spider 2.0 e BIRD, introducano scenari aziendali più complessi, Spider 1.0 rimane il benchmark più ampiamente adottato per la valutazione dei sistemi Text-to-SQL e per il confronto dei risultati nella letteratura di riferimento.
Per la nostra valutazione iniziale, abbiamo scelto Spider 1.0 perché fornisce una base di riferimento standardizzata e consolidata. Ci permette di misurare l'efficacia con cui il nostro Data Agent comprende schemi di database mai visti prima e genera codice SQL corretto in condizioni realistiche.
La Figura 2 riassume il confronto tra Spider 1.0 e altri benchmark Text-to-SQL comunemente utilizzati.
Creazione dell'agente dati
Raggiungere un'elevata precisione nella conversione da testo a SQL non è semplicemente una questione di utilizzare un modello linguistico più ampio. Durante il nostro processo di benchmarking, abbiamo scoperto che l'architettura e la gestione del contesto hanno un impatto maggiore sulle prestazioni rispetto alla sola selezione del modello.
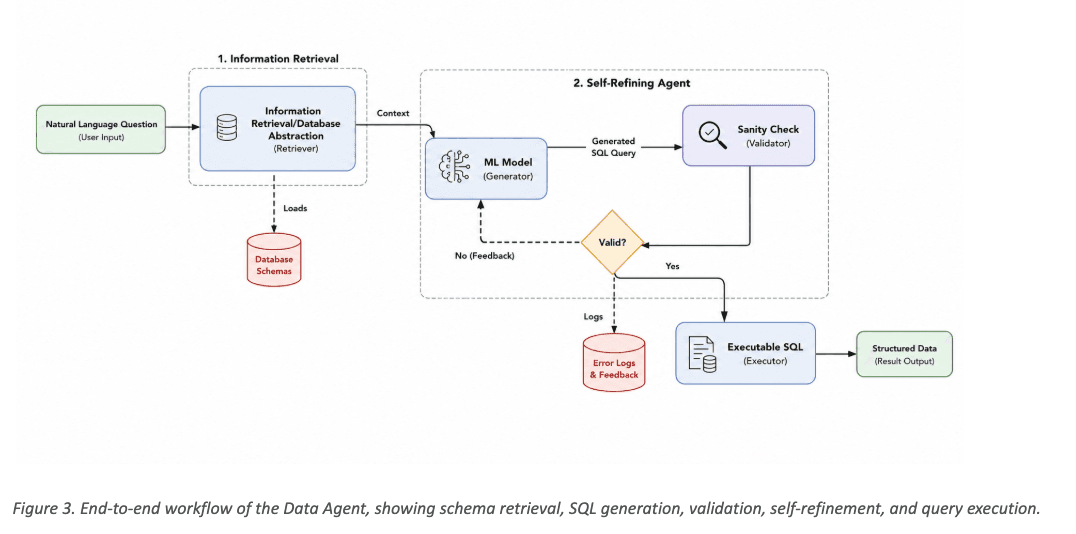
Il nostro Data Agent è progettato come una pipeline a più fasi che restringe progressivamente il problema prima di chiedere al LLM di generare SQL. Invece di esporre l'intero schema del database al modello, il sistema recupera prima solo lo schema e le informazioni contestuali rilevanti, quindi genera una query SQL, convalida il risultato e corregge automaticamente gli errori comuni prima dell'esecuzione.
Come illustrato nella Figura 3 , l'architettura si compone di tre fasi principali:
Recupero delle informazioni – La domanda dell'utente viene analizzata per identificare gli oggetti del database pertinenti e solo le informazioni di schema necessarie vengono recuperate dall'archivio dei metadati.
Agente autoraffinante – Il modello linguistico genera SQL, convalida la query rispetto allo schema recuperato e la perfeziona automaticamente in caso di errore di convalida.
Esecuzione e risposta – Una volta convalidata, la query SQL viene eseguita sul database di destinazione e i risultati vengono restituiti come dati strutturati o come risposta in linguaggio naturale.
Questa architettura orientata alla produzione si ispira ai concetti introdotti in DIN-SQL e DAIL-SQL , pur essendo adattata agli ambienti aziendali in cui affidabilità, interpretabilità e robustezza sono importanti quanto la precisione dei benchmark.
Il nostro percorso di benchmarking
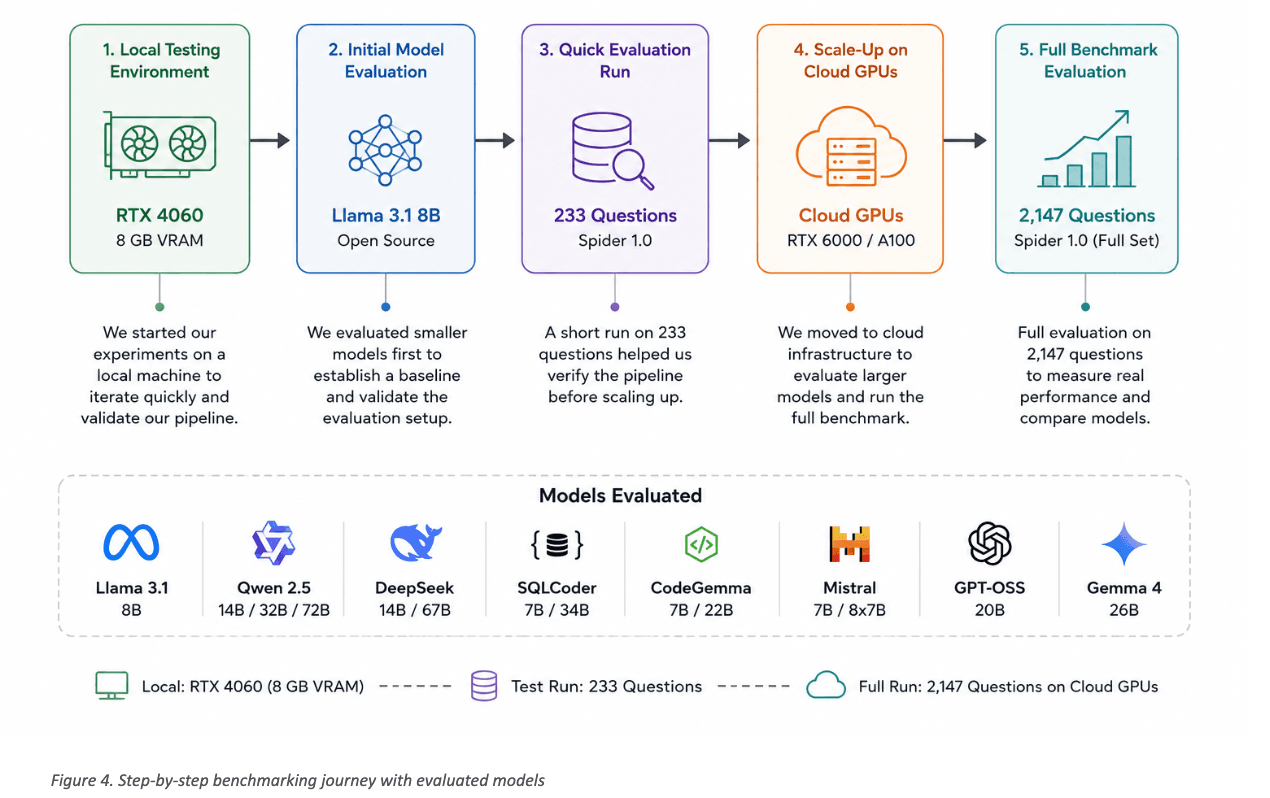
La scelta del modello linguistico più adatto è stata una parte fondamentale del nostro processo di benchmarking. Anziché valutare un singolo modello, abbiamo sperimentato un'ampia gamma di modelli linguistici open source, tra cui Llama 3.1, Qwen 2.5, DeepSeek, SQLCoder, CodeGemma, Mistral, GPT-OSS e Gemma 4.
Per garantire un confronto equo, abbiamo valutato ogni modello utilizzando l'accuratezza di esecuzione (Execution Accuracy, EA) , la metrica standard per il benchmarking della conversione da testo a SQL. A differenza delle metriche basate sulla sintassi, l'accuratezza di esecuzione misura se l'SQL generato restituisce lo stesso risultato della query di riferimento, risultando quindi un indicatore migliore delle prestazioni nel mondo reale.
Il nostro percorso di benchmarking è illustrato nella Figura 4. Abbiamo iniziato sperimentando su una workstation locale dotata di una RTX 4060 (8 GB di VRAM) , dove modelli più piccoli ci hanno permesso di iterare rapidamente e convalidare la nostra pipeline. Dopo aver stabilito una baseline stabile utilizzando un sottoinsieme di 233 domande di Spider 1.0, siamo passati alle GPU cloud per valutare modelli più grandi sull'intero benchmark di 2,147 domande . Questo approccio graduale ci ha permesso di ottimizzare l'architettura in modo efficiente prima di investire in test di benchmark su larga scala.
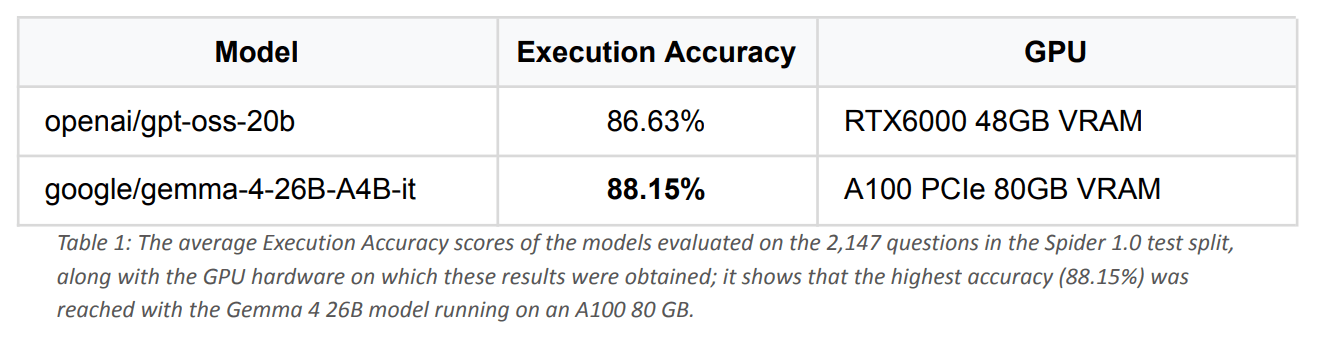
Abbiamo valutato i modelli finali sull'intero set di test Spider 1.0, contenente 2,147 domande. Come mostrato nella Tabella 1, Gemma 4 26B ha ottenuto il punteggio più alto (88.15%), seguito da GPT-OSS 20B (86.63%). Questi risultati dimostrano che i moderni modelli di apprendimento per rinforzo open-source, se combinati con un'efficace pipeline di recupero e validazione, possono raggiungere prestazioni Text-to-SQL altamente competitive.
Come si confrontano questi risultati?
I punteggi di benchmark sono significativi solo se confrontabili con lavori pubblicati in precedenza. Per comprendere meglio il significato dei nostri risultati, abbiamo esaminato sia studi recenti sul Text-to-SQL sia articoli di benchmark ampiamente citati.
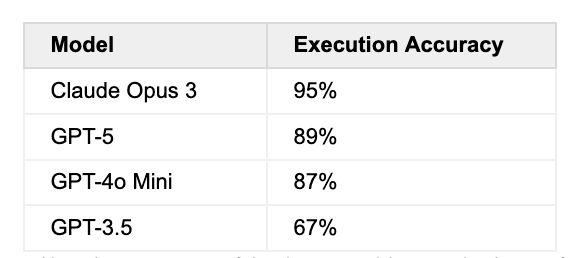
Tabella 2: Tassi di accuratezza dei modelli closed-source riportati nello studio SQL-of-Thought su un sottoinsieme del dataset Spider; mostra, in termini comparativi, che il risultato dell'88.15% ottenuto in questo lavoro si posiziona al di sopra di GPT-4o Mini (87%) e a un livello vicino a GPT-5 (89%).
Recenti lavori come SQL-of-Thought [1] riportano che i principali modelli closed-source, tra cui Claude Opus 3, GPT-5 e GPT-4o Mini , raggiungono un'elevata accuratezza sui sottoinsiemi del benchmark Spider. Sebbene i confronti diretti debbano essere interpretati con cautela a causa delle differenze nelle impostazioni di valutazione, nei prompt e nei sottoinsiemi del benchmark, la nostra accuratezza di esecuzione dell'88.15% dimostra che i modelli open-source possono raggiungere prestazioni all'interno dello stesso intervallo competitivo.
Sebbene questi risultati provengano da contesti di valutazione differenti e non debbano essere confrontati direttamente, forniscono un utile quadro di riferimento per comprendere l'attuale panorama prestazionale dei sistemi Text-to-SQL. Il nostro benchmark dimostra che i modelli open-source possono ora competere con le principali alternative proprietarie se combinati con un'architettura ben progettata.
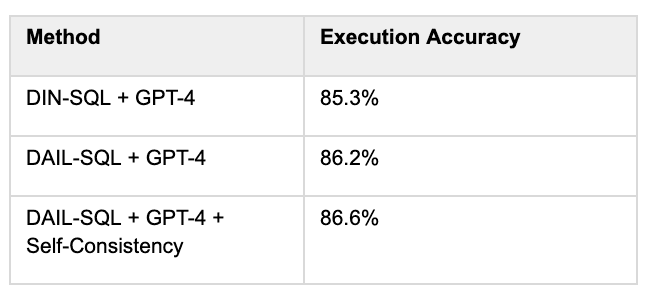
Abbiamo anche confrontato i nostri risultati con framework Text-to-SQL orientati alla produzione come DIN-SQL [3] e DAIL-SQ L, che combinano modelli linguistici di grandi dimensioni con tecniche che includono il collegamento dello schema, l'ingegneria dei prompt, l'autoconsistenza e la correzione degli errori.
Tabella 3: Risultati di accuratezza dell'esecuzione di diversi metodi su Spider 1.0 nello studio "Text-to-SQL potenziato da grandi modelli linguistici: una valutazione di benchmark" [2]; rivela l'impatto sull'accuratezza non solo della selezione del modello ma anche di tecniche come l'ingegneria dei prompt, il collegamento dello schema e l'autoconsistenza.
I nostri risultati confermano una conclusione condivisa dalla letteratura recente: le elevate prestazioni del Text-to-SQL dipendono non solo dal modello linguistico, ma anche dall'architettura circostante. Un recupero efficace dello schema, la gestione del contesto, la convalida e l'autocorrezione sono spesso importanti quanto il modello stesso.
Ciò che abbiamo imparato
Il benchmarking non riguarda solo la misurazione dell'accuratezza, ma anche la comprensione di dove e perché un sistema fallisce. Nel corso della nostra valutazione, abbiamo analizzato le previsioni errate e identificato diversi schemi ricorrenti che hanno influenzato i punteggi finali.
Alcuni errori derivavano dal benchmark stesso. In un numero limitato di casi, le incongruenze nelle query SQL di riferimento (gold standard) hanno fatto sì che previsioni logicamente corrette venissero contrassegnate come errate. Altri casi riguardavano domande ambigue in linguaggio naturale o scenari di spareggio, in cui più query SQL potevano legittimamente produrre risposte ugualmente valide.
Abbiamo inoltre osservato diversi comportamenti specifici del modello, tra cui conversioni di tipo non necessarie, gestione incoerente della distinzione tra maiuscole e minuscole e occasionale eccessiva complessità di query SQL altrimenti semplici. Questi risultati hanno rafforzato l'importanza di integrare meccanismi di validazione e autocorrezione nella pipeline di Data Agent.
Nel complesso, la nostra analisi ha dimostrato che molti degli errori rimanenti non erano causati da limitazioni del modello linguistico stesso, bensì da ambiguità nel benchmark o da casi limite nella generazione SQL. Ciò suggerisce che ulteriori miglioramenti nel recupero, nella validazione e nella gestione del contesto potrebbero spingere il sistema oltre la soglia del 90% di accuratezza di esecuzione.
Costo ed efficienza
L'elevata precisione è solo un aspetto di un sistema Text-to-SQL pronto per la produzione. Negli ambienti aziendali, i costi dell'infrastruttura, la privacy dei dati e la flessibilità di implementazione sono considerazioni altrettanto importanti.
Uno dei principali vantaggi del nostro approccio è che si basa interamente su modelli di linguaggio open-source. Durante l'intero processo di sviluppo, siamo stati in grado di eseguire la maggior parte degli esperimenti in locale utilizzando una RTX 4060 di fascia consumer (8 GB di VRAM) , il che ci ha permesso di iterare rapidamente senza incorrere in costi di API o token. I benchmark più complessi sono stati poi eseguiti su GPU cloud dedicate solo dopo la validazione dell'architettura.
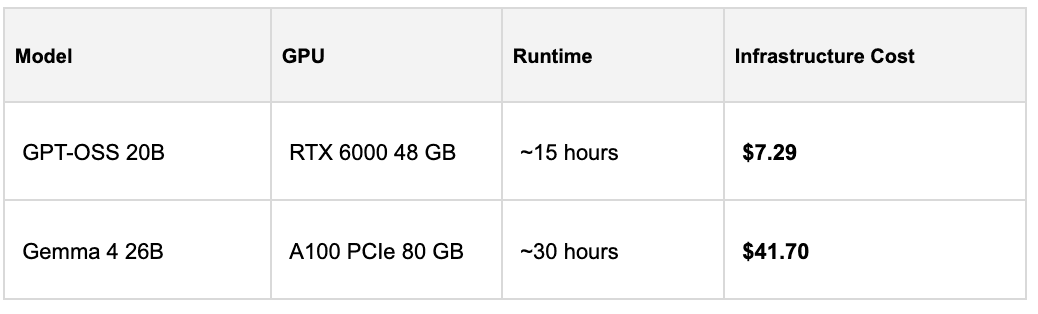
Per la valutazione completa di Spider 1.0 abbiamo utilizzato RunPod Secure Cloud. Il benchmark Gemma 4 26B è stato eseguito su una GPU A100 PCIe da 80 GB, mentre GPT-OSS 20B è stato eseguito su una GPU RTX 6000 da 48 GB.
I costi delle infrastrutture sono riassunti nella Tabella 4.
Sebbene i benchmark più complessi abbiano richiesto un'infrastruttura cloud, l'intero processo di sviluppo è rimasto economicamente vantaggioso grazie alla sperimentazione locale e ai modelli open-source. Ancora più importante, l'architettura risultante può essere implementata interamente all'interno dell'infrastruttura aziendale, eliminando la dipendenza da API esterne e garantendo un maggiore controllo sulla privacy dei dati, sulla conformità e sui costi operativi.
Ciò rende l'architettura particolarmente adatta alle organizzazioni che operano in ambienti sensibili alla privacy, regolamentati o isolati dalla rete, dove la sicurezza dei dati e la flessibilità di implementazione sono requisiti fondamentali.
Oltre Spider 1.0
I benchmark offrono un metodo oggettivo per valutare i sistemi di intelligenza artificiale, ma non rappresentano l'obiettivo finale. Un punteggio elevato in un benchmark è utile solo se si traduce in prestazioni affidabili nelle applicazioni reali.
Nel corso di questo studio, abbiamo scoperto che la creazione di un sistema Text-to-SQL pronto per la produzione va ben oltre la semplice generazione di codice SQL. La comprensione degli schemi del database, il recupero del contesto corretto, la convalida delle query generate e la correzione degli output errati si sono rivelati altrettanto importanti quanto il modello linguistico stesso.
La nostra accuratezza di esecuzione dell'88.15% su Spider 1.0 dimostra che i modelli open-source, combinati con un'architettura ben progettata, possono offrire prestazioni altamente competitive per le attività Text-to-SQL aziendali. Ancora più importante, convalida i principi di progettazione alla base del nostro Data Agent , che è stato creato per funzionare in modo affidabile su database aziendali complessi, e non solo su set di dati di benchmark.
Spider 1.0 rappresenta un traguardo importante, ma è solo l'inizio del nostro percorso. I prossimi passi includono la valutazione del Data Agent su Spider 2.0 , benchmark su scala aziendale più ampia e, soprattutto, ambienti clienti reali in cui gli schemi di database sono significativamente più grandi e le questioni aziendali sono molto più complesse.
La nostra visione a lungo termine non si limita a creare un generatore SQL migliore. Il nostro obiettivo è quello di realizzare Data Agent intelligenti che consentano alle organizzazioni di interagire con i dati aziendali con la stessa naturalezza con cui comunicano con un collega, combinando recupero, ragionamento, convalida e intelligenza artificiale interpretabile in un'affidabile piattaforma di supporto alle decisioni.
Lezioni chiave
Il benchmarking non riguarda solo la misurazione dell'accuratezza, ma anche la comprensione dei motivi per cui un sistema ha successo o fallisce.
Nel corso della nostra valutazione, abbiamo identificato diversi schemi di errore ricorrenti. Alcuni derivavano da ambiguità presenti nel benchmark stesso, tra cui incongruenze nelle query SQL di riferimento e condizioni di ordinamento non specificate correttamente. Altri riflettevano comportamenti comuni dei modelli LLM, come conversioni di tipo non necessarie o gestione incoerente dei valori sensibili alle maiuscole/minuscole.
Queste osservazioni hanno rafforzato uno dei risultati centrali del nostro lavoro: l'architettura è importante quanto la selezione del modello. Il recupero, il collegamento degli schemi, la validazione e l'autocorrezione hanno contribuito alle prestazioni finali tanto quanto il modello linguistico sottostante.
Sebbene le limitazioni del benchmark influenzino inevitabilmente il punteggio finale, la nostra analisi suggerisce che ulteriori miglioramenti nella gestione del contesto e nella convalida potrebbero spingere il sistema oltre la soglia del 90% di accuratezza di esecuzione.
Uno sguardo al futuro
Spider 1.0 ha fornito un'importante base di partenza per la valutazione del nostro Data Agent, ma rappresenta solo il primo passo verso un'intelligenza artificiale aziendale pronta per la produzione.
Il nostro prossimo obiettivo è valutare l'architettura su benchmark più impegnativi come Spider 2.0 e, soprattutto, su database aziendali reali in cui gli schemi sono significativamente più grandi, la documentazione è spesso incompleta e le questioni aziendali sono molto più complesse.
Il nostro obiettivo non è semplicemente quello di creare un altro sistema Text-to-SQL. Stiamo sviluppando agenti dati intelligenti che combinano recupero, ragionamento, convalida e interpretabilità per aiutare le organizzazioni a interagire con i dati aziendali in modo naturale e affidabile.
Referenze
[1] Saumya Chaturvedi, Aman Chadha, Laurent Bindschaedler arXiv. “SQL-of-Thought: Multi-agent Text-to-SQL with Guided Error Correction.” arXiv. Giugno 2026 https://arxiv.org/abs/2509.00581
[2] Dawei Gao, Haibin Wang, Yaliang Li, Xiuyu Sun, Yichen Qian, Bolin Ding, Jingren Zhou "Text-to-SQL potenziato da modelli linguistici di grandi dimensioni: una valutazione benchmark" arXiv. Giugno 2026