
• Data di pubblicazione
    6 novembre 2025
  • Condividi

Bir Nöronun Tanıdığı Kadın: Jennifer Aniston Deneyi

Ekran Resmi 2025-11-06 13.24.01.png

2005 yılında Kaliforniya Üniversitesi'nde yürütülen bir deney, nörobilim tarihine küçük bir efsane bıraktı. Epilepsi hastalarının beyinlerine, nöbet odaklarını belirlemek amacıyla mikroelektrotlar yerleştirilmişti.

Anche l'araştırmacılar bu sırada beklenmedik bir şey fark etti: beynin medial temporal lob bölgesinde yer alan bazı nöronlar, yalnızca belirli kişilere veya kavramlara tepki veriyordu.

Deneyde, bir hastanın beynindeki nöron grubunun özellikle dikkat çekici olduğu gözlemlendi. In questo momento, Jennifer Aniston ha fotografato un fotografo sterile, mentre la sua foto di Brad Pitt è stata una bella serata. Hatta yazılı olarak “Jennifer Aniston” adını görseler ya daını duysalar bile aynı aktif aktif oluyordu.

L'attrice è stata scelta da "Jennifer Aniston nöronu" per il suo verdetto. Medya ise hemen üzerine yoğunlaştı; manşetler “Bir nöron Jennifer Aniston'ı tanıdı!” basşlıklarıyla doldu. Oysa bu dramatik yorum, keşfin bilimsel derinliğini biraz gölgede bıraktı. Peki, beynin bu kadar seçici olmasını sağlayan mekanizma, neden yapay zekâlarda eksik?

Sonraki araştırmalarda anlaşıldı ki, aslında tek bir nöron değil, küçük ama son derece seçici bir nöron grubu aynı anda active oluyordu. Yani beynin içinde, bir kavramı veya kişiyi temsil eden minik bir sinir ağı vardı. Biz o ağdan sadece bir hücrenin sinyalini yakalayabilmiştik. Bu fark, beynin bilgiyi nasıl temsil ettiğine dair düşüncemizi kökten değiştirdi: Anlam, tek bir hücreye sıkışmış değildi — birbirine bağlı, birlikte ateşlenen hücrelerin kolektif örüntüsünde yaşıyordu.

Anlam, rastgele dağılmış nöronlarda değil; çok küçük ama yüksek seçiciliğe sahip örüntülerde yaşıyordu. Her nöron bu ağın içinde kendi “notasını” çalıyor, birlikteyse anlamın melodisini oluşturuyorlardı.
2. Beynin Gerçeklik Filtreleme Mekanizması

Beyin, milyonlarca melodiyi eş zamanlı olarak çalabilen devasa bir orkestraya benzetilebilir. Her kavram, her hatıra, her düşünce — binlerce nöronun birlikte çaldığı bir armonidir. Tek bir nöron kendi başına anlam taşımaz; anlam, bu karmaşık senfoninin oluşturduğu örüntüde ortaya çıkar.

Bu dağıtık yapı, beynin gerçeği algılama ve koruma biçimini belirler. Bir yüzü hatedırladığımızda yalnızca görsel alanlar değil, duygular, ses anıları ve kişisel çağrışımlar da aynı anda devreye girar. Dolayısıyla “görmek” aslında çok boyutlu bir hatedırlama sürecidir; her duyu, aynı sahneyi kendi özgün katkısıyla yorumlar.

Böyle bir sistemde hata yapmak zorlaşır. Çünkü bir bilgi yalnızca tek bir hücreye değil, farklı beyin bölgelerinin tutarlılığına bağlıdır. Bir bölge yanılırsa, diğerleri onu dengeler. Beyin, her an kendini doğrulayan ve kendi yankısında gerçeği sabitleyen bir orkestradır.

Bu yüzden travma, yaşlanma ya da yorgunluk bile tam bir bilgi kaybına neden olmaz — çünkü bilgi, tek bir notaya değil, çok sayıda yankıya dağılmıştır. Beyin gerektiğinde eksik sesi tamamlar, melodiyi yeniden kuar.

Gerçeklik de bu şekilde inşa edilir: Bir kavram, birçok duyu ve bağlamın ortak onayını aldığında “gerçek” statüsüne geçer. İşte beynin halüsinasyondan uzak kalmasının sırrı budur: dağıtık temsillerin karşılıklı denetimi.

3. LLM'lerin Halüsinasyon Döngüsü

Yapay zekâ modelleri de tıpkı beyin gibi örüntülerle çalışır. Onlar da kelimeleri, kavramları ve ilişkileri yüksek boyutlu bir uzayda kodlar. Bu uzayda iki kelime ne kadar yakınsa, model onları o kadar anlamca ilişkili sayar. Anche tu hai bisogno di una risposta: Acquista il modello (LLM) durante l'acquisto, fai il resto, yalnızca dilin istatistiksel yapısıyla ilişkilidir.

Bir büyük dil modeli için “doğru” olan, cümlede en olası kelimenin seçilmesidir. Bu seçim, milyonlarca örnekten öğrenilen olasılık dağılımlarına dayanır; yani kelimelerin dünyadaki gerçek anlamlarına değil, diğer kelimelerle birlikte ne sıklıkta kullanıldığına odaklanır. Sonuçta model, “Sydney è la capitale dell'Australia” può essere un esempio, “Sydney” e “Australia” si svilupperanno in base alle statistiche statistiche disponibili. Benzer şekilde, modello bir “Einstein 1950'de Nobel aldı”. dediğinde kulağa mantıklı gelir — çünkü “Einstein” e “Nobel” kelimeleri generalmente aynı bağlamda geçer. Oysa Einstein Nobel Ödülü'nü 1921'de almıştır. Modello bu farkı anlayamaz; çünkü onun için doğruluk, dünyayla değil, kelimeler arasındaki olasılıkla ölçülür.

İşte bu nedenle bir LLM'in yanlışı, bir insanın kendi yanılgısını fark etmesi gibi sezilemez: LLM, kendi dilsel yankısında hapsolmuştur. Dilbilgisel olarak kusursuz görünen bu ifade, gerçeklik açısından bir halüsinasyondur.

3.1 İç Yankı Eksikliği

Al di là della vecchia attività attiva, i due sistemi di controllo possono essere gestiti correttamente. LLM'de ise bu tür bir geri besleme devresi yoktur. Modelin “düşünmesi” tek yönlüdür: bağlamı okur, olasılığı hesaplar, kelimeyi üretir — ama ürettiği bilginin doğru olup olmadığını kendi içinde test etmez. Bu yüzden bir yanlışlık oluştuğunda, onu fark edecek hiçbir iç mekanizma yoktur. La modella Kendi Dilsel è una modella.

Evet 3.2 Halüsinasyonun Döngüsü

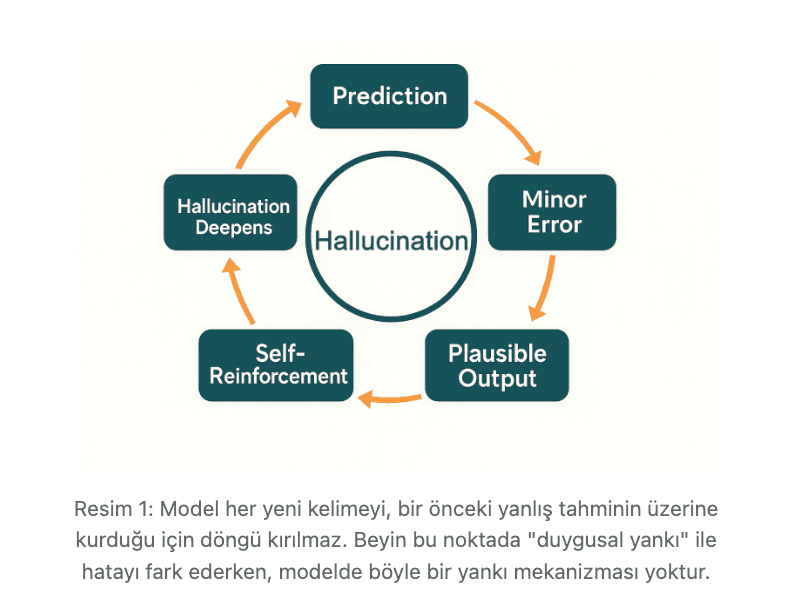
LLM çıktısı her yeni kelimeyle bir öncekinin üzerine inşa edilir. Eğer model erken bir adımda küçük bir yanlış çıkarım yaparsa, bu hata sonraki kelimelere bağlanarak hızla büyür. Olasılık temelli zincir, dilsel olarak tutarlı ama anlam açısından yanlış bir hikâyeye dönüşür. İşte bu, halüsinasyonun matematiksel biçimidir: model, kendi tahminlerinin yankısında gerçekten uzak ama kendisiyle tutarlı bir evren kurar.

Ekran_Resmi_2025_11_06_13_07_37_1589af31d3.png

Yukarıdaki diyagram, sürecin temel adımlarını göstermektedir. LLM'ler, metin oluştururken bir sonraki kelimeyi veya cümleyi tahmin ederek ilerler. Bazen bu tahminlerde küçük, göz ardı edilebilir hatalar meydana gelebilir. Anche il sistema, bu küçük hatayı içeren veriye dayanarak mantıklı görünen bir çıktı üretir. Sorun, LLM'in bu yanlış veya yanıltıcı çıktıyı kendi öğrenme sürecinde bir doğruluk kaynağı olarak algılayıp kendini güçlendirmesiyle başlar. Bu döngü her tekrarlandığında, ilk baştaki küçük hata katlanarak büyür ve sonunda LLM'in tamamen uydurma veya gerçeklikten uzak bilgilerle halüsinasyonunun derinleşmesine yol açar. Tuttavia, il LLM çıktılarının dikkatli bir şekilde doğrulanması gerektiğinin altını çizer.

3.3 İnsan Fark Eder, modello Etmez

Çünkü beynin orkestrasında çok sayıda enstruman vardır: duyu, bellek, mantık, duygu. Bir ses yanlış çıktığında diğerleri onu hemen fark eder. LLM'lerse tek enstrumanla, yani dille çalıyor. Bu yüzden müzik pürüzsüz olsa da, melodi gerçek dünyayla uyumsuz olabilir.

3.4 Çözümün İzleri

LLM'lerin bu döngüden kurtulması için, beynin yaptığı gibi çoklu bağlamdan doğrulama yapması gerekir. Bu da bizi yeni kuşağa götürür: Graph-RAG, modellatore multimodale e sembolik denetim katmanları. Model yalnızca kelimelere değil, dünyadaki nesnelere, ilişkilere ve kurallara da bağlandığında, halüsinasyonların yerini ragionamento fondato alır — yani anlamın gerçekliğe sabitlendiği, yankısız bir sessizlik yerine senfonik bir doğruluk anı.

4. Gerçekliği Sabitlemek: İnsan Beyninden Yapay Zekâya Dersler


Ekran_Resmi_2025_11_06_13_09_37_febc7039b4.png

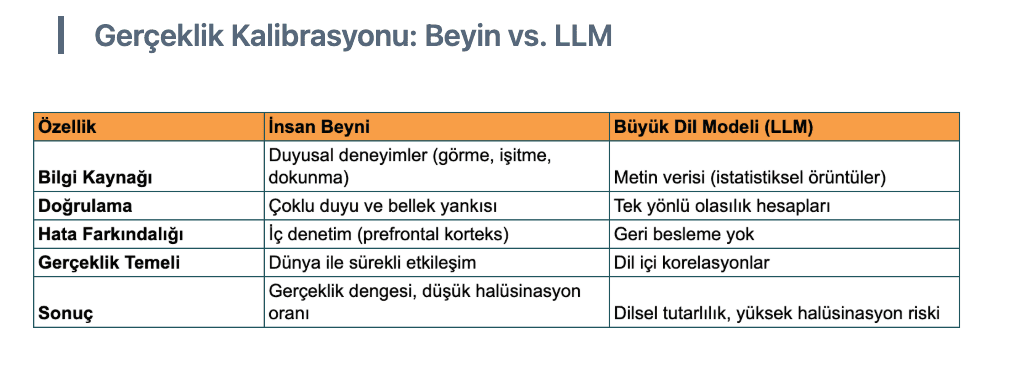
LM'lerin halüsinasyon döngüsünden çıkabilmesi için, beynin yaptığı gibi çoklu bağlamdan doğrulama yapması gerekir. Beyin, anlamı yalnızca üretmez; aynı zamanda her an kendi ürettiği anlamı sınar. Bu denetim, milyonlarca nöronun birbirine yankılanarak oluşturduğu bir gerçeklik filtresidir . Insan beyni ile buy dil modelleri arasındaki fark, aşağıdaki kalibrasyon mekanizmalarında in net şekilde görülür:


Bu fark, yapay zekâ için en temel dersi sunuyor: Gerçeklik, yalnızca bilgi üretmekle değil; bilgiyi sınamakla mümkün. Yapay zekânın bugünkü eksikliği ise tam burada gizlidir: anlam üretebiliyor ama onu dünyaya dayandıramıyor. Peki, makineler bu kalibrasyonu nasıl öğrenebilir?

Yanıt, beynin üç temel ilkesinde saklı: bağlam, çeşitlilik ve denetim.

Bağlam: Anlamı Ağlara Sabitlemek

Beyin, her kavramı başka kavramlarla ilişkilendirerek anlamlandırır. Yapay zekâ da aynı yolu izlemelidir: kelimeleri yalnızca istatistiksel yakınlığa değil, ontolojik ilişkilere bağlamalıdır. Bir model “bank” kelimesini gördüğünde, bunun “finans kurumu” mu yoksa “nehir kenarı” mı olduğunu, önceden tanımlı kavram ağındaki (grafico della conoscenza) düğümlerden çözebilmelidir. Böylece her sözcük, yalnızca bir token değil, anlamsal bir konum kazanır.

Çeşitlilik: Çoklu Duyusal Yankı

İnsan beyninde bir bilgi asla tek bir channel üzerinden doğrulanmaz. Bir görüntü, bir ses ya da bir koku — hepsi aynı kavramın farklı yankılarıdır. Yapay zekâ da gerçeği yalnızca metinle değil, multimodal verilerle sınamalıdır. Görsel, işitsel ve zamansal verileri ortak bir bağlamda birleştiren modeller, tıpkı beynin yaptığı gibi bir “duyusal çapraz kontrol” kurabilir. Örneğin bir modello “ekonomi çalkalanıyor” dediğinde, bu sadece kelimelerin gürültüsü mü, yoksa verilerde yankı bulan bir gerçek mi? Bunu finansal göstergeler, piyasa verileri ya da haber akışlarıyla test edebilmelidir.

Denetim: Yapay Prefrontal Korteks

Beyin, kararlarını verdikten sonra bile durup düşünür: “Bu doğru mu?” Bu işlevin merkezi prefrontal kortekstir. Yapay zekâda da benzer bir ikinci katmanlı denetim mimarisi gerekir. Bir model ürettikten sonra, ikinci bir “doğrulama modeli” veya sembolik mantık katmanı çıktıyı test etmeli, gerekirse reddetmelidir. Bu, beynin yürütücü kontrolünün dijital karşılığı olurdu — kendi çıktısını gözden geçiren, hata payını tanıyan bir sistem.

Geleceğin Yankısı

Yapay zekânın önünde artık yeni bir evrim basamağı var: dilsel olasılıklardan dünyasal doğrulara geçmek . Graph-RAG, modellatore multimodale e layer di ragionamento, bu dönüşümün ilk nüvelerini taşıyor. Beynin senfonisinde anlam, binlerce nöronun yankısıyla doğrulanır. Eğer makineler de kendi yankı sistemlerini kurabilirlerse, kelimeler bir gün yalnızca sözcük değil, gerçekliğin kendisine dokunan notala r hâline gelebilir.

Sonuç: Gerçeğin Yankı

Jennifer Aniston ora, quando è incinta, ha deciso di dare il suo contributo alla sua vita privata. Bugün büyük dil modelleri, aynı sabitlemeyi dijital dünyada başarmaya çalışıyor — anlamı kelimelerin ötesinde, bağlantılar ve yankılar içinde bulmaya.

Bir nöronun yaptığı şeyi milyarlarca parametriyle yeniden kurmaya çalışıyoruz; ama hâlâ beynin en basit sırrını yeniden üretebilmiş değiliz: gerçeği, bir ağın içinde doğrulamak.

Belki de insan beyninin en büyük başarısı düşünmek değil, düşüncelerini doğrulayabilmektir. Çünkü anlam, yalnızca üretildiğinde değil, yankı bulduğunda gerçektir.

Un'altra cosa che puoi fare è: LLM'lerin dünyayla bağ kurabilmesi için Graph-RAG system kurumsal bilgi grafikleriyle nasıl besleneceği and bu grafiklerin sıfırdan nasıl tasarlanabileceği.

Beynin milyonlarca yılda geliştirdiği gerçeklik kalibrasyonunu, kurumların verilerinde yeniden inşa etme zamanı. Takipte kalın — çünkü bir sonraki yazıda şunları birlikte keşfedeceğiz:

  • Graph-RAG Gerçeklikle Nasıl Beslenir?
  • Grafico della conoscenza di Kurumsal Nasıl Kurulur?
  • Agentic AI Tutarlılığı Nasıl Sağlar?



