בניית מערכת טקסט-ל-SQL מוכנה לייצור: השגת 88.15% ב-Spider 1.0
פרסם תאריך
13 ביולי 2026
שיתוף
תקציר מנהלים
בניית מערכת טקסט-ל-SQL מוכנה לייצור דורשת הרבה יותר מאשר יצירת SQL עם מודל שפה גדול. יישומים ארגוניים דורשים הבנה מדויקת של סכמות, אחזור הקשר, אימות ותיקון שגיאות כדי לייצר תוצאות אמינות על מסדי נתונים שלא נראו קודם לכן.
במחקר זה, אנו מבצעים השוואה בין סוכן הנתונים שלנו ל- Spider 1.0 והשגנו דיוק ביצוע של 88.15% באמצעות מודל Gemma 4 26B . במקום להתמקד אך ורק בציוני השוואה, מאמר זה משתף את ההחלטות האדריכליות, לקחים הנדסיים ותובנות השוואה העומדות מאחורי תוצאות אלו.
מעבר ליצירת SQL
מודלים גדולים של שפות שיפרו משמעותית את יצירת ה-SQL, אך בניית מערכת Text-to-SQL מוכנה לייצור דורשת הרבה יותר מתרגום שפה טבעית ל-SQL. יישומים ארגוניים חייבים להבין סכמות מורכבות של מסדי נתונים, לאחזר את ההקשר הנכון, לאמת שאילתות שנוצרו ולייצר תוצאות אמינות על מסדי נתונים שמעולם לא ראו קודם לכן.
כדי להעריך את היכולות הללו, ערכנו בדיקת ביצועים של סוכן הנתונים שלנו על Spider 1.0, מדד הביצועים הנפוץ ביותר של Text-to-SQL. באמצעות מודל Gemma 4 26B , המערכת שלנו השיגה דיוק ביצוע של 88.15% , מה שמראה כי ארכיטקטורה וניהול הקשר חשובים לא פחות מבחירת המודל.
למה ספיידר 1.0?
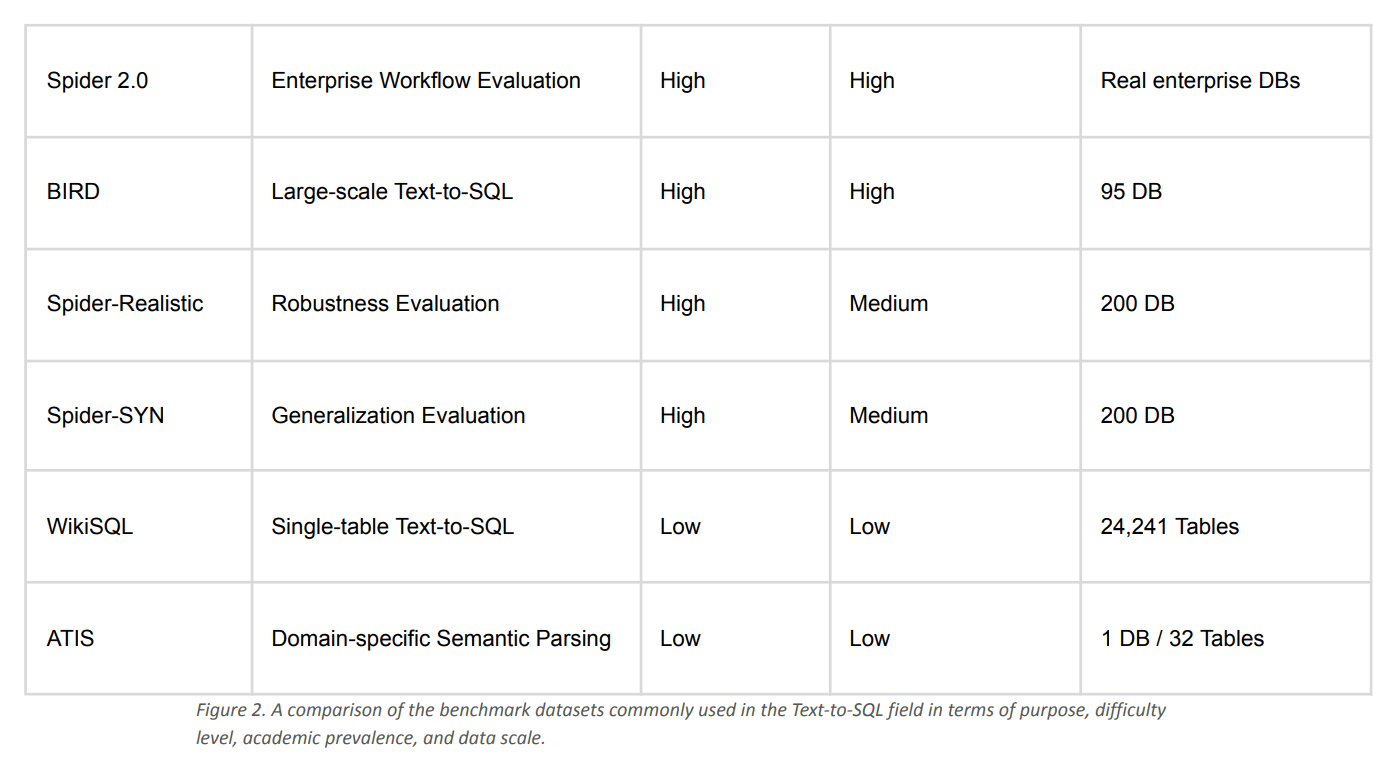
בחירת מדד הביצועים הנכון חשובה לא פחות מבחירת המודל הנכון. בעוד שמערכות נתונים חדשות יותר כמו Spider 2.0 ו-BIRD מציגות תרחישים ארגוניים מורכבים יותר, Spider 1.0 נותר מדד הביצועים הנפוץ ביותר להערכת מערכות Text-to-SQL ולהשוואת תוצאות בספרות.
לצורך ההערכה הראשונית שלנו, בחרנו ב-Spider 1.0 משום שהוא מספק בסיס סטנדרטי ומבוסס היטב. הוא מאפשר לנו למדוד עד כמה סוכן הנתונים שלנו מבין סכמות מסד נתונים שלא נראו קודם לכן ויוצר SQL נכון בתנאים מציאותיים.
איור 2 מסכם כיצד Spider 1.0 משתווה למדדי ביצועים נפוצים אחרים של Text-to-SQL.
בניית סוכן הנתונים
השגת דיוק גבוה של טקסט ל-SQL אינה רק עניין של שימוש במודל שפה גדול יותר. לאורך תהליך הבדיקה שלנו, מצאנו כי לארכיטקטורה ולניהול ההקשר הייתה השפעה גדולה יותר על הביצועים מאשר לבחירת מודל בלבד.
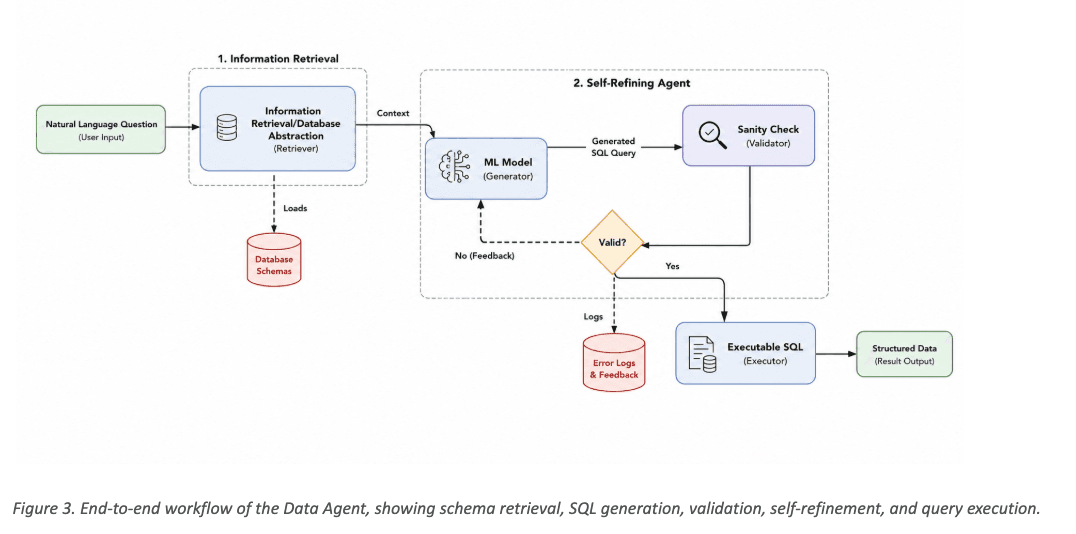
סוכן הנתונים שלנו מתוכנן כצינור רב-שלבי שמצמצם בהדרגה את הבעיה לפני שהוא מתבקש מה-LLM לייצר SQL. במקום לחשוף את כל סכמת מסד הנתונים למודל, המערכת מאחזרת תחילה רק את הסכימה הרלוונטית ואת המידע ההקשרי, לאחר מכן מייצרת שאילתת SQL, מאמתת את התוצאה ומתקנת אוטומטית שגיאות נפוצות לפני הביצוע.
כפי שמודגם באיור 3 , הארכיטקטורה מורכבת משלושה שלבים עיקריים:
אִחזוּר מֵידַע – שאלת המשתמש מנותחת כדי לזהות את אובייקטי מסד הנתונים הרלוונטיים, ורק פרטי הסכימה הדרושים מאוחזרים ממאגר המטה-דאטה.
סוכן זיקוק עצמי – מודל השפה מייצר SQL, מאמת את השאילתה מול הסכימה שאוחזרה, ומשפר אותה אוטומטית בכל פעם שהאימות נכשל.
ביצוע ותגובה – לאחר האימות, שאילתת ה-SQL מבוצעת מול מסד הנתונים של היעד, והתוצאות מוחזרות כנתונים מובנים או כתגובה בשפה טבעית.
ארכיטקטורה זו, המוכוונת ייצור, נוצרה בהשראת רעיונות שהוצגו ב- DIN-SQL וב- DAIL-SQL , תוך שהיא מותאמת לסביבות ארגוניות בהן אמינות, הסבר ועמידות חשובים לא פחות מדיוק ביצועים.
מסע השוואת הביצועים שלנו
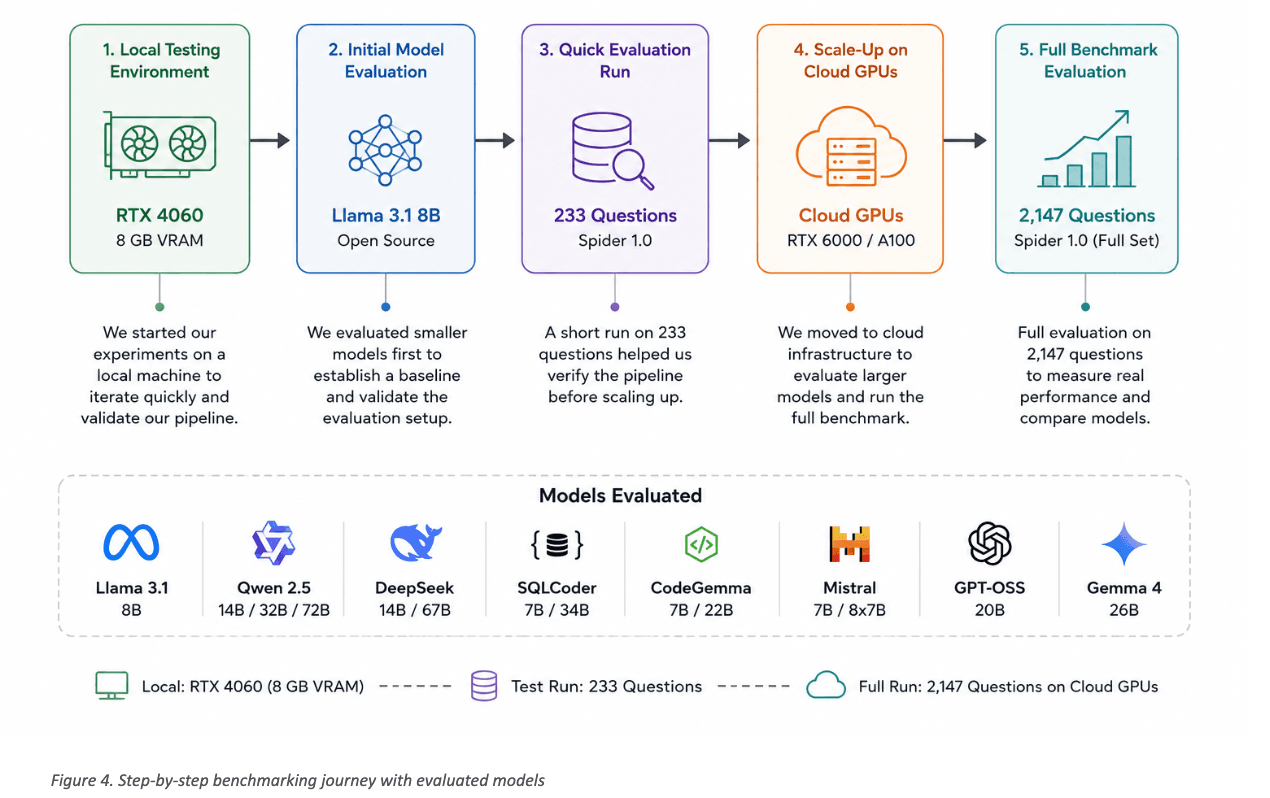
בחירת מודל השפה הנכון הייתה חלק חשוב מתהליך הביצועים שלנו. במקום להעריך מודל בודד, התנסינו במגוון רחב של תוכניות לימודי תואר שני (LLM) בקוד פתוח, כולל Llama 3.1, Qwen 2.5, DeepSeek, SQLCoder, CodeGemma, Mistral, GPT-OSS ו- Gemma 4.
כדי להבטיח השוואה הוגנת, הערכנו כל מודל באמצעות Execution Accuracy (EA) , המדד הסטנדרטי לביצוע השוואות של טקסט ל-SQL. בניגוד למדדים מבוססי תחביר, Execution Accuracy מודד האם ה-SQL שנוצר מחזיר את אותה תוצאה כמו שאילתת ההפניה, מה שהופך אותו למדד טוב יותר לביצועים בעולם האמיתי.
מסע הביצועים שלנו מתואר באיור 4. התחלנו בניסוי בתחנת עבודה מקומית המצוידת בכרטיס מסך RTX 4060 (8 ג'יגה-בייט VRAM) , שם מודלים קטנים יותר אפשרו לנו לבצע איטרציות מהירות ולאמת את הצינור שלנו. לאחר יצירת קו בסיס יציב באמצעות תת-קבוצה של 233 שאלות Spider 1.0, עברנו למעבדי גרפיקה בענן כדי להעריך מודלים גדולים יותר על גבי ביצועי הביצועים המלאים, המכילים 2,147 שאלות . גישה מדורגת זו אפשרה לנו לייעל את הארכיטקטורה ביעילות לפני השקעה בהרצות ביצועים בקנה מידה גדול.
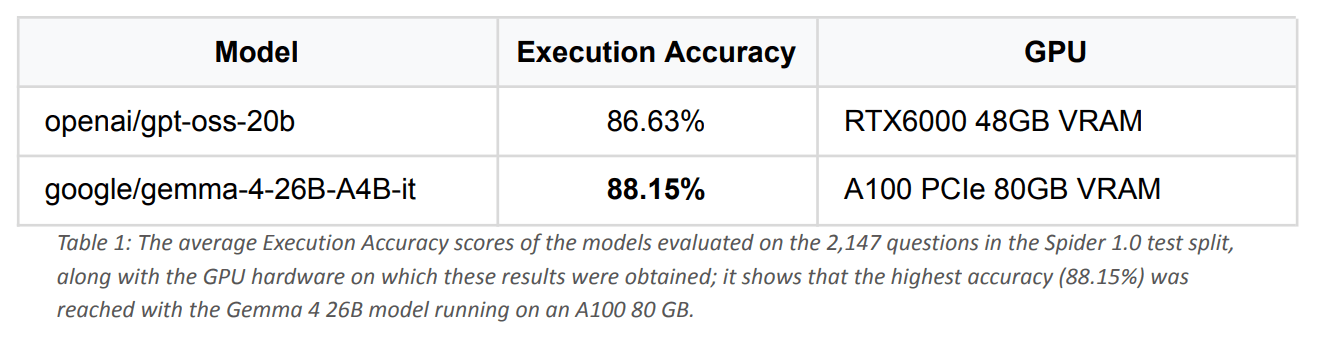
הערכנו את המודלים הסופיים על סבב המבחן המלא של Spider 1.0, שהכיל 2,147 שאלות. כפי שמוצג בטבלה 1, Gemma 4 26B השיגה את הציון הגבוה ביותר (88.15%), ואחריה GPT-OSS 20B (86.63%). תוצאות אלו מראות כי תוכניות LLM מודרניות בקוד פתוח, בשילוב עם צינור אחזור ואימות יעיל, יכולות להשיג ביצועי Text-to-SQL תחרותיים ביותר.
כיצד ניתן להשוות תוצאות אלו?
ציוני בנצ'מרק משמעותיים רק כאשר ניתן להשוות אותם לעבודות שפורסמו בעבר. כדי להבין טוב יותר את משמעות התוצאות שלנו, סקרנו הן מחקרים אחרונים של Text-to-SQL והן מאמרי בנצ'מרק שזכו להתייחסות נרחבת.
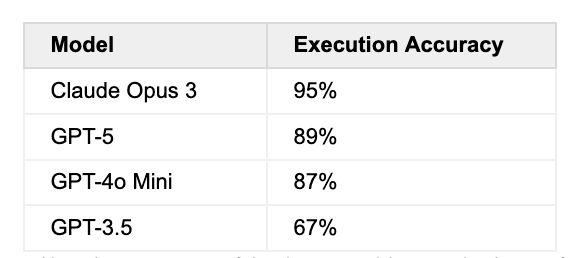
טבלה 2: שיעורי הדיוק של מודלים בקוד סגור שדווחו במחקר SQL-of-Thought על תת-קבוצה של מערך הנתונים של Spider; היא מראה, במונחים השוואתיים, שהתוצאה של 88.15% שהתקבלה בעבודה זו ממוקמת מעל GPT-4o Mini (87%) וברמה הקרובה ל-GPT-5 (89%).
עבודות עדכניות כמו SQL-of-Thought [1] מדווחות כי מודלים מובילים בקוד סגור - כולל Claude Opus 3, GPT-5 ו- GPT-4o Mini - משיגים דיוק גבוה בתת-קבוצות של ספיידר. בעוד שיש לפרש השוואות ישירות בזהירות עקב הבדלים בהגדרות הערכה, הנחיות ותת-קבוצות של סיכות, דיוק הביצוע שלנו, שעומד על 88.15% , מדגים כי מודלים בקוד פתוח יכולים להשיג ביצועים באותו טווח תחרותי.
למרות שתוצאות אלו מגיעות מהגדרות הערכה שונות ואין להשוות ביניהן ישירות, הן מספקות הקשר שימושי להבנת נוף הביצועים הנוכחי של מערכות Text-to-SQL. מבחן הייחוס שלנו מדגים שמודלים בקוד פתוח יכולים כעת להתחרות בחלופות מובילות בקוד סגור כאשר הם משולבים עם ארכיטקטורה מעוצבת היטב.
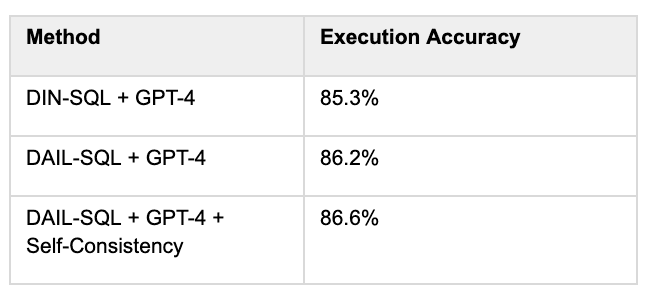
כמו כן, השווינו את תוצאותינו עם מסגרות טקסט-ל-SQL מכוונות ייצור כגון DIN-SQL [3] ו- DAIL-SQ L, המשלבות מודלים של שפות גדולות עם טכניקות הכוללות קישור סכמות, הנדסת הנחיות, עקביות עצמית ותיקון שגיאות.
טבלה 3: תוצאות דיוק הביצוע של שיטות שונות ב-Spider 1.0 במחקר "Text-to-SQL Empowered by Large Language Models: A Benchmark Evaluation" [2]; היא חושפת את ההשפעה על הדיוק לא רק של בחירת המודל אלא גם של טכניקות כגון הנדסת הנחיות, קישור סכמות ועקביות עצמית.
ממצאינו מחזקים מסקנה משותפת בספרות האחרונה: ביצועים גבוהים של טקסט-ל-SQL תלויים לא רק במודל השפה, אלא גם בארכיטקטורה שמסביב. אחזור סכמות יעיל, ניהול הקשר, אימות ותיקון עצמי חשובים לעתים קרובות לא פחות מהמודל עצמו.
מה שלמדנו
ביצועי השוואה אינם עוסקים רק במדידת דיוק - הם גם בהבנת היכן ומדוע מערכת נכשלת. במהלך ההערכה שלנו, ניתחנו תחזיות שגויות וזיהינו מספר דפוסים חוזרים שהשפיעו על הציונים הסופיים.
חלק מהשגיאות נבעו ממבחן הביצועים עצמו. במספר קטן של מקרים, חוסר עקביות בשאילתות ה-SQL של הייחוס (זהב) גרמו לסימון תחזיות נכונות מבחינה לוגית כשגויות. מקרים אחרים כללו שאלות דו-משמעיות בשפה טבעית או תרחישים שובר שוויון, שבהם שאילתות SQL מרובות יכלו להניב תשובות תקפות באותה מידה.
כמו כן, צפינו במספר התנהגויות ספציפיות למודל, כולל המרות סוג מיותרות, טיפול לא עקבי ברגישות לאותיות גדולות וסיבוך מדי פעם של שאילתות SQL פשוטות בדרך כלל. ממצאים אלה חיזקו את החשיבות של שילוב מנגנוני אימות ותיקון עצמי בצינור של סוכן הנתונים.
בסך הכל, הניתוח שלנו הראה כי שגיאות רבות שנותרו לא נגרמו עקב מגבלות של מודל השפה עצמו, אלא עקב עמימות במקרי הביצוע או במקרי הקצה ביצירת SQL. ממצא זה מצביע על כך ששיפורים נוספים באחזור, אימות וניהול הקשר עשויים לדחוף את המערכת מעבר לסף דיוק הביצוע של 90%.
עלות ויעילות
דיוק גבוה הוא רק היבט אחד של מערכת טקסט-ל-SQL מוכנה לייצור. בסביבות ארגוניות, עלות התשתית, פרטיות הנתונים וגמישות הפריסה הן שיקולים חשובים לא פחות.
אחד היתרונות המרכזיים של הגישה שלנו הוא שהיא מסתמכת לחלוטין על מודלים של שפות קוד פתוח. לאורך תהליך הפיתוח, הצלחנו לבצע את רוב הניסויים באופן מקומי באמצעות RTX 4060 ברמה צרכנית (8 ג'יגה-בייט VRAM) , מה שאפשר לנו לבצע איטרציות מהירות מבלי לשלם עלויות API או טוקנים. ריצות ביצועים גדולות יותר בוצעו לאחר מכן על גבי מעבדי גרפיקה ייעודיים לענן רק לאחר שהארכיטקטורה אומתה.
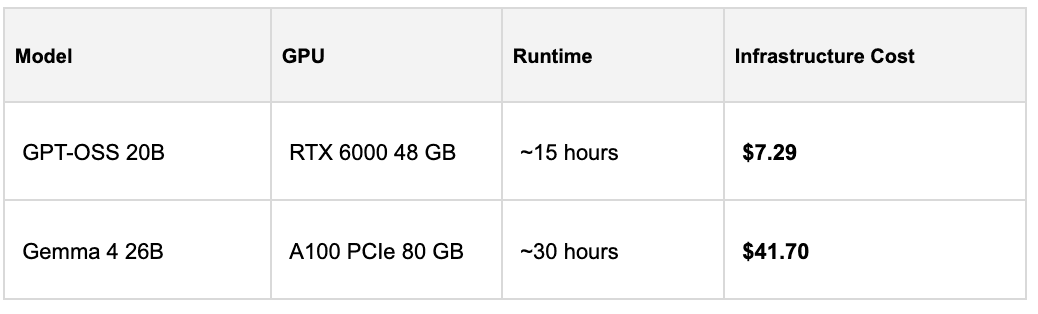
השתמשנו ב-RunPod Secure Cloud עבור ההערכה המלאה של Spider 1.0. מבחן Gemma 4 26B בוצע על כרטיס מסך A100 PCIe בנפח 80 גיגה-בייט, בעוד ש-GPT-OSS 20B רץ על כרטיס מסך RTX 6000 בנפח 48 גיגה-בייט.
עלויות התשתית מסוכמות בטבלה 4.
למרות שהרצות הבנצ'מרק הגדולות ביותר דרשו תשתית ענן, תהליך הפיתוח הכולל נותר חסכוני הודות לניסויים מקומיים ולמודלים של קוד פתוח. חשוב מכך, ניתן לפרוס את הארכיטקטורה המתקבלת במלואה בתוך התשתית של הארגון עצמו, ובכך לבטל את התלות ב-API חיצוניים תוך מתן שליטה רבה יותר על פרטיות הנתונים, תאימות ועלויות התפעול.
זה הופך את הארכיטקטורה למתאימה במיוחד לארגונים הפועלים בסביבות רגישות לפרטיות, מוסדרות או עם פערים מבודדים, שבהן אבטחת נתונים וגמישות פריסה הן דרישות קריטיות.
מעבר לעכביש 1.0
מדדי ביצועים מספקים דרך אובייקטיבית להערכת מערכות בינה מלאכותית, אך הם אינם המטרה הסופית. ציון ביצועים גבוה הוא בעל ערך רק אם הוא מתורגם לביצועים אמינים ביישומים בעולם האמיתי.
לאורך מחקר זה, מצאנו שבניית מערכת טקסט-ל-SQL מוכנה לייצור היא הרבה יותר מאשר יצירת SQL. הבנת סכמות מסד נתונים, אחזור ההקשר הנכון, אימות שאילתות שנוצרו ועידון פלטים שגויים הוכחו כחשובים לא פחות ממודל השפה עצמו.
דיוק הביצוע שלנו , 88.15%, ב-Spider 1.0 מדגים שמודלים בקוד פתוח, בשילוב עם ארכיטקטורה מעוצבת היטב, יכולים לספק ביצועים תחרותיים ביותר עבור משימות Text-to-SQL ארגוניות. וחשוב מכך, זה מאמת את עקרונות העיצוב העומדים מאחורי סוכן הנתונים שלנו , שנבנה לפעול בצורה אמינה על מסדי נתונים ארגוניים מורכבים ולא רק על מערכי נתונים מבוססי ביצועים.
Spider 1.0 מייצג אבן דרך חשובה, אך זוהי רק תחילת המסע שלנו. הצעדים הבאים שלנו כוללים הערכת סוכן הנתונים על Spider 2.0 , מבחני ביצועים גדולים יותר בקנה מידה ארגוני, וחשוב מכל, סביבות לקוחות אמיתיות שבהן סכמות מסדי נתונים גדולות משמעותית ושאלות עסקיות מורכבות הרבה יותר.
החזון ארוך הטווח שלנו אינו רק לבנות מחולל SQL טוב יותר. אנו שואפים לבנות סוכני נתונים חכמים המאפשרים לארגונים לתקשר עם נתוני ארגון באופן טבעי כמו שהם מתקשרים עם עמית - שילוב של אחזור נתונים, הנמקה, אימות ובינה מלאכותית ניתנת להסבר לכדי פלטפורמה אמינה לתמיכה בקבלת החלטות.
שיעורי מפתח
ביצועים וביצועים אינם עוסקים רק במדידת דיוק - אלא בהבנת הסיבות לכך שמערכת מצליחה או נכשלת.
במהלך ההערכה שלנו, זיהינו מספר דפוסי שגיאה חוזרים. חלקם נבעו מחוסרי ודאות במבחן עצמו, כולל חוסר עקביות בשאילתות SQL להפניה ותנאי סידור שלא פורטו כראוי. אחרים שיקפו התנהגויות נפוצות ב-LLM, כגון עיבוד סוגים מיותר או טיפול לא עקבי בערכים תלויי רישיות.
תצפיות אלו חיזקו את אחד הממצאים המרכזיים של עבודתנו: ארכיטקטורה חשובה לא פחות מבחירת מודל. אחזור, קישור סכמות, אימות ותיקון עצמי תרמו לביצועים הסופיים לא פחות ממודל השפה הבסיסי.
בעוד שמגבלות של ביצועי ביצועים משפיעות באופן בלתי נמנע על הציון הסופי, הניתוח שלנו מצביע על כך ששיפורים נוספים בניהול ההקשר ובאימות עשויים לדחוף את המערכת מעבר לרף דיוק הביצוע של 90%.
מבט לעתיד
Spider 1.0 סיפק בסיס חשוב להערכת סוכן הנתונים שלנו, אך הוא מייצג רק את הצעד הראשון לקראת בינה מלאכותית ארגונית מוכנה לייצור.
המיקוד הבא שלנו הוא להעריך את הארכיטקטורה על גבי מדדי ביצועים מאתגרים יותר כמו Spider 2.0 , וחשוב מכך, על גבי מסדי נתונים ארגוניים אמיתיים שבהם הסכמות גדולות משמעותית, התיעוד לרוב אינו שלם ושאלות עסקיות מורכבות הרבה יותר.
המטרה שלנו אינה רק לבנות עוד מערכת טקסט-ל-SQL. אנו בונים סוכני נתונים חכמים המשלבים אחזור, הנמקה, אימות והסבר כדי לעזור לארגונים לתקשר עם נתוני ארגון באופן טבעי ואמיין.