• 公開日
    13年2026月XNUMX日
  • シェアする
エクラン・レスミ 2026-07-10 15.13.39.png

エグゼクティブサマリー

本番環境で使用可能なテキストベースのSQLシステムを構築するには、大規模な言語モデルでSQLを生成するだけでは不十分です。エンタープライズアプリケーションでは、これまで見たことのないデータベースに対しても信頼性の高い結果を得るために、正確なスキーマ理解、コンテキストの取得、検証、およびエラー訂正が求められます。

本研究では、Spider 1.0上でデータエージェントのベンチマークを行い、Gemma 4 26Bモデルを用いて88.15%の実行精度を達成しました。本稿では、ベンチマークスコアのみに焦点を当てるのではなく、これらの結果の背景にあるアーキテクチャ上の決定、エンジニアリング上の教訓、およびベンチマークに関する洞察を共有します。

SQL生成を超えて

SQL生成を超えて

大規模言語モデルによってSQL生成は大幅に改善されましたが、実運用可能なテキスト-SQLシステムを構築するには、自然言語をSQLに変換するだけでは不十分です。エンタープライズアプリケーションは、複雑なデータベーススキーマを理解し、適切なコンテキストを取得し、生成されたクエリを検証し、これまで見たことのないデータベースでも信頼性の高い結果を生成する必要があります。

これらの機能を評価するため、最も広く使用されているテキストtoSQLベンチマークであるSpider 1.0で、当社のデータエージェントのベンチマークテストを実施しました。Gemma 4 26Bモデルを使用した場合、当社のシステムは88.15%の実行精度を達成し、アーキテクチャとコンテキスト管理がモデル選択と同様に重要であることを実証しました。

なぜSpider 1.0なのか?

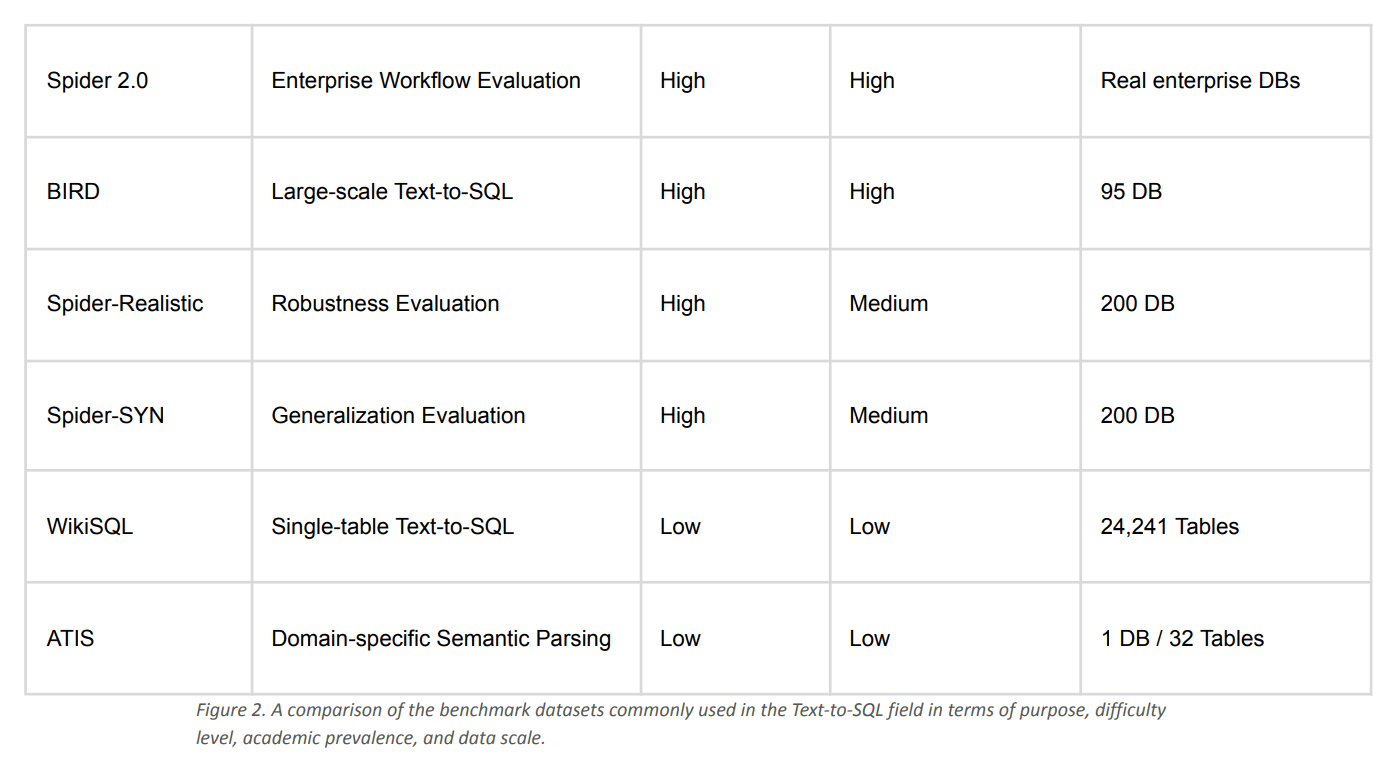
適切なベンチマークを選択することは、適切なモデルを選択することと同じくらい重要です。Spider 2.0やBIRDといった新しいデータセットは、より複雑な企業シナリオを提示していますが、Spider 1.0は、テキストからSQLへのシステムを評価し、文献間で結果を比較するための最も広く採用されているベンチマークです。

エクラン・レスミ 2026-07-13 15.13.56.png

最初の評価では、標準化され確立された基準となるSpider 1.0を選択しました。これにより、データエージェントがこれまで見たことのないデータベーススキーマをどれだけ効果的に理解し、現実的な条件下で正しいSQLを生成できるかを測定できます。

図2は、Spider 1.0と他の一般的に使用されているテキストからSQLへの変換ベンチマークとの比較をまとめたものです。

データエージェントの構築

テキストからSQLへの変換精度を高めるには、単に大規模な言語モデルを使用するだけでは不十分です。ベンチマークテストを実施した結果、モデル選択のみよりも、アーキテクチャとコンテキスト管理の方がパフォーマンスに大きな影響を与えることが分かりました。

エクラン・レスミ 2026-07-10 15.31.28.png

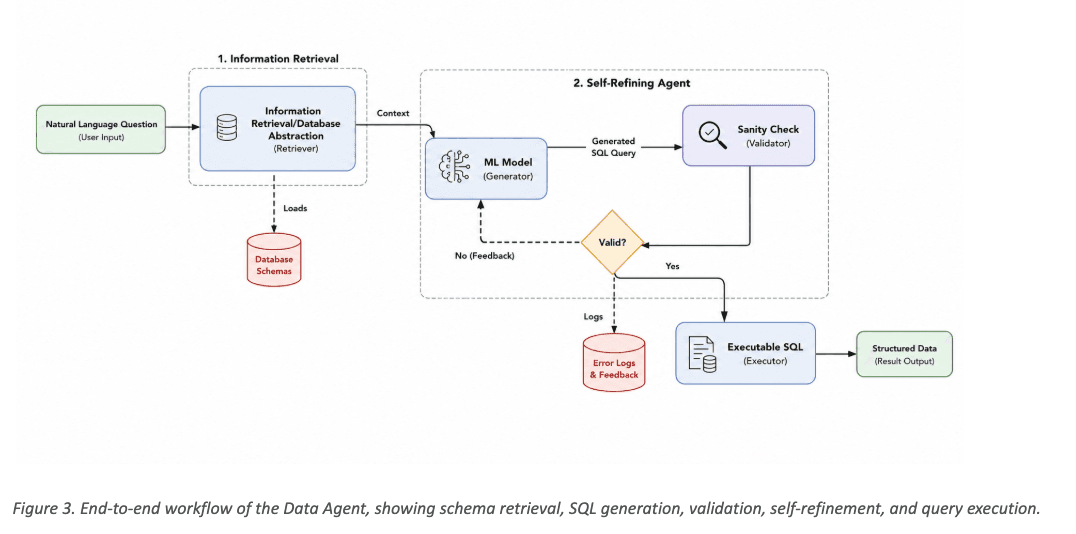
当社のデータエージェントは、LLMにSQL生成を依頼する前に問題を段階的に絞り込む多段階パイプラインとして設計されています。データベーススキーマ全体をモデルに公開するのではなく、システムはまず関連するスキーマとコンテキスト情報のみを取得し、次にSQLクエリを生成し、結果を検証し、実行前に一般的なエラーを自動的に修正します。

図3に示すように、このアーキテクチャは主に3つの段階から構成されています。

  • 情報検索 ユーザーの質問を分析して関連するデータベースオブジェクトを特定し、メタデータストアから必要なスキーマ情報のみを取得します。
  • 自己精製剤 言語モデルはSQLを生成し、取得したスキーマに対してクエリを検証し、検証が失敗した場合は自動的にクエリを修正します。
  • 実行と対応 検証が完了すると、SQLクエリが対象データベースに対して実行され、結果は構造化データまたは自然言語による応答として返されます。

この実運用指向のアーキテクチャは、DIN-SQLDAIL-SQLで導入されたアイデアに着想を得ており、信頼性、説明可能性、堅牢性がベンチマーク精度と同様に重要なエンタープライズ環境向けに調整されています。

ベンチマークの取り組み

エクラン・レスミ 2026-07-10 15.32.47.png

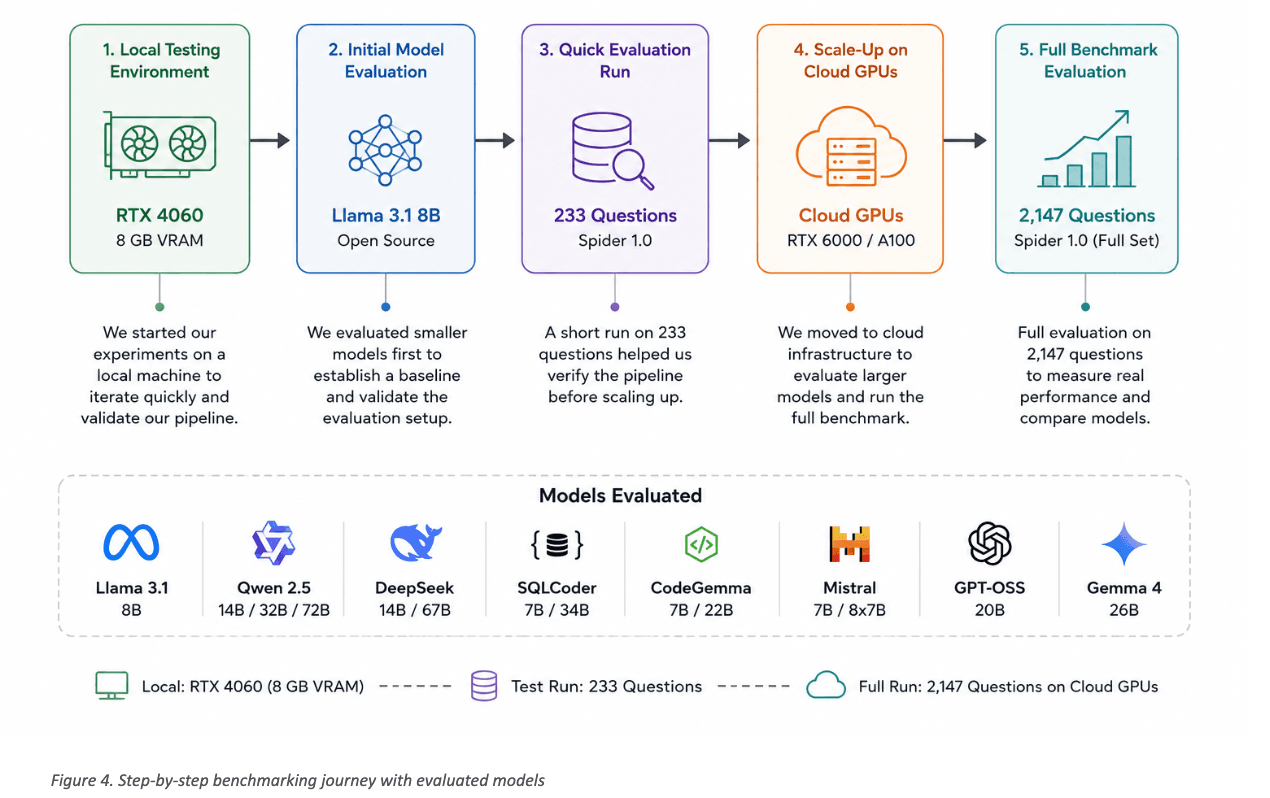
適切な言語モデルを選択することは、ベンチマークプロセスにおいて重要な要素でした。単一のモデルを評価するのではなく、Llama 3.1、Qwen 2.5、DeepSeek、SQLCoder、CodeGemma、Mistral、GPT-OSS、 Gemma 4など、幅広いオープンソースの言語モデルを試しました。

公平な比較を保証するため、テキストからSQLへの変換ベンチマークにおける標準的な指標である実行精度(EA)を用いて、すべてのモデルを評価しました。構文ベースの指標とは異なり、実行精度は生成されたSQLが参照クエリと同じ結果を返すかどうかを測定するため、実際のパフォーマンスをより正確に反映する指標となります。

ベンチマークテストの手順を図4に示します。まず、RTX 4060(8GB VRAM)を搭載したローカルワークステーションで実験を開始しました。ここでは、小規模なモデルを使用することで、迅速な反復とパイプラインの検証が可能になりました。Spider 1.0の233問のサブセットを使用して安定したベースラインを確立した後、クラウドGPUに移行し、 2,147問のベンチマーク全体でより大規模なモデルを評価しました。この段階的なアプローチにより、大規模なベンチマークテストを実行する前に、アーキテクチャを効率的に最適化することができました。

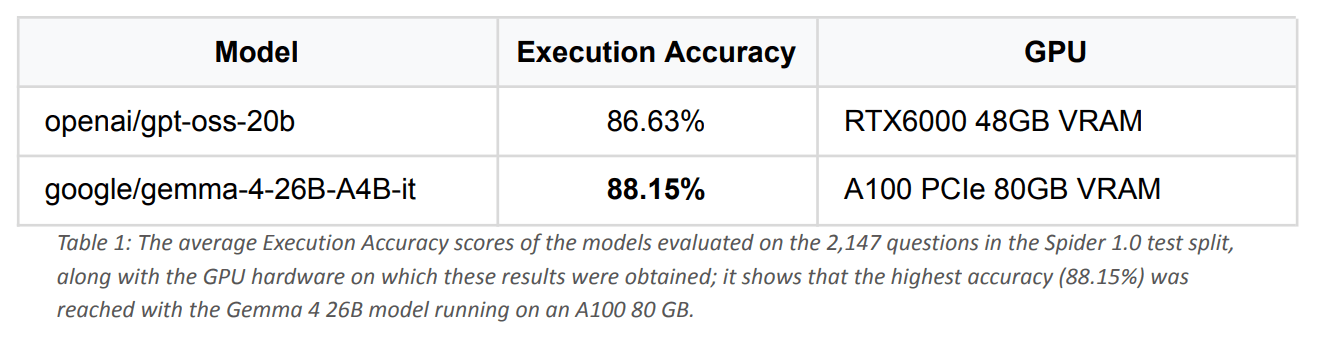
最終モデルは、2,147問を含むSpider 1.0テストスプリット全体で評価しました。表1に示すように、Gemma 4 26Bが最高スコア(88.15%)を達成し、次いでGPT-OSS 20B(86.63%)が続きました。これらの結果は、最新のオープンソースLLMが、効果的な検索および検証パイプラインと組み合わせることで、非常に競争力のあるText-to-SQLパフォーマンスを実現できることを示しています。 

エクラン・レスミ 2026-07-13 15.15.08.png


これらの結果を比較するとどうでしょうか?

ベンチマークスコアは、過去に発表された研究と比較できる場合にのみ意味を持ちます。今回の結果の意義をより深く理解するために、私たちは最近のText-to-SQLに関する研究と、広く参照されているベンチマーク論文の両方をレビューしました。

エクラン・レスミ 2026-07-13 13.07.55.png

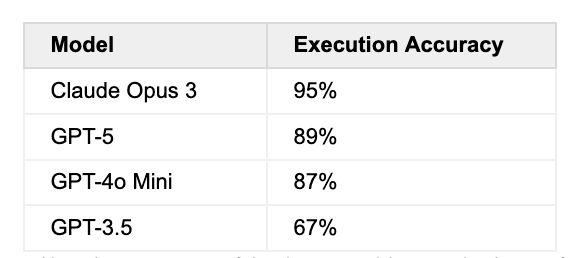
表2:SQL-of-Thought研究で報告された、Spiderデータセットのサブセットにおけるクローズドソースモデルの精度率。比較すると、本研究で得られた88.15%の結果は、GPT-4o Mini(87%)を上回り、GPT-5(89%)に近いレベルにあることがわかる。

SQL-of-Thought [1]などの最近の研究では、 Claude Opus 3、GPT-5、 GPT -4o Miniなどの主要なクローズドソースモデルがSpiderベンチマークのサブセットで高い精度を達成していると報告されています。評価設定、プロンプト、ベンチマークのサブセットの違いにより、直接比較は慎重に解釈する必要がありますが、当社の88.15%の実行精度は、オープンソースモデルが同等の競争力のある範囲内でパフォーマンスを達成できることを示しています。

これらの結果は異なる評価設定に基づいているため直接比較すべきではありませんが、Text-to-SQLシステムの現在のパフォーマンス状況を理解する上で有用な情報を提供します。当社のベンチマークは、適切に設計されたアーキテクチャと組み合わせることで、オープンソースモデルが主要なクローズドソースの代替製品と十分に競合できることを示しています。

エクラン・レスミ 2026-07-13 15.17.45.png

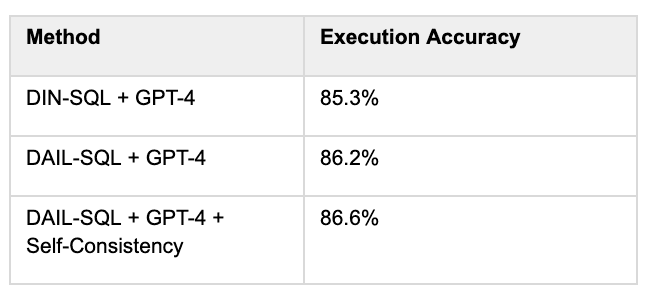
また、大規模な言語モデルとスキーマリンク、プロンプトエンジニアリング、自己一貫性、エラー訂正などの技術を組み合わせた、DIN-SQL [3] やDAIL-SQLなどの実運用指向の Text-to-SQL フレームワークとの結果も比較しました。

エクラン・レスミ 2026-07-13 13.10.44.png

表3:「大規模言語モデルによるテキストからSQLへの変換:ベンチマーク評価」[2]研究におけるSpider 1.0でのさまざまな手法の実行精度結果。モデル選択だけでなく、プロンプトエンジニアリング、スキーマリンク、自己整合性などの技術も精度に影響を与えることが明らかになります。

私たちの研究結果は、近年の文献で共通して見られる結論を裏付けるものです。すなわち、テキストからSQLへの変換における高いパフォーマンスは、言語モデルだけでなく、その周辺アーキテクチャにも依存するということです。効果的なスキーマ検索、コンテキスト管理、検証、自己修正は、モデルそのものと同じくらい重要な場合が多いのです。

私たちが学んだこと

ベンチマークとは、単に精度を測定するだけでなく、システムがどこで、なぜ失敗するのかを理解することでもあります。今回の評価では、誤った予測を分析し、最終スコアに影響を与えたいくつかの繰り返し発生するパターンを特定しました。

一部のエラーはベンチマーク自体に起因していました。ごく少数のケースでは、参照(正解)SQLクエリの不整合により、論理的に正しい予測が誤りとしてマークされました。その他のケースでは、曖昧な自然言語の質問や、複数のSQLクエリが正当に同等の有効な回答を生成する可能性のある同点の場合の判定シナリオが関係していました。

また、不要な型変換、大文字小文字の区別に関する一貫性のない処理、本来は単純なSQLクエリが時折過度に複雑化されるなど、モデル固有の動作もいくつか確認されました。これらの結果は、データエージェントパイプラインに検証および自己修正メカニズムを組み込むことの重要性を改めて示しています。

全体として、分析の結果、残存するエラーの多くは言語モデル自体の限界によるものではなく、ベンチマークの曖昧さやSQL生成におけるエッジケースに起因することが明らかになりました。このことから、検索、検証、およびコンテキスト管理をさらに改善することで、システムの実行精度を90%の閾値以上に高めることができると考えられます。

コストと効率

高い精度は、実運用可能なテキスト・トゥ・SQLシステムの重要な要素の一つに過ぎません。企業環境においては、インフラコスト、データプライバシー、そして導入の柔軟性も同様に重要な考慮事項となります。

私たちの手法の大きな利点の1つは、オープンソースの言語モデルに完全に依存している点です。開発プロセス全体を通して、ほとんどの実験を市販のRTX 4060(8GB VRAM)を使用してローカルで実行できたため、APIやトークンのコストを一切かけずに迅速に反復開発を行うことができました。大規模なベンチマーク実行は、アーキテクチャが検証された後にのみ、専用のクラウドGPU上で実行されました。

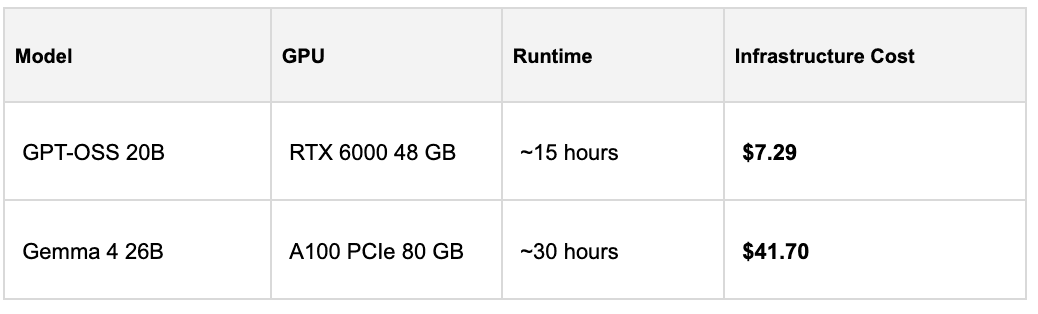
Spider 1.0の評価にはRunPod Secure Cloudを使用しました。Gemma 4 26BベンチマークはA100 PCIe 80 GB GPUで実行し、GPT-OSS 20BはRTX 6000 48 GB GPUで実行しました

インフラ整備にかかる費用は表4にまとめられています。

エクラン・レスミ 2026-07-13 13.11.54.png

大規模なベンチマーク実行にはクラウドインフラストラクチャが必要でしたが、ローカルでの実験とオープンソースモデルのおかげで、開発プロセス全体はコスト効率の良いものとなりました。さらに重要なのは、完成したアーキテクチャは組織自身のインフラストラクチャ内に完全に展開できるため、外部APIへの依存を排除​​しつつ、データプライバシー、コンプライアンス、運用コストをより詳細に管理できる点です。

このため、このアーキテクチャは、データセキュリティと導入の柔軟性が重要な要件となる、プライバシーに配慮した環境、規制された環境、またはエアギャップ環境で事業を展開する組織に特に適しています。

ビヨンド・スパイダー1.0

ベンチマークはAIシステムを客観的に評価する手段を提供するが、それ自体が最終目標ではない。高いベンチマークスコアは、それが実際のアプリケーションにおいて信頼できるパフォーマンスにつながる場合にのみ価値がある。

本研究を通して、実運用可能なテキストからSQLへの変換システムを構築するには、SQLを生成するだけでは不十分であることが分かりました。データベーススキーマの理解、適切なコンテキストの取得、生成されたクエリの検証、そして誤った出力の修正は、言語モデルそのものと同じくらい重要であることが判明しました。

Spider 1.0における88.15%の実行精度は、オープンソースモデルと適切に設計されたアーキテクチャを組み合わせることで、エンタープライズ向けテキストtoSQLタスクにおいて非常に高い競争力のあるパフォーマンスを実現できることを示しています。さらに重要なのは、ベンチマークデータセットだけでなく、複雑なエンタープライズデータベース上でも確実に動作するように構築された当社のデータエージェントの設計原則が正しかったことを証明している点です。

Spider 1.0は重要なマイルストーンですが、これは私たちの旅の始まりに過ぎません。次のステップとしては、 Spider 2.0上でのデータエージェントの評価、より大規模なエンタープライズ規模のベンチマーク、そして最も重要なのは、データベーススキーマが大幅に拡大し、ビジネス上の課題がはるかに複雑になる実際の顧客環境での検証です。

私たちの長期的なビジョンは、単に優れたSQLジェネレーターを開発することではありません。組織が同僚とコミュニケーションを取るのと同じくらい自然に企業データとやり取りできる、インテリジェントなデータエージェントを構築することを目指しています。つまり、データ検索、推論、検証、そして説明可能なAIを組み合わせ、信頼性の高い意思決定支援プラットフォームを実現することです。


主なレッスン

ベンチマーキングとは、単に精度を測定することだけではなく、システムが成功する理由、あるいは失敗する理由を理解することでもある。

評価全体を通して、いくつかの繰り返し発生するエラーパターンを特定しました。その一部は、参照SQLクエリの不整合や順序条件の不明確さなど、ベンチマーク自体の曖昧さに起因するものでした。その他は、不要な型変換や大文字小文字を区別する値の一貫性のない処理など、LLMによく見られる動作を反映したものでした。

これらの観察結果は、私たちの研究における中心的な発見の一つ、すなわちアーキテクチャはモデル選択と同じくらい重要であるということを裏付けました。検索、スキーマリンク、検証、自己修正は、基盤となる言語モデルと同様に、最終的なパフォーマンスに大きく貢献していました。

ベンチマークの限界が最終スコアに影響を与えることは避けられないものの、我々の分析によると、コンテキスト管理と検証をさらに改善することで、システムの実行精度を90%以上に押し上げることができる可能性がある。

今後の展望

Spider 1.0は、当社のデータエージェントを評価するための重要な基準を提供しましたが、これは実運用可能なエンタープライズAIへの第一歩に過ぎません。

次に私たちが注力するのは、Spider 2.0のようなより難易度の高いベンチマーク、そしてさらに重要なことに、スキーマがはるかに大きく、ドキュメントが不完全な場合が多く、ビジネス上の問題がはるかに複雑な実際のエンタープライズデータベースでアーキテクチャを評価することです。

私たちの目標は、単に別のテキスト・トゥ・SQLシステムを構築することではありません。私たちは、検索、推論、検証、説明可能性を組み合わせたインテリジェントなデータエージェントを構築し、組織がエンタープライズデータと自然かつ確実にやり取りできるように支援することを目指しています。

エクラン・レスミ 2026-07-10 15.41.38.png

参考情報

[1] Saumya Chaturvedi、Aman Chadha、Laurent Bindschaedler arXiv。「SQL-of-Thought: ガイド付きエラー訂正機能を備えたマルチエージェント型テキストto-SQL」。arXiv。2026年6月 https://arxiv.org/abs/2509.00581

[2] Dawei Gao、Haibin Wang、Yaliang Li、Xiuyu Sun、Yichen Qian、Bolin Ding、Jingren Zhou 「大規模言語モデルによって強化された Text-to-SQL: ベンチマーク評価」 arXiv。2026年6月

https://arxiv.org/pdf/2308.15363 

[3] Mohammadreza Pourreza、Davood Rafiei。「DIN-SQL: 自己修正機能を備えたテキストからSQLへの分解型コンテキスト内学習」arXiv。2026年6月

https://arxiv.org/pdf/2304.11015


Dilşen YILDAR HAVAYLAR, 

シニアソフトウェアエンジニア、理学修士