Өндіріске дайын мәтіннен SQL жүйесін құру: Spider 1.0 нұсқасында 88.15%-ға жету
Жариялау күні
Шілде 13, 2026
үлес
Талдамалы жазбахат
Өндіріске дайын мәтіннен SQL жүйесін құру үлкен тілдік модельмен SQL жасаудан әлдеқайда көп нәрсені талап етеді. Кәсіпорын қосымшалары бұрын көрінбеген дерекқорларда сенімді нәтижелер алу үшін дәл схеманы түсінуді, контекстті іздеуді, валидацияны және қателерді түзетуді талап етеді.
Бұл зерттеуде біз Data Agent бағдарламасын Spider 1.0 нұсқасында салыстырып , Gemma 4 26B моделін пайдаланып 88.15% орындау дәлдігіне қол жеткіздік . Бұл мақалада тек салыстырмалы ұпайларға ғана назар аудармай, осы нәтижелердің артындағы сәулет шешімдері, инженерлік сабақтар және салыстырмалы талдау туралы түсініктер берілген.
SQL генерациясынан тыс
Ірі тілдік модельдер SQL генерациясын айтарлықтай жақсартты, бірақ өндіріске дайын мәтіннен SQL жүйесін құру табиғи тілді SQL тіліне аударудан әлдеқайда көп нәрсені талап етеді. Кәсіпорын қосымшалары күрделі дерекқор схемаларын түсінуі, дұрыс контекстті алуы, жасалған сұраныстарды тексеруі және бұрын-соңды көрмеген дерекқорларда сенімді нәтижелер беруі керек.
Осы мүмкіндіктерді бағалау үшін біз Data Agent бағдарламасын ең көп қолданылатын мәтіннен SQL-ге түрлендіру эталоны Spider 1.0 нұсқасымен салыстырдық. Gemma 4 26B моделін қолдана отырып, біздің жүйеміз 88.15% орындау дәлдігіне қол жеткізді , бұл архитектура мен контекстті басқарудың модельді таңдау сияқты маңызды екенін көрсетті.
Неліктен Spider 1.0?
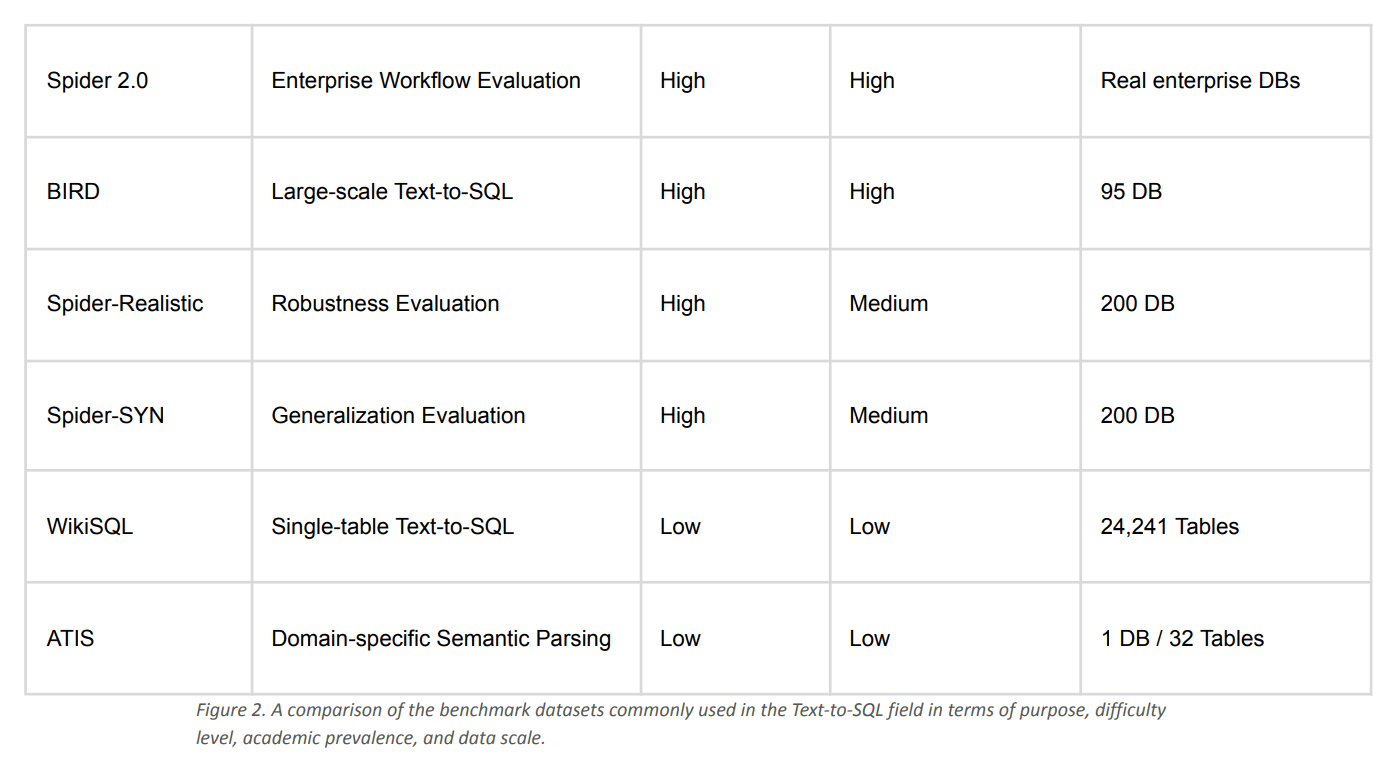
Дұрыс эталонды таңдау дұрыс модельді таңдау сияқты маңызды. Spider 2.0 және BIRD сияқты жаңа деректер жиынтықтары күрделі кәсіпорын сценарийлерін енгізсе де, Spider 1.0 мәтіннен SQL жүйелерін бағалау және нәтижелерді әдебиет бойынша салыстыру үшін ең кең таралған эталон болып қала береді.
Бастапқы бағалау үшін біз Spider 1.0 нұсқасын таңдадық, себебі ол стандартталған және жақсы қалыптасқан базалық деңгейді қамтамасыз етеді. Бұл бізге Data Agent бұрын көрінбеген дерекқор схемаларын қаншалықты тиімді түсінетінін және нақты жағдайларда дұрыс SQL жасайтынын өлшеуге мүмкіндік береді.
2-суретте Spider 1.0 нұсқасының басқа кең таралған Text-to-SQL эталондарымен қалай салыстырылатыны қысқаша көрсетілген.
Деректер агентін құру
Мәтінді SQL-ге айналдырудың жоғары дәлдігіне қол жеткізу тек үлкен тілдік модельді пайдалану мәселесі емес. Біздің салыстыру процесіміз барысында біз архитектура мен контексті басқарудың модельді таңдауға қарағанда өнімділікке көбірек әсер ететінін анықтадық.
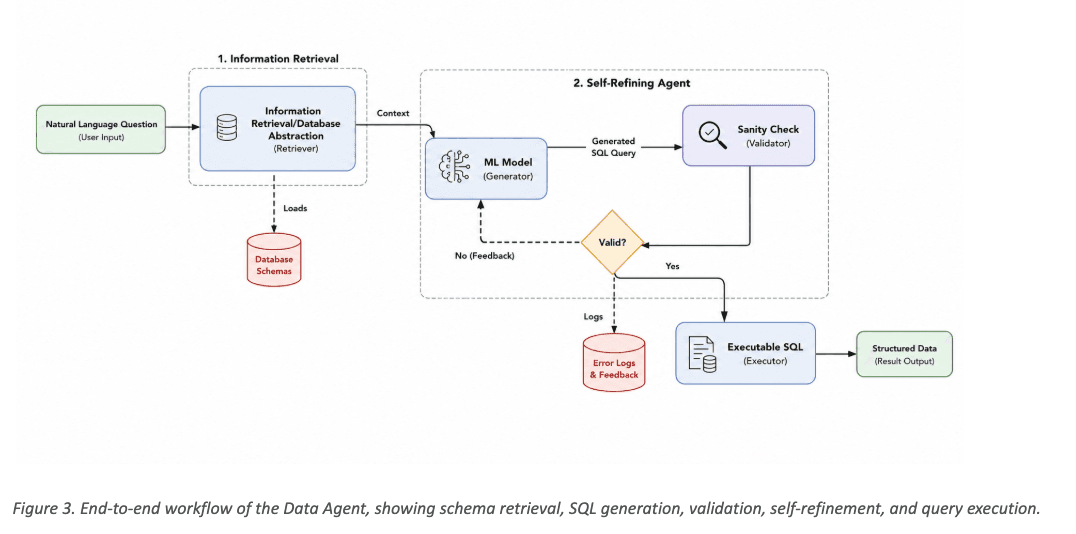
Біздің деректер агентіміз LLM-нен SQL жасауды сұрамас бұрын мәселені біртіндеп тарылтатын көп сатылы құбыр ретінде жасалған. Жүйе бүкіл дерекқор схемасын модельге көрсетудің орнына алдымен тек тиісті схема мен контекстік ақпаратты алады, содан кейін SQL сұрауын жасайды, нәтижені тексереді және орындалу алдында жиі кездесетін қателерді автоматты түрде түзетеді.
3-суретте көрсетілгендей , құрылым үш негізгі кезеңнен тұрады:
Ақпаратты іздеу – Пайдаланушының сұрағы тиісті дерекқор нысандарын анықтау үшін талданады және метадеректер қоймасынан тек қажетті схема туралы ақпарат алынады.
Өзін-өзі тазартатын агент – Тіл моделі SQL жасайды, сұранысты алынған схемамен салыстырады және тексеру сәтсіз аяқталған кезде оны автоматты түрде жетілдіреді.
Орындау және жауап беру – Тексерілгеннен кейін, SQL сұрауы мақсатты дерекқорға қатысты орындалады және нәтижелер құрылымдалған деректер немесе табиғи тілдегі жауап ретінде қайтарылады.
Бұл өндіріске бағытталған архитектура DIN-SQL және DAIL-SQL- де енгізілген идеялардан шабыттандырылған , сонымен қатар сенімділік, түсіндіру мүмкіндігі және беріктігі эталондық дәлдік сияқты маңызды болатын кәсіпорын орталарына бейімделген.
Біздің салыстырмалы талдау сапарымыз
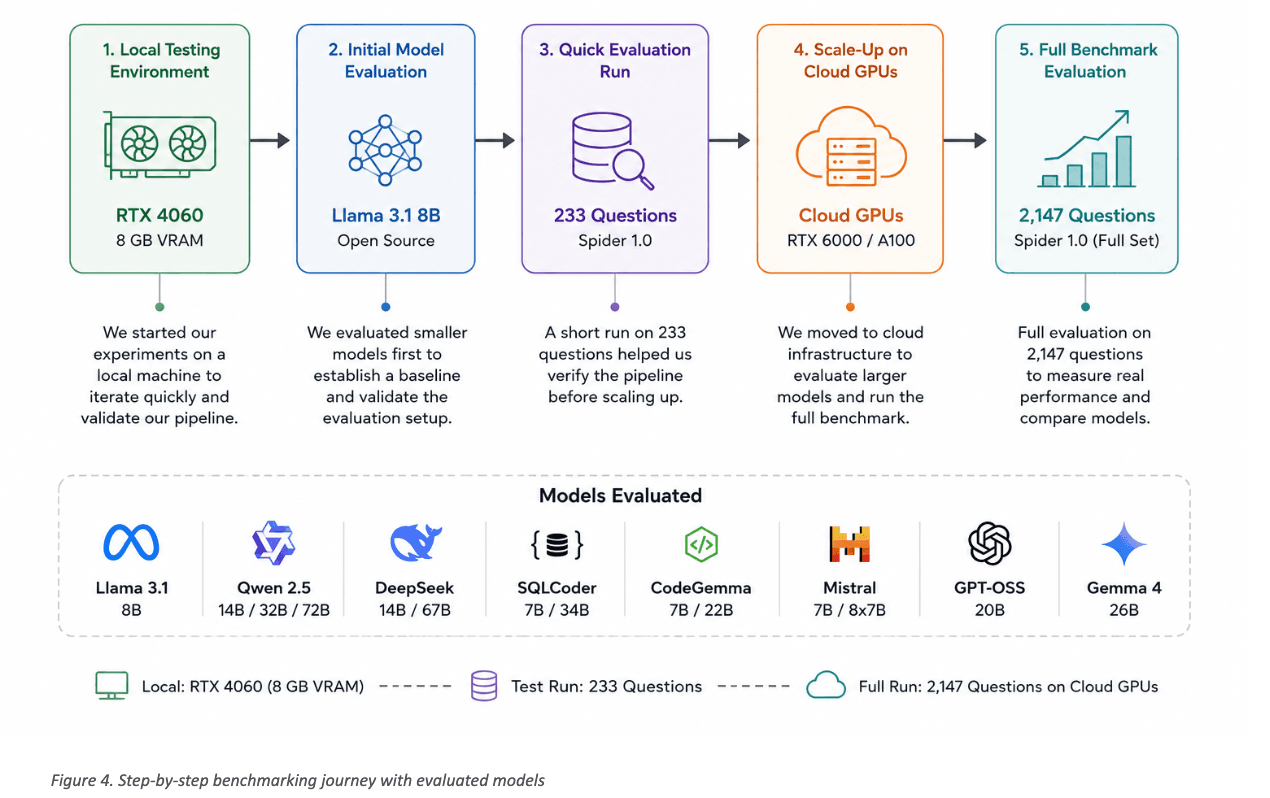
Дұрыс тіл моделін таңдау біздің бенчмаркинг процесіміздің маңызды бөлігі болды. Бір ғана модельді бағалаудың орнына, біз Llama 3.1, Qwen 2.5, DeepSeek, SQLCoder, CodeGemma, Mistral, GPT-OSS және Gemma 4 сияқты ашық бастапқы кодты LLM-дердің кең ауқымымен тәжірибе жасадық.
Әділ салыстыруды қамтамасыз ету үшін біз әрбір модельді мәтіннен SQL-ге бенчмаркингке арналған стандартты метрика - Орындалу дәлдігі (EA) арқылы бағаладық . Синтаксиске негізделген метрикалардан айырмашылығы, Орындалу дәлдігі жасалған SQL анықтамалық сұраныспен бірдей нәтиже беретінін өлшейді, бұл оны нақты әлемдегі өнімділіктің жақсы көрсеткіші етеді.
Біздің бенчмаркинг сапарымыз 4-суретте көрсетілген . Біз RTX 4060 (8 ГБ VRAM) жабдықталған жергілікті жұмыс станциясында тәжірибе жасаудан бастадық , онда кішігірім модельдер бізге жылдам қайталауға және құбырымызды тексеруге мүмкіндік берді. 233 Spider 1.0 сұрақтарының жиынтығын пайдаланып тұрақты базалық деңгейді орнатқаннан кейін , біз 2,147 сұрақтан тұратын толық бенчмарк бойынша үлкенірек модельдерді бағалау үшін бұлттық GPU-ларға көштік . Бұл кезең-кезеңмен жасалған тәсіл бізге ауқымды бенчмаркингтік жұмыстарға инвестиция салмас бұрын архитектураны тиімді оңтайландыруға мүмкіндік берді.
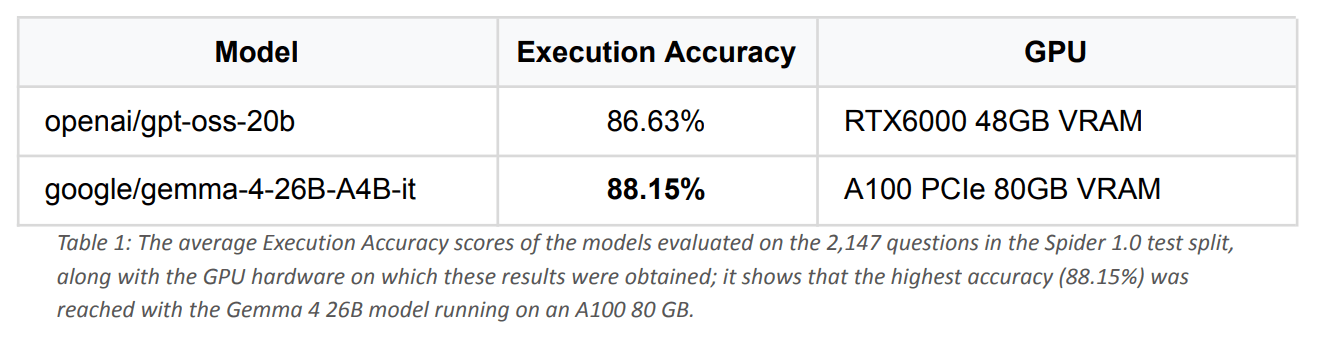
Біз Spider 1.0 тестілеуінің толық бөліміндегі 2,147 сұрақтан тұратын соңғы модельдерді бағаладық. 1-кестеде көрсетілгендей, Gemma 4 26B ең жоғары баллға (88.15%) ие болды, одан кейін GPT-OSS 20B (86.63%) келеді. Бұл нәтижелер заманауи ашық бастапқы кодты LLM-дер тиімді іздеу және тексеру құбырымен біріктірілгенде, жоғары бәсекеге қабілетті мәтіннен SQL өнімділігіне қол жеткізе алатынын көрсетеді.
Бұл нәтижелер қалай салыстырылады?
Бағалау нәтижелері бұрын жарияланған жұмыстармен салыстыруға болатын кезде ғана маңызды болады. Нәтижелеріміздің маңыздылығын жақсырақ түсіну үшін біз жақында жүргізілген мәтіннен SQL-ге дейінгі зерттеулерді де, кеңінен сілтеме жасалған бағдарламалық мақалаларды да қарастырдық.
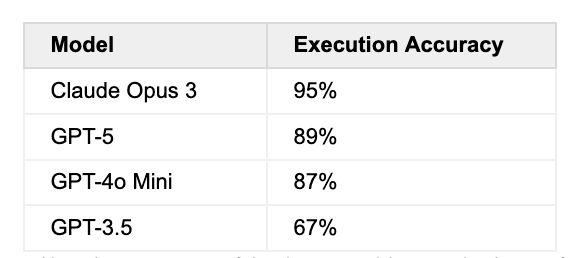
2-кесте: Spider деректер жиынтығының ішкі жиынындағы SQL-of-Thought зерттеуінде көрсетілген жабық бастапқы кодты модельдердің дәлдік көрсеткіштері; салыстырмалы түрде бұл жұмыста алынған 88.15% нәтиже GPT-4o Mini-ден (87%) жоғары және GPT-5-ке жақын деңгейде (89%) орналасқанын көрсетеді.
SQL-of-Thought [1] сияқты соңғы жұмыстарда Claude Opus 3, GPT-5 және GPT-4o Mini сияқты жетекші жабық бастапқы кодты модельдер Spider эталондық ішкі жиынтықтарында жоғары дәлдікке қол жеткізетіндігі туралы айтылады. Бағалау параметрлеріндегі, сұраулардағы және эталондық ішкі жиынтықтардағы айырмашылықтарға байланысты тікелей салыстыруларды мұқият түсіндіру қажет болса да, біздің 88.15% орындау дәлдігі ашық бастапқы кодты модельдердің бірдей бәсекеге қабілетті диапазонда өнімділікке қол жеткізе алатынын көрсетеді.
Бұл нәтижелер әртүрлі бағалау параметрлерінен алынғанымен және оларды тікелей салыстыруға болмайтынымен, олар Text-to-SQL жүйелерінің ағымдағы өнімділік ландшафтын түсіну үшін пайдалы контекст береді. Біздің эталон ашық бастапқы кодты модельдер жақсы жасалған архитектурамен біріктірілген кезде жетекші жабық бастапқы кодты баламалармен бәсекелесе алатынын көрсетеді.
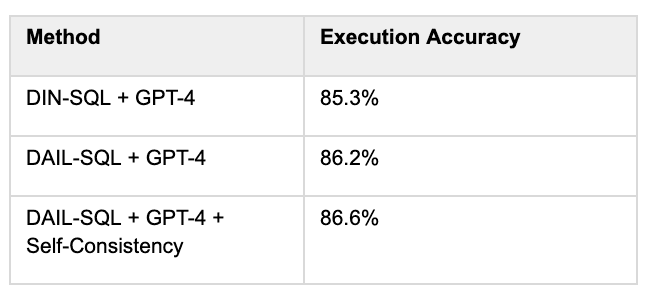
Біз сондай-ақ нәтижелерімізді DIN-SQL [3] және DAIL-SQL L сияқты өндіріске бағытталған мәтіннен SQL-ге дейінгі фреймворктермен салыстырдық, олар үлкен тілдік модельдерді схеманы байланыстыру, жедел инженерия, өзіндік тұрақтылық және қателерді түзету сияқты әдістермен біріктіреді.
3-кесте: «Large Language Models арқылы қолдау тапқан мәтінді SQL-ге айналдыру: эталондық бағалау» [2] зерттеуіндегі Spider 1.0 жүйесіндегі әртүрлі әдістердің орындалу дәлдігінің нәтижелері; ол тек модельді таңдаудың ғана емес, сонымен қатар жедел инженерия, схеманы байланыстыру және өзіндік тұрақтылық сияқты әдістердің дәлдігіне әсерін көрсетеді.
Біздің зерттеу нәтижелеріміз соңғы әдебиеттерде ортақ қорытындыны растайды: мәтіннен SQL-ге жоғары өнімділік тек тілдік модельге ғана емес, сонымен қатар айналасындағы архитектураға да байланысты. Тиімді схеманы іздеу, контекстті басқару, валидация және өзін-өзі түзету көбінесе модельдің өзі сияқты маңызды.
Біз не білдік
Бенчмаркинг тек дәлдікті өлшеумен ғана шектелмейді, сонымен қатар жүйенің қай жерде және неліктен істен шығатынын түсінумен де байланысты. Бағалау барысында біз дұрыс емес болжамдарды талдап, қорытынды ұпайларға әсер еткен бірнеше қайталанатын заңдылықтарды анықтадық.
Кейбір қателіктер эталонның өзінен туындады. Аздаған жағдайларда сілтемелік (алтын) SQL сұрауларындағы сәйкессіздіктер логикалық тұрғыдан дұрыс болжамдардың дұрыс емес деп белгіленуіне әкелді. Басқа жағдайларда бірнеше SQL сұраулары заңды түрде бірдей жарамды жауаптар бере алатын түсініксіз табиғи тілдегі сұрақтар немесе теңестіру сценарийлері болды.
Біз сондай-ақ модельге тән бірнеше мінез-құлықты байқадық, соның ішінде қажетсіз тип түрлендірулері, регистрге сезімталдықты тұрақсыз өңдеу және басқа қарапайым SQL сұраныстарының кейде шамадан тыс күрделенуі. Бұл нәтижелер Data Agent құбырына валидация және өзін-өзі түзету механизмдерін енгізудің маңыздылығын растады.
Жалпы алғанда, біздің талдауымыз қалған көптеген қателіктер тіл моделінің шектеулерінен емес, SQL генерациясындағы эталондық немесе шеткі жағдайлардағы түсініксіздіктерден туындағанын көрсетті. Бұл іздеу, валидация және контекст басқаруды одан әрі жақсарту жүйені 90% орындау дәлдігі шегінен асып түсуі мүмкін екенін көрсетеді.
Құны және тиімділік
Жоғары дәлдік - өндіріске дайын мәтіннен SQL жүйесіне арналған жүйенің бір ғана аспектісі. Кәсіпорындық ортада инфрақұрылым құны, деректердің құпиялылығы және орналастырудың икемділігі бірдей маңызды факторлар болып табылады.
Біздің тәсіліміздің негізгі артықшылықтарының бірі - ол толығымен ашық бастапқы кодты тіл модельдеріне сүйенеді. Әзірлеу процесінде біз көптеген эксперименттерді тұтынушылық деңгейдегі RTX 4060 (8 ГБ VRAM) пайдаланып жергілікті түрде жүргізе алдық , бұл бізге API немесе токен шығындарынсыз жылдам итерациялауға мүмкіндік берді. Содан кейін үлкенірек эталондық жұмыстар арнайы бұлттық графикалық процессорларда архитектура тексерілгеннен кейін ғана орындалды.
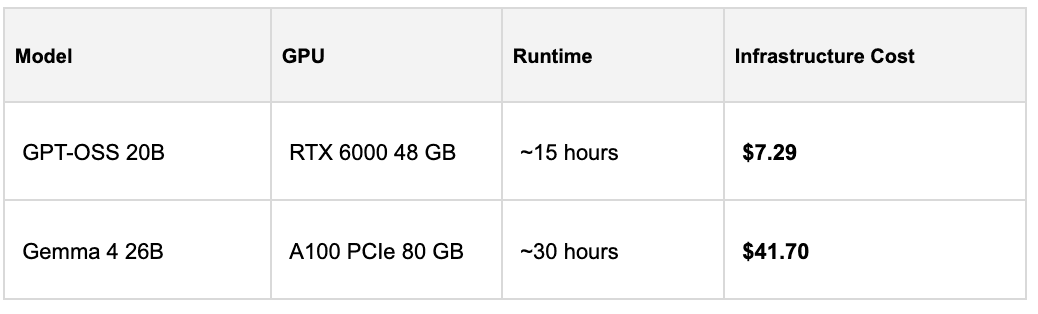
Біз Spider 1.0 нұсқасын толық бағалау үшін RunPod Secure Cloud қолдандық. Gemma 4 26B тестілеуі A100 PCIe 80 ГБ графикалық процессорында, ал GPT-OSS 20B RTX 6000 48 ГБ графикалық процессорында жұмыс істеді .
Инфрақұрылым шығындары 4-кестеде көрсетілген.
Ең үлкен эталондық жұмыстар бұлттық инфрақұрылымды қажет еткенімен, жергілікті эксперименттер мен ашық бастапқы кодты модельдердің арқасында жалпы әзірлеу процесі тиімді болып қалды. Ең бастысы, алынған архитектураны ұйымның өз инфрақұрылымында толығымен орналастыруға болады, бұл сыртқы API-лерге тәуелділікті жояды, сонымен бірге деректердің құпиялылығына, сәйкестігіне және пайдалану шығындарына көбірек бақылауды қамтамасыз етеді.
Бұл архитектураны деректер қауіпсіздігі мен орналастыру икемділігі маңызды талаптар болып табылатын құпиялылыққа сезімтал, реттелетін немесе ауамен шектелген ортада жұмыс істейтін ұйымдар үшін өте қолайлы етеді.
Өрмекшіден тыс 1.0
Бағалау көрсеткіштері жасанды интеллект жүйелерін бағалаудың объективті тәсілін ұсынады, бірақ олар түпкі мақсат емес. Жоғары бағдарлық балл нақты әлемдегі қолданбаларда сенімді өнімділікке айналса ғана құнды болады.
Осы зерттеу барысында біз өндіріске дайын мәтіннен SQL жүйесін құру SQL жасаудан әлдеқайда көп нәрсе екенін анықтадық. Дерекқор схемаларын түсіну, дұрыс контекстті алу, жасалған сұраныстарды тексеру және дұрыс емес нәтижелерді түзету тіл моделінің өзі сияқты маңызды болып шықты.
Spider 1.0 нұсқасындағы 88.15% орындау дәлдігіміз ашық бастапқы кодты модельдердің жақсы жасалған архитектурамен үйлесімде кәсіпорындық мәтіннен SQL-ге дейінгі тапсырмалар үшін жоғары бәсекеге қабілетті өнімділікті қамтамасыз ете алатынын көрсетеді. Ең бастысы, ол тек эталондық деректер жиынтықтарында емес, күрделі кәсіпорындық дерекқорларда сенімді жұмыс істеу үшін жасалған Data Agent-дің дизайн принциптерін растайды.
Spider 1.0 маңызды кезеңді білдіреді, бірақ бұл біздің сапарымыздың бастамасы ғана. Біздің келесі қадамдарымызға Spider 2.0 жүйесіндегі Data Agent-ді бағалау , кәсіпорын деңгейіндегі ірі эталондар және ең бастысы, дерекқор схемалары айтарлықтай үлкен және бизнес сұрақтары әлдеқайда күрделі нақты тұтынушы орталары кіреді.
Біздің ұзақ мерзімді мақсатымыз - жай ғана жақсы SQL генераторын құру емес. Біз ұйымдарға кәсіпорын деректерімен әріптестерімен байланысқандай табиғи түрде өзара әрекеттесуге мүмкіндік беретін интеллектуалды деректер агенттерін құруды мақсат етеміз - іздеуді, пайымдауды, тексеруді және түсіндірілетін жасанды интеллектті сенімді шешім қабылдау платформасына біріктіреміз.
Негізгі сабақтар
Бенчмаркинг тек дәлдікті өлшеу ғана емес, сонымен қатар жүйенің неліктен сәтті немесе сәтсіз болатынын түсіну де маңызды.
Бағалау барысында біз бірнеше қайталанатын қателік үлгілерін анықтадық. Кейбіреулері эталонның өзіндегі түсініксіздіктерден, соның ішінде SQL сілтеме сұрауларындағы сәйкессіздіктерден және ретке келтіру шарттарының жеткіліксіз көрсетілуінен туындады. Басқалары қажетсіз типтерді беру немесе регистрге сезімтал мәндерді сәйкессіз өңдеу сияқты LLM-нің кең таралған әрекеттерін көрсетті.
Бұл бақылаулар біздің жұмысымыздың негізгі тұжырымдарының бірін растады: архитектура модельді таңдау сияқты маңызды. Іздеу, схеманы байланыстыру, валидация және өзін-өзі түзету негізгі тілдік модель сияқты түпкілікті өнімділікке де үлес қосты.
Бағалау шектеулері сөзсіз қорытынды баллға әсер еткенімен, біздің талдауымыз контекстті басқару мен валидацияны одан әрі жақсарту жүйені 90% орындау дәлдігі белгісінен асып түсуі мүмкін екенін көрсетеді.
Алдын ала қарап
Spider 1.0 біздің деректер агентімізді бағалау үшін маңызды базалық деңгейді ұсынды, бірақ ол өндіріске дайын кәсіпорындық жасанды интеллектке қарай жасалған алғашқы қадам ғана.
Біздің келесі мақсатымыз - архитектураны Spider 2.0 сияқты күрделірек эталондарда және, ең бастысы, схемалары айтарлықтай үлкен, құжаттама көбінесе толық емес және бизнес сұрақтары әлдеқайда күрделі нақты кәсіпорындық дерекқорларда бағалау.
Біздің мақсатымыз жай ғана мәтіннен SQL-ге түрлендірудің басқа жүйесін құру емес. Біз ұйымдарға кәсіпорын деректерімен табиғи және сенімді түрде өзара әрекеттесуге көмектесетін іздеу, пайымдау, тексеру және түсіндіруді біріктіретін интеллектуалды деректер агенттерін құрып жатырмыз.