• Publiceer datum
    July 13, 2026
  • Delen
Ekran Resmi 2026-07-10 15.13.39.png

Samenvatting

Het bouwen van een productieklaar tekst-naar-SQL-systeem vereist veel meer dan alleen het genereren van SQL met een groot taalmodel. Zakelijke applicaties vereisen een nauwkeurig begrip van het schema, het ophalen van context, validatie en foutcorrectie om betrouwbare resultaten te leveren op databases die nog niet eerder zijn gezien.

In deze studie hebben we onze Data Agent getest op Spider 1.0 en een uitvoeringsnauwkeurigheid van 88.15% behaald met het Gemma 4 26B -model. In plaats van ons uitsluitend te richten op de benchmarkscores, deelt dit artikel de architectonische beslissingen, technische lessen en benchmarkinzichten die aan deze resultaten ten grondslag liggen.

Voorbij SQL-generatie

Voorbij SQL-generatie

Grote taalmodellen hebben de SQL-generatie aanzienlijk verbeterd, maar het bouwen van een productieklaar tekst-naar-SQL-systeem vereist veel meer dan alleen het vertalen van natuurlijke taal naar SQL. Bedrijfsapplicaties moeten complexe databaseschema's begrijpen, de juiste context ophalen, gegenereerde query's valideren en betrouwbare resultaten leveren op databases die ze nog nooit eerder hebben gezien.

Om deze mogelijkheden te evalueren, hebben we onze Data Agent getest met Spider 1.0, de meest gebruikte benchmark voor tekst-naar-SQL-conversie. Met het Gemma 4 26B -model behaalde ons systeem een ​​uitvoeringsnauwkeurigheid van 88.15% , wat aantoont dat architectuur en contextbeheer net zo belangrijk zijn als modelselectie.

Waarom Spider 1.0?

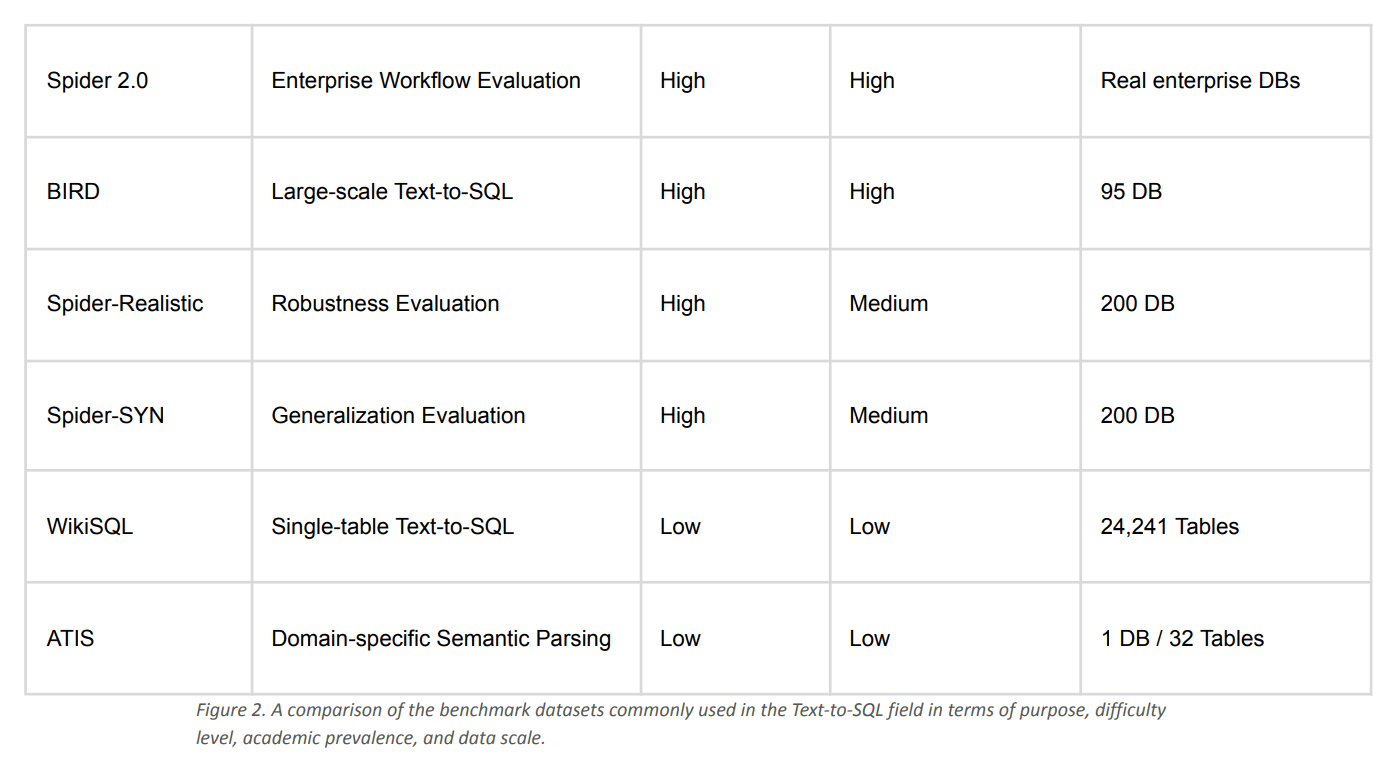
Het kiezen van de juiste benchmark is net zo belangrijk als het kiezen van het juiste model. Hoewel nieuwere datasets zoals Spider 2.0 en BIRD complexere bedrijfsscenario's introduceren, blijft Spider 1.0 de meest gebruikte benchmark voor het evalueren van tekst-naar-SQL-systemen en het vergelijken van resultaten in de literatuur.

Ekran Resmi 2026-07-13 15.13.56.png

Voor onze eerste evaluatie kozen we voor Spider 1.0 omdat deze een gestandaardiseerde en goed onderbouwde basislijn biedt. Hiermee kunnen we meten hoe effectief onze Data Agent onbekende databaseschema's begrijpt en correcte SQL genereert onder realistische omstandigheden.

Figuur 2 geeft een overzicht van hoe Spider 1.0 zich verhoudt tot andere veelgebruikte benchmarks voor tekst-naar-SQL-conversie.

Het bouwen van de data-agent

Het bereiken van een hoge nauwkeurigheid bij tekst-naar-SQL-conversie is niet alleen een kwestie van een groter taalmodel gebruiken. Tijdens ons benchmarkproces ontdekten we dat architectuur en contextbeheer een grotere impact hadden op de prestaties dan de modelkeuze alleen.

Ekran Resmi 2026-07-10 15.31.28.png

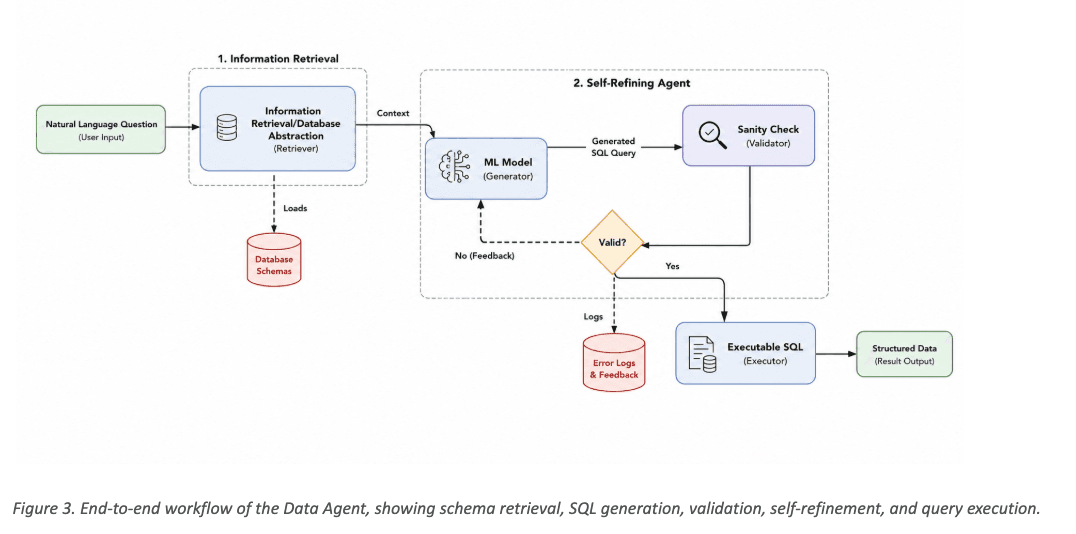
Onze Data Agent is ontworpen als een meerstaps pipeline die het probleem stapsgewijs verkleint voordat het LLM wordt gevraagd om SQL te genereren. In plaats van het volledige databaseschema aan het model bloot te stellen, haalt het systeem eerst alleen het relevante schema en de contextuele informatie op, genereert vervolgens een SQL-query, valideert het resultaat en corrigeert automatisch veelvoorkomende fouten vóór de uitvoering.

Zoals weergegeven in Figuur 3 , bestaat de architectuur uit drie hoofdfasen:

  • Informatie opvragen De vraag van de gebruiker wordt geanalyseerd om de relevante databaseobjecten te identificeren, en alleen de noodzakelijke schema-informatie wordt uit de metadatastore opgehaald.
  • Zelfreinigend middel – Het taalmodel genereert SQL, valideert de query aan de hand van het opgehaalde schema en verfijnt deze automatisch wanneer de validatie mislukt.
  • Uitvoering en reactie – Nadat de SQL-query is gevalideerd, wordt deze uitgevoerd op de doeldatabase en worden de resultaten geretourneerd als gestructureerde data of als een antwoord in natuurlijke taal.

Deze productiegeoriënteerde architectuur is geïnspireerd op ideeën die zijn geïntroduceerd in DIN-SQL en DAIL-SQL , maar is aangepast voor bedrijfsomgevingen waar betrouwbaarheid, verklaarbaarheid en robuustheid net zo belangrijk zijn als nauwkeurigheid van benchmarks.

Ons benchmarktraject

Ekran Resmi 2026-07-10 15.32.47.png

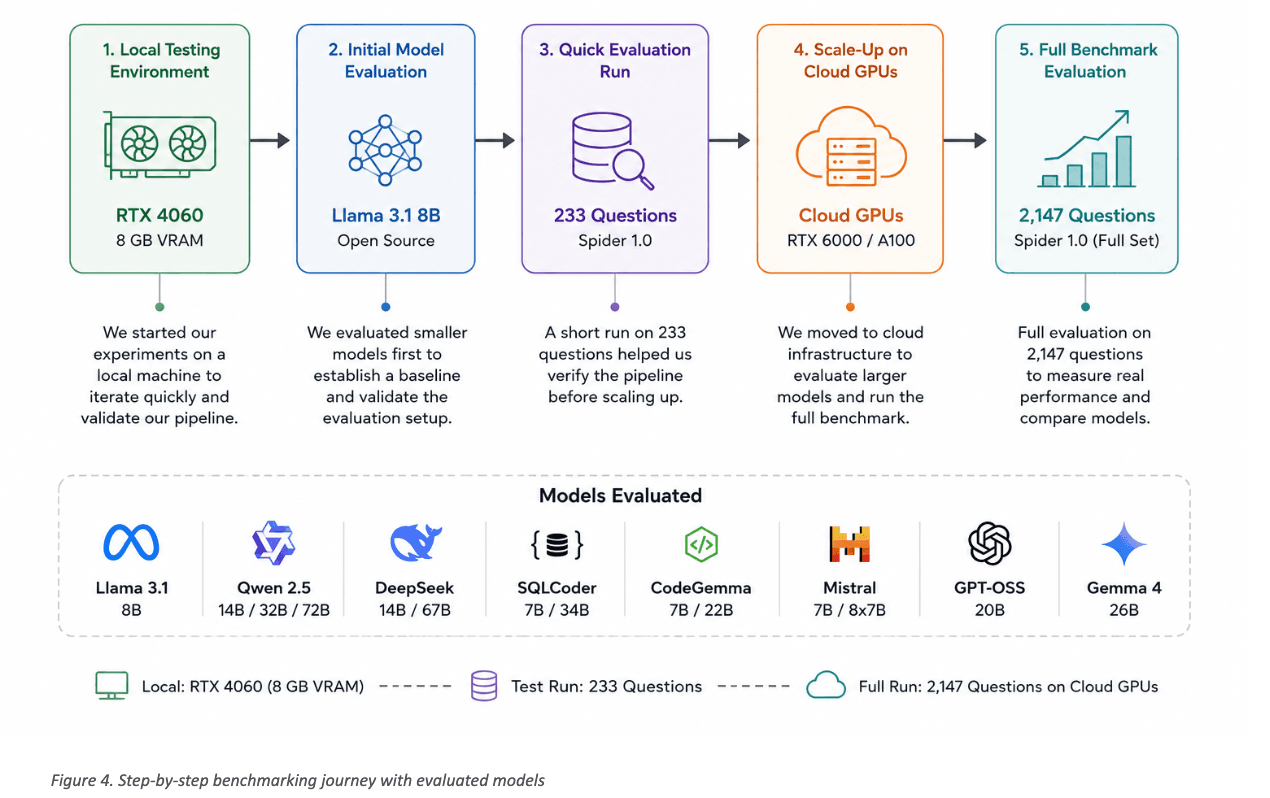
Het kiezen van het juiste taalmodel was een belangrijk onderdeel van ons benchmarkproces. In plaats van één enkel model te evalueren, experimenteerden we met een breed scala aan open-source taalmodellen, waaronder Llama 3.1, Qwen 2.5, DeepSeek, SQLCoder, CodeGemma, Mistral, GPT-OSS en Gemma 4.

Om een ​​eerlijke vergelijking te garanderen, hebben we elk model beoordeeld met behulp van Execution Accuracy (EA) , de standaardmetriek voor Text-to-SQL-benchmarking. In tegenstelling tot syntaxgebaseerde metrieken meet Execution Accuracy of de gegenereerde SQL hetzelfde resultaat oplevert als de referentiequery, waardoor het een betere indicator is van de prestaties in de praktijk.

Ons benchmarktraject wordt geïllustreerd in Figuur 4. We begonnen met experimenteren op een lokaal werkstation met een RTX 4060 (8 GB VRAM) , waar kleinere modellen ons in staat stelden snel te itereren en onze pipeline te valideren. Nadat we een stabiele basislijn hadden vastgesteld met behulp van een subset van 233 Spider 1.0-vragen, zijn we overgestapt naar cloud-GPU's om grotere modellen te evalueren op de volledige benchmark van 2,147 vragen . Deze gefaseerde aanpak stelde ons in staat de architectuur efficiënt te optimaliseren voordat we investeerden in grootschalige benchmarkruns.

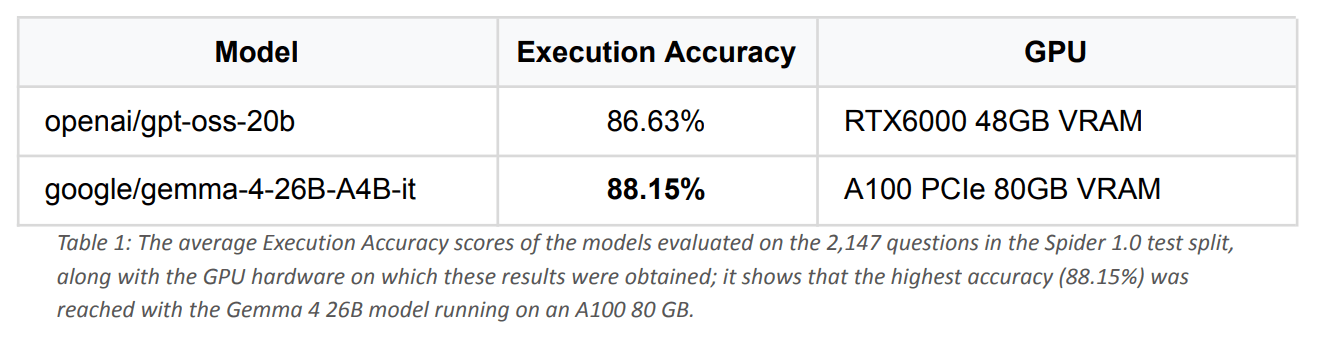
We hebben de uiteindelijke modellen geëvalueerd op de volledige Spider 1.0-testset met 2,147 vragen. Zoals weergegeven in Tabel 1 behaalde Gemma 4 26B de hoogste score (88.15%), gevolgd door GPT-OSS 20B (86.63%). Deze resultaten tonen aan dat moderne open-source LLM's, in combinatie met een effectieve retrieval- en validatiepipeline, zeer concurrerende Text-to-SQL-prestaties kunnen leveren. 

Ekran Resmi 2026-07-13 15.15.08.png


Hoe verhouden deze resultaten zich tot elkaar?

Benchmarkscores zijn alleen zinvol als ze vergeleken kunnen worden met eerder gepubliceerd werk. Om de betekenis van onze resultaten beter te begrijpen, hebben we zowel recente Text-to-SQL-onderzoeken als veel geciteerde benchmarkpublicaties doorgenomen.

Ekran Resmi 2026-07-13 13.07.55.png

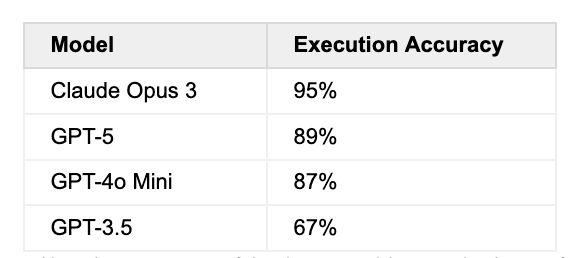
Tabel 2: De nauwkeurigheidspercentages van closed-source modellen die in de SQL-of-Thought-studie zijn gerapporteerd op een subset van de Spider-dataset; hieruit blijkt, in vergelijking, dat het in dit onderzoek behaalde resultaat van 88.15% hoger ligt dan dat van GPT-4o Mini (87%) en op een niveau dat dicht bij dat van GPT-5 (89%) ligt.

Recent werk, zoals SQL-of-Thought [1], meldt dat toonaangevende closed-source modellen – waaronder Claude Opus 3, GPT-5 en GPT-4o Mini – een hoge nauwkeurigheid behalen op subsets van de Spider-benchmark. Hoewel directe vergelijkingen voorzichtig moeten worden geïnterpreteerd vanwege verschillen in evaluatie-instellingen, prompts en benchmark-subsets, toont onze uitvoeringsnauwkeurigheid van 88.15% aan dat open-source modellen prestaties kunnen leveren die binnen hetzelfde competitieve bereik liggen.

Hoewel deze resultaten afkomstig zijn uit verschillende evaluatieomgevingen en niet direct met elkaar vergeleken mogen worden, bieden ze nuttige context voor het begrijpen van het huidige prestatielandschap van tekst-naar-SQL-systemen. Onze benchmark toont aan dat open-source modellen nu kunnen concurreren met toonaangevende closed-source alternatieven, mits gecombineerd met een goed ontworpen architectuur.

Ekran Resmi 2026-07-13 15.17.45.png

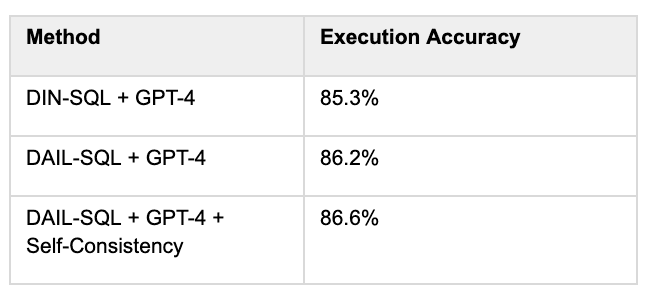
We hebben onze resultaten ook vergeleken met productiegeoriënteerde Text-to-SQL-frameworks zoals DIN-SQL [3] en DAIL- SQL, die grote taalmodellen combineren met technieken zoals schema-koppeling, prompt engineering, zelfconsistentie en foutcorrectie.

Ekran Resmi 2026-07-13 13.10.44.png

Tabel 3: De resultaten van de uitvoeringsnauwkeurigheid van verschillende methoden op Spider 1.0 in de studie "Text-to-SQL Empowered by Large Language Models: A Benchmark Evaluation" [2]; het laat de impact op de nauwkeurigheid zien, niet alleen van de modelselectie, maar ook van technieken zoals prompt engineering, schema-koppeling en zelfconsistentie.

Onze bevindingen bevestigen een conclusie die in de recente literatuur wordt gedeeld: hoge prestaties bij tekst-naar-SQL-conversie hangen niet alleen af ​​van het taalmodel, maar ook van de omringende architectuur. Effectief schemaherstel, contextbeheer, validatie en zelfcorrectie zijn vaak net zo belangrijk als het model zelf.

Wat we hebben geleerd

Benchmarking gaat niet alleen over het meten van nauwkeurigheid, maar ook over het begrijpen waar en waarom een ​​systeem faalt. Tijdens onze evaluatie hebben we onjuiste voorspellingen geanalyseerd en verschillende terugkerende patronen geïdentificeerd die de eindscores beïnvloedden.

Sommige fouten waren afkomstig van de benchmark zelf. In een klein aantal gevallen zorgden inconsistenties in de referentie-SQL-query's ervoor dat logisch correcte voorspellingen als onjuist werden gemarkeerd. Andere gevallen betroffen ambigue vragen in natuurlijke taal of situaties waarin meerdere SQL-query's legitiem even geldige antwoorden konden opleveren.

We observeerden ook verschillende modelspecifieke gedragingen, waaronder onnodige typeconversies, inconsistente behandeling van hoofdlettergevoeligheid en incidentele overcomplexiteit van anderszins eenvoudige SQL-query's. Deze bevindingen benadrukten het belang van het integreren van validatie- en zelfcorrigerende mechanismen in de Data Agent-pipeline.

Over het geheel genomen toonde onze analyse aan dat veel resterende fouten niet werden veroorzaakt door beperkingen van het taalmodel zelf, maar door ambiguïteiten in de benchmark of randgevallen bij het genereren van SQL. Dit suggereert dat verdere verbeteringen in het ophalen, valideren en contextbeheer het systeem boven de drempel van 90% uitvoeringsnauwkeurigheid zouden kunnen tillen.

Kosten en efficiëntie

Hoge nauwkeurigheid is slechts één aspect van een productieklaar tekst-naar-SQL-systeem. In bedrijfsomgevingen zijn infrastructuurkosten, gegevensprivacy en implementatieflexibiliteit even belangrijke overwegingen.

Een van de belangrijkste voordelen van onze aanpak is dat deze volledig gebaseerd is op open-source taalmodellen. Gedurende het ontwikkelingsproces konden we de meeste experimenten lokaal uitvoeren met een consumenten- RPX 4060 (8 GB VRAM) , waardoor we snel konden itereren zonder API- of tokenkosten. Grotere benchmarktests werden pas uitgevoerd op dedicated cloud-GPU's nadat de architectuur gevalideerd was.

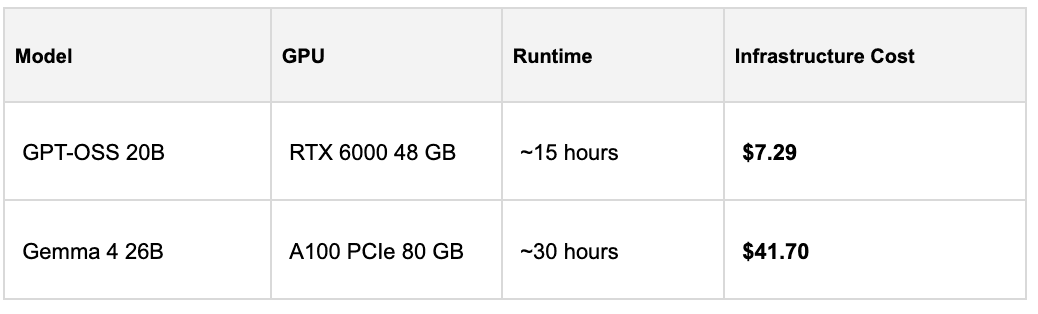
We hebben RunPod Secure Cloud gebruikt voor de volledige evaluatie van Spider 1.0. De Gemma 4 26B-benchmark werd uitgevoerd op een A100 PCIe 80 GB GPU, terwijl GPT-OSS 20B draaide op een RTX 6000 48 GB GPU.

De infrastructuurkosten worden samengevat in tabel 4.

Ekran Resmi 2026-07-13 13.11.54.png

Hoewel de grootste benchmarktests cloudinfrastructuur vereisten, bleef het algehele ontwikkelingsproces kosteneffectief dankzij lokale experimenten en open-sourcemodellen. Belangrijker nog, de resulterende architectuur kan volledig binnen de eigen infrastructuur van een organisatie worden geïmplementeerd, waardoor de afhankelijkheid van externe API's wordt geëlimineerd en er meer controle ontstaat over gegevensprivacy, compliance en operationele kosten.

Dit maakt de architectuur bijzonder geschikt voor organisaties die actief zijn in privacygevoelige, gereguleerde of geïsoleerde omgevingen, waar gegevensbeveiliging en flexibiliteit bij de implementatie cruciale vereisten zijn.

Voorbij Spider 1.0

Benchmarks bieden een objectieve manier om AI-systemen te evalueren, maar ze zijn niet het uiteindelijke doel. Een hoge benchmarkscore is alleen waardevol als deze zich vertaalt in betrouwbare prestaties in praktijktoepassingen.

Tijdens dit onderzoek ontdekten we dat het bouwen van een productieklaar tekst-naar-SQL-systeem veel meer inhoudt dan alleen het genereren van SQL. Het begrijpen van databaseschema's, het ophalen van de juiste context, het valideren van gegenereerde query's en het verfijnen van onjuiste uitvoer bleken net zo belangrijk te zijn als het taalmodel zelf.

Onze uitvoeringsnauwkeurigheid van 88.15% op Spider 1.0 toont aan dat open-source modellen, in combinatie met een goed ontworpen architectuur, zeer concurrerende prestaties kunnen leveren voor tekst-naar-SQL-taken op bedrijfsniveau. Belangrijker nog, het bevestigt de ontwerpprincipes achter onze Data Agent , die is gebouwd om betrouwbaar te werken op complexe bedrijfsdatabases in plaats van alleen op benchmarkdatasets.

Spider 1.0 is een belangrijke mijlpaal, maar slechts het begin van onze reis. Onze volgende stappen omvatten de evaluatie van de Data Agent op Spider 2.0 , grotere benchmarks op bedrijfsniveau en, het allerbelangrijkste, echte klantomgevingen waar databaseschema's aanzienlijk groter zijn en zakelijke vraagstukken veel complexer.

Onze langetermijnvisie is niet alleen het bouwen van een betere SQL-generator. We streven ernaar intelligente data-agents te ontwikkelen waarmee organisaties op een natuurlijke manier met bedrijfsdata kunnen omgaan, net zoals ze met een collega communiceren. We combineren retrieval, redenering, validatie en verklaarbare AI tot een betrouwbaar platform voor besluitvorming.


Belangrijkste lessen

Benchmarking gaat niet alleen over het meten van nauwkeurigheid, maar ook over het begrijpen waarom een ​​systeem succesvol is of faalt.

Tijdens onze evaluatie hebben we verschillende terugkerende foutpatronen vastgesteld. Sommige daarvan waren het gevolg van onduidelijkheden in de benchmark zelf, waaronder inconsistenties in de referentie-SQL-query's en onvoldoende gespecificeerde sorteervoorwaarden. Andere weerspiegelden veelvoorkomend gedrag van LLM, zoals onnodige typeconversie of inconsistente behandeling van hoofdlettergevoelige waarden.

Deze observaties bevestigden een van de belangrijkste bevindingen van ons onderzoek: architectuur is net zo belangrijk als modelselectie. Ophalen, schemakoppeling, validatie en zelfcorrectie droegen net zoveel bij aan de uiteindelijke prestaties als het onderliggende taalmodel.

Hoewel de beperkingen van de benchmark onvermijdelijk van invloed zijn op de eindscore, suggereert onze analyse dat verdere verbeteringen in contextbeheer en validatie het systeem boven de 90% nauwkeurigheid van de uitvoering zouden kunnen tillen.

Volgende halte: Spa

Spider 1.0 bood een belangrijke basis voor de evaluatie van onze Data Agent, maar het is slechts de eerste stap naar een productierijpe AI voor bedrijven.

Onze volgende focus is het evalueren van de architectuur aan de hand van meer uitdagende benchmarks zoals Spider 2.0 en, belangrijker nog, op echte bedrijfsdatabases waar schema's aanzienlijk groter zijn, documentatie vaak onvolledig is en zakelijke vraagstukken veel complexer zijn.

Ons doel is niet simpelweg het bouwen van weer een tekst-naar-SQL-systeem. We ontwikkelen intelligente data-agents die retrieval, redenering, validatie en verklaarbaarheid combineren om organisaties te helpen op een natuurlijke en betrouwbare manier met bedrijfsdata te werken.

Ekran Resmi 2026-07-10 15.41.38.png

Referenties

[1] Saumya Chaturvedi, Aman Chadha, Laurent Bindschaedler arXiv. “SQL-of-Thought: Multi-agentic Text-to-SQL with Guided Error Correction.” arXiv. Juni 2026 https://arxiv.org/abs/2509.00581

[2] Dawei Gao, Haibin Wang, Yaliang Li, Xiuyu Sun, Yichen Qian, Bolin Ding, Jingren Zhou "Tekst-naar-SQL mogelijk gemaakt door grote taalmodellen: een benchmarkevaluatie" arXiv. Juni 2026

https://arxiv.org/pdf/2308.15363 

[3] Mohammadreza Pourreza, Davood Rafiei. “DIN-SQL: Decomposed In-Context Learning of Text-to-SQL with Self-Correction” arXiv. Juni 2026

https://arxiv.org/pdf/2304.11015


Dilşen YILDAR HAVAYLAR, 

Senior software engineer, MSc.