• Publiseringsdato
    Juli 13, 2026
  • Del
Ekran Resmi 2026-07-10 15.13.39.png

Kortfattet sammendrag

Å bygge et produksjonsklart tekst-til-SQL-system krever mye mer enn å generere SQL med en stor språkmodell. Bedriftsapplikasjoner krever nøyaktig skjemaforståelse, kontekstgjenfinning, validering og feilretting for å produsere pålitelige resultater på tidligere usete databaser.

I denne studien sammenligner vi vår Data AgentSpider 1.0 og oppnår 88.15 % utførelsesnøyaktighet ved bruk av Gemma 4 26B -modellen. I stedet for å fokusere utelukkende på referansepoeng, deler denne artikkelen de arkitekturmessige beslutningene, ingeniørlærdommene og referanseinnsikten bak disse resultatene.

Utover SQL-generering

Utover SQL-generering

Store språkmodeller har forbedret SQL-generering betydelig, men å bygge et produksjonsklart tekst-til-SQL-system krever mye mer enn å oversette naturlig språk til SQL. Bedriftsapplikasjoner må forstå komplekse databaseskjemaer, hente riktig kontekst, validere genererte spørringer og produsere pålitelige resultater på databaser de aldri har sett før.

For å evaluere disse funksjonene, testet vi vår Data Agent på Spider 1.0, den mest brukte tekst-til-SQL-referansemodellen. Ved å bruke Gemma 4 26B -modellen oppnådde systemet vårt en utførelsesnøyaktighet på 88.15 % , noe som viser at arkitektur og konteksthåndtering er like viktig som modellvalg.

Hvorfor Spider 1.0?

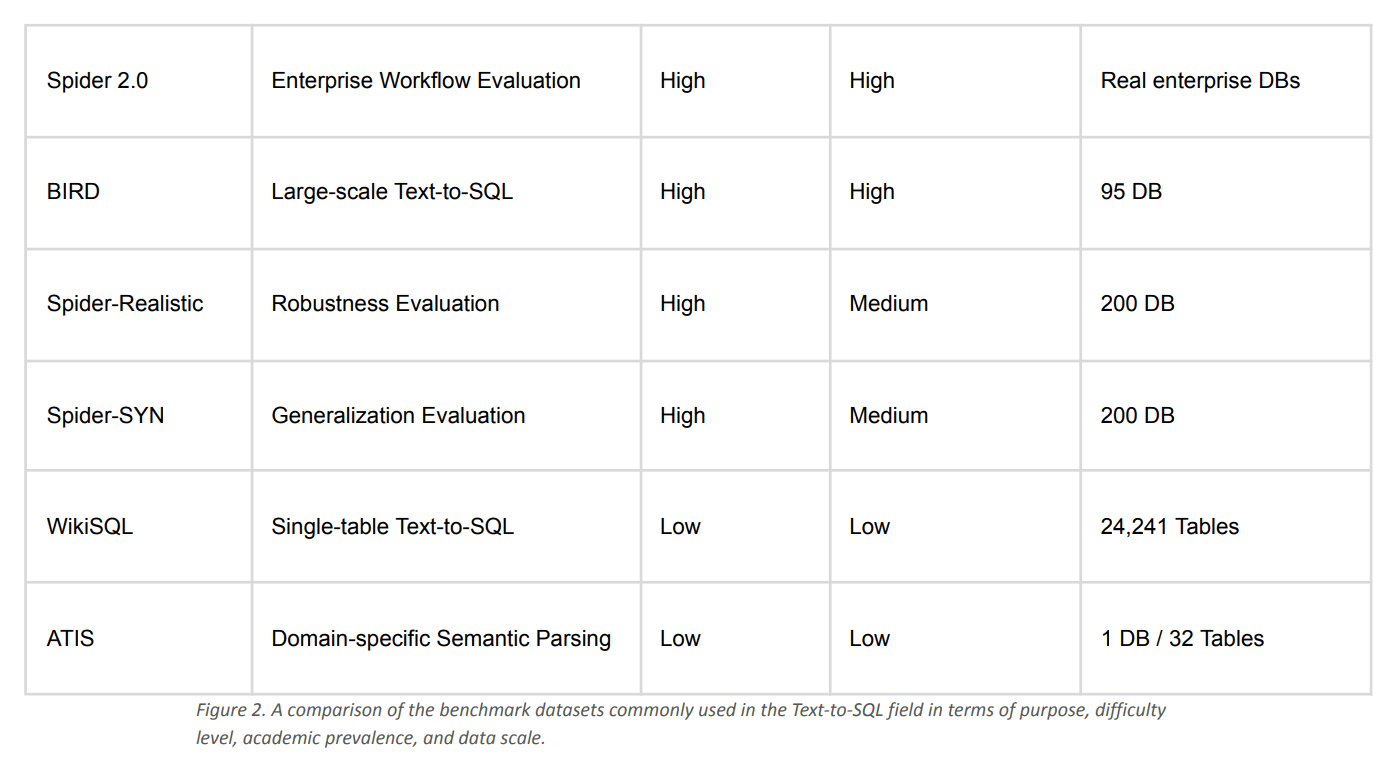
Å velge riktig referansepunkt er like viktig som å velge riktig modell. Mens nyere datasett som Spider 2.0 og BIRD introduserer mer komplekse bedriftsscenarier, er Spider 1.0 fortsatt den mest brukte referansepunkten for å evaluere tekst-til-SQL-systemer og sammenligne resultater på tvers av litteraturen.

Ekran Resmi 2026-07-13 15.13.56.png

For vår første evaluering valgte vi Spider 1.0 fordi den gir et standardisert og veletablert grunnlag. Den lar oss måle hvor effektivt vår Data Agent forstår tidligere usete databaseskjemaer og genererer korrekt SQL under realistiske forhold.

Figur 2 oppsummerer hvordan Spider 1.0 sammenlignes med andre vanlige tekst-til-SQL-benchmarks.

Bygge dataagenten

Å oppnå høy tekst-til-SQL-nøyaktighet handler ikke bare om å bruke en større språkmodell. Gjennom hele benchmarkingprosessen fant vi ut at arkitektur og konteksthåndtering hadde større innvirkning på ytelsen enn modellvalg alene.

Ekran Resmi 2026-07-10 15.31.28.png

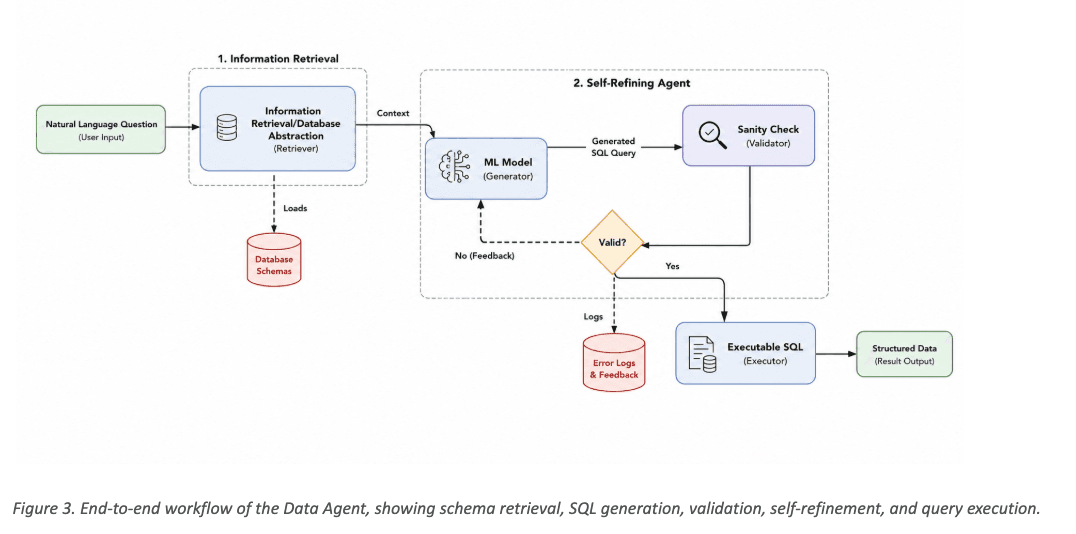
Vår dataagent er utformet som en flertrinns pipeline som gradvis snevrer inn problemet før den ber LLM om å generere SQL. I stedet for å eksponere hele databaseskjemaet for modellen, henter systemet først bare det relevante skjemaet og kontekstuell informasjon, genererer deretter en SQL-spørring, validerer resultatet og korrigerer automatisk vanlige feil før utførelse.

Som illustrert i figur 3 , består arkitekturen av tre hovedtrinn:

  • Informasjon henting – Brukerens spørsmål analyseres for å identifisere relevante databaseobjekter, og bare nødvendig skjemainformasjon hentes fra metadatalageret.
  • Selvraffinerende middel – Språkmodellen genererer SQL, validerer spørringen mot det hentede skjemaet og forbedrer den automatisk når valideringen mislykkes.
  • Utførelse og respons – Når SQL-spørringen er validert, kjøres den mot måldatabasen, og resultatene returneres som strukturerte data eller et naturlig språksvar.

Denne produksjonsorienterte arkitekturen er inspirert av ideer introdusert i DIN-SQL og DAIL-SQL , samtidig som den er tilpasset bedriftsmiljøer der pålitelighet, forklarbarhet og robusthet er like viktig som nøyaktighet i referansepunkter.

Vår referanseprosess

Ekran Resmi 2026-07-10 15.32.47.png

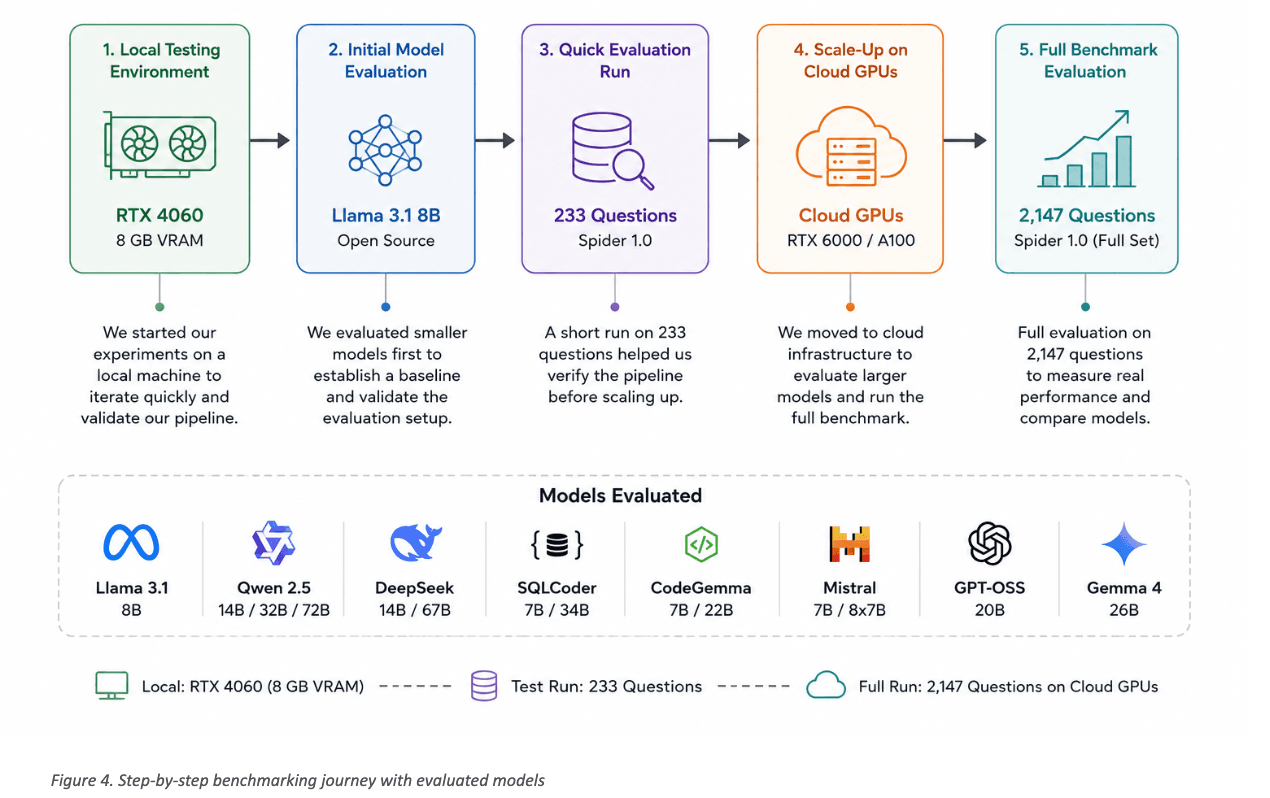
Å velge riktig språkmodell var en viktig del av vår benchmarking-prosess. I stedet for å evaluere én enkelt modell, eksperimenterte vi med et bredt spekter av åpen kildekode-LLM-er, inkludert Llama 3.1, Qwen 2.5, DeepSeek, SQLCoder, CodeGemma, Mistral, GPT-OSS og Gemma 4.

For å sikre en rettferdig sammenligning evaluerte vi hver modell ved hjelp av Execution Accuracy (EA) , standardmetrikken for Text-to-SQL-benchmarking. I motsetning til syntaksbaserte metrikker måler Execution Accuracy om den genererte SQL-en returnerer samme resultat som referansespørringen, noe som gjør den til en bedre indikator på ytelse i den virkelige verden.

Vår referansetestreise er illustrert i figur 4. Vi startet med å eksperimentere på en lokal arbeidsstasjon utstyrt med en RTX 4060 (8 GB VRAM) , hvor mindre modeller tillot oss å iterere raskt og validere vår pipeline. Etter å ha etablert en stabil grunnlinje ved hjelp av et delsett av 233 Spider 1.0-spørsmål, gikk vi over til skybaserte GPU-er for å evaluere større modeller på hele referansetesten med 2,147 spørsmål . Denne trinnvise tilnærmingen gjorde det mulig for oss å optimalisere arkitekturen effektivt før vi investerte i storskala referansetestkjøringer.

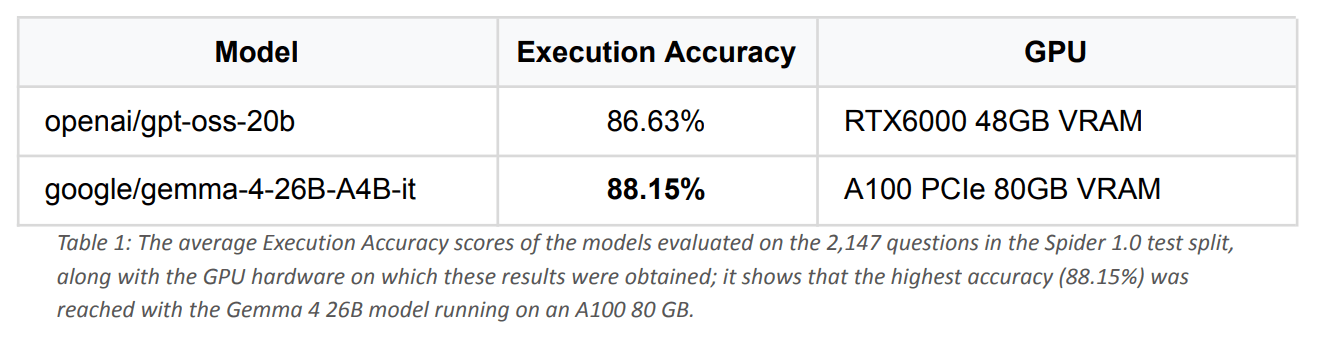
Vi evaluerte de endelige modellene på den komplette Spider 1.0-testdelingen som inneholdt 2,147 spørsmål. Som vist i tabell 1 oppnådde Gemma 4 26B den høyeste poengsummen (88.15 %), etterfulgt av GPT-OSS 20B (86.63 %). Disse resultatene viser at moderne LLM-er med åpen kildekode, kombinert med en effektiv hente- og valideringsprosess, kan oppnå svært konkurransedyktig tekst-til-SQL-ytelse. 

Ekran Resmi 2026-07-13 15.15.08.png


Hvordan er disse resultatene sammenlignet?

Referansepoengsummer er bare meningsfulle når de kan sammenlignes med tidligere publisert arbeid. For å bedre forstå betydningen av resultatene våre, har vi gjennomgått både nyere tekst-til-SQL-studier og referanseartikler med bred referanseinformasjon.

Ekran Resmi 2026-07-13 13.07.55.png

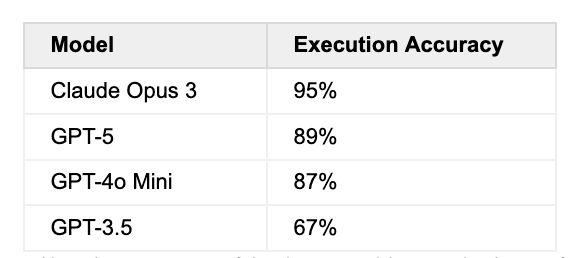
Tabell 2: Nøyaktighetsratene for lukkede kildekode-modeller rapportert i SQL-of-Thought-studien på et delsett av Spider-datasettet. Den viser, sammenlignende sett, at resultatet på 88.15 % som ble oppnådd i dette arbeidet, er plassert over GPT-4o Mini (87 %) og på et nivå nær GPT-5 (89 %).

Nyere arbeid som SQL-of-Thought [1] rapporterer at ledende modeller med lukket kildekode – inkludert Claude Opus 3, GPT-5 og GPT-4o Mini – oppnår høy nøyaktighet på Spider-benchmark-delsett. Selv om direkte sammenligninger bør tolkes nøye på grunn av forskjeller i evalueringsinnstillinger, ledetekster og benchmark-delsett, viser vår utførelsesnøyaktighet på 88.15 % at modeller med åpen kildekode kan oppnå ytelse innenfor samme konkurransedyktige område.

Selv om disse resultatene kommer fra ulike evalueringsmiljøer og ikke bør sammenlignes direkte, gir de nyttig kontekst for å forstå det nåværende ytelseslandskapet til tekst-til-SQL-systemer. Vår referanseverdi viser at modeller med åpen kildekode nå kan konkurrere med ledende alternativer med lukket kildekode når de kombineres med en godt designet arkitektur.

Ekran Resmi 2026-07-13 15.17.45.png

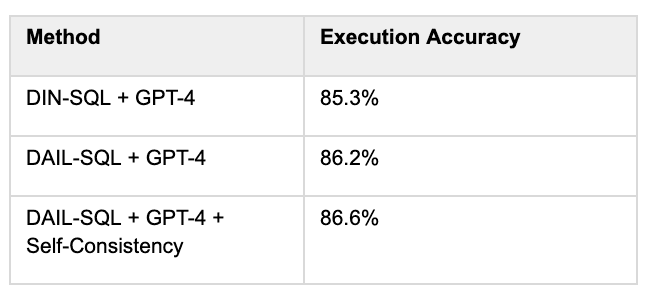
Vi sammenlignet også resultatene våre med produksjonsorienterte tekst-til-SQL-rammeverk som DIN-SQL [3] og DAIL-SQ L, som kombinerer store språkmodeller med teknikker som skjemakobling, prompt engineering, selvkonsistens og feilretting.

Ekran Resmi 2026-07-13 13.10.44.png

Tabell 3: Resultatene av utførelsesnøyaktighet for ulike metoder på Spider 1.0 i studien «Text-to-SQL Empowered by Large Language Models: A Benchmark Evaluation» [2]; den avslører virkningen på nøyaktigheten ikke bare av modellvalg, men også av teknikker som prompt engineering, skjemakobling og selvkonsistens.

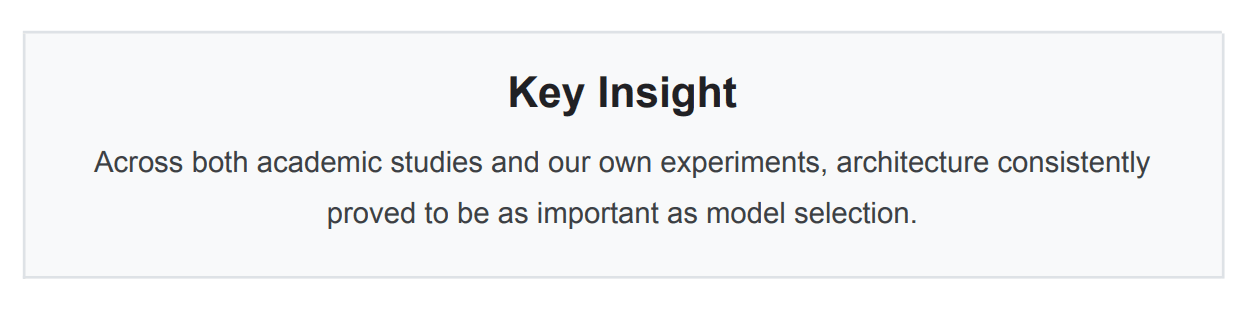
Funnene våre forsterker en konklusjon som deles i nyere litteratur: høy tekst-til-SQL-ytelse avhenger ikke bare av språkmodellen, men også av den omkringliggende arkitekturen. Effektiv skjemagjenfinning, konteksthåndtering, validering og selvkorrigering er ofte like viktig som selve modellen.

Hva vi lærte

Benchmarking handler ikke bare om å måle nøyaktighet – det handler også om å forstå hvor og hvorfor et system feiler. Gjennom evalueringen analyserte vi feilaktige forutsigelser og identifiserte flere tilbakevendende mønstre som påvirket sluttresultatene.

Noen feil oppsto fra selve referansetesten. I et lite antall tilfeller førte inkonsekvenser i referanse-SQL-spørringene (gull) til at logisk korrekte prediksjoner ble merket som feil. Andre tilfeller involverte tvetydige spørsmål i naturlig språk eller uavgjortscenarier, der flere SQL-spørringer legitimt kunne produsere like gyldige svar.

Vi observerte også flere modellspesifikke atferder, inkludert unødvendige typekonverteringer, inkonsekvent håndtering av store og små bokstaver og sporadisk overkomplikasjon av ellers enkle SQL-spørringer. Disse funnene forsterket viktigheten av å innlemme validerings- og selvkorrigeringsmekanismer i Data Agent-pipelinen.

Samlet sett viste analysen vår at mange gjenværende feil ikke var forårsaket av begrensninger i selve språkmodellen, men av tvetydigheter i referanse- eller kanttilfellene i SQL-generering. Dette tyder på at ytterligere forbedringer i henting, validering og konteksthåndtering kan presse systemet utover terskelen på 90 % utførelsesnøyaktighet.

Kostnad og effektivitet

Høy nøyaktighet er bare ett aspekt ved et produksjonsklart tekst-til-SQL-system. I bedriftsmiljøer er infrastrukturkostnader, databeskyttelse og fleksibilitet ved distribusjon like viktige hensyn.

En av hovedfordelene med tilnærmingen vår er at den er helt basert på språkmodeller med åpen kildekode. Gjennom hele utviklingsprosessen kunne vi utføre de fleste eksperimentene lokalt med en RTX 4060 (8 GB VRAM) i forbrukerklassen , noe som gjorde at vi kunne iterere raskt uten å pådra oss API- eller tokenkostnader. Større benchmark-kjøringer ble deretter utført på dedikerte sky-GPU-er først etter at arkitekturen var validert.

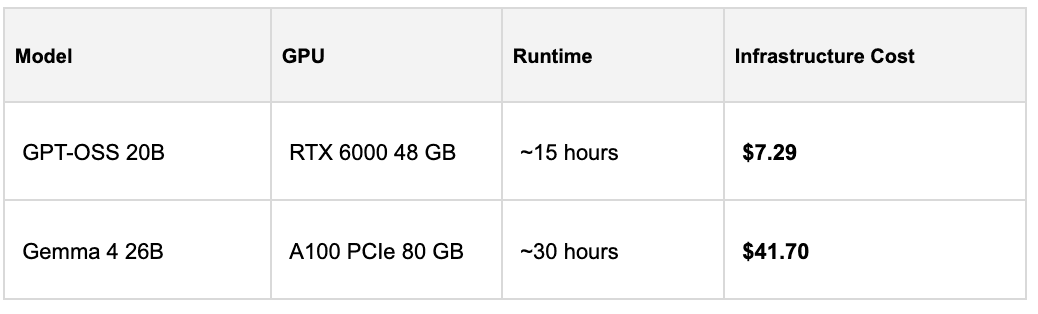
Vi brukte RunPod Secure Cloud for den fullstendige Spider 1.0-evalueringen. Gemma 4 26B-referansetesten ble utført på et A100 PCIe 80 GB GPU, mens GPT-OSS 20B kjørte på et RTX 6000 48 GB GPU.

Infrastrukturkostnadene er oppsummert i tabell 4.

Ekran Resmi 2026-07-13 13.11.54.png

Selv om de største benchmark-kjøringene krevde skyinfrastruktur, forble den overordnede utviklingsprosessen kostnadseffektiv takket være lokal eksperimentering og modeller med åpen kildekode. Enda viktigere er det at den resulterende arkitekturen kan distribueres fullstendig innenfor en organisasjons egen infrastruktur, noe som eliminerer avhengigheten av eksterne API-er samtidig som det gir større kontroll over databeskyttelse, samsvar og driftskostnader.

Dette gjør arkitekturen spesielt godt egnet for organisasjoner som opererer i personvernsensitive, regulerte eller luftgapede miljøer, der datasikkerhet og fleksibilitet i distribusjon er kritiske krav.

Utover Edderkopp 1.0

Referansemålinger gir en objektiv måte å evaluere AI-systemer på, men de er ikke det endelige målet. En høy referansemåling er bare verdifull hvis den oversettes til pålitelig ytelse i virkelige applikasjoner.

Gjennom hele denne studien fant vi ut at det å bygge et produksjonsklart tekst-til-SQL-system handler om mye mer enn å generere SQL. Å forstå databaseskjemaer, hente riktig kontekst, validere genererte spørringer og forbedre feil utdata viste seg å være like viktig som selve språkmodellen.

Vår utførelsesnøyaktighet på 88.15 % på Spider 1.0 viser at modeller med åpen kildekode, kombinert med en godt designet arkitektur, kan levere svært konkurransedyktig ytelse for tekst-til-SQL-oppgaver i bedrifter. Enda viktigere er det at det validerer designprinsippene bak vår dataagent , som ble bygget for å fungere pålitelig på komplekse bedriftsdatabaser i stedet for bare på referansedatasett.

Spider 1.0 representerer en viktig milepæl, men det er bare begynnelsen på reisen vår. Våre neste steg inkluderer evaluering av Data Agent på Spider 2.0 , større benchmarks på bedriftsnivå, og, viktigst av alt, reelle kundemiljøer der databaseskjemaer er betydelig større og forretningsspørsmål er langt mer komplekse.

Vår langsiktige visjon er ikke bare å bygge en bedre SQL-generator. Vi tar sikte på å bygge intelligente dataagenter som gjør det mulig for organisasjoner å samhandle med bedriftsdata like naturlig som de kommuniserer med en kollega – og kombinerer henting, resonnement, validering og forklarbar AI i en pålitelig beslutningsstøtteplattform.


Nøkkelleksjoner

Benchmarking handler ikke bare om å måle nøyaktighet – det handler om å forstå hvorfor et system lykkes eller mislykkes.

Gjennom evalueringen identifiserte vi flere tilbakevendende feilmønstre. Noen stammet fra tvetydigheter i selve referanseindeksen, inkludert inkonsekvenser i referanse-SQL-spørringer og underspesifiserte rekkefølgebetingelser. Andre reflekterte vanlige LLM-atferder, som unødvendig typegjenkjenning eller inkonsekvent håndtering av store og små bokstaver.

Disse observasjonene forsterket et av de sentrale funnene i arbeidet vårt: arkitektur er like viktig som modellvalg. Henting, skjemakobling, validering og selvkorrigering bidro like mye til den endelige ytelsen som den underliggende språkmodellen.

Selv om begrensninger i referanseindeksen uunngåelig påvirker den endelige poengsummen, tyder analysen vår på at ytterligere forbedringer i konteksthåndtering og validering kan presse systemet utover 90 % utførelsesnøyaktighet.

Ser fremover

Spider 1.0 ga et viktig grunnlag for evaluering av vår Data Agent, men den representerer bare det første skrittet mot produksjonsklar AI for bedrifter.

Vårt neste fokus er å evaluere arkitekturen på mer utfordrende benchmarks som Spider 2.0 og, enda viktigere, på reelle bedriftsdatabaser der skjemaer er betydelig større, dokumentasjonen ofte er ufullstendig og forretningsspørsmål er langt mer komplekse.

Målet vårt er ikke bare å bygge et nytt tekst-til-SQL-system. Vi bygger intelligente dataagenter som kombinerer gjenfinning, resonnering, validering og forklaringsevne for å hjelpe organisasjoner med å samhandle med bedriftsdata naturlig og pålitelig.

Ekran Resmi 2026-07-10 15.41.38.png

Referanser

[1] Saumya Chaturvedi, Aman Chadha, Laurent Bindschaedler arXiv. «SQL-of-Thought: Multiagentisk tekst-til-SQL med veiledet feilretting.» arXiv. Juni 2026 https://arxiv.org/abs/2509.00581

[2] Dawei Gao, Haibin Wang, Yaliang Li, Xiuyu Sun, Yichen Qian, Bolin Ding, Jingren Zhou “Text-to-SQL Empowered by Large Language Models: A Benchmark Evaluation” arXiv. juni 2026

https://arxiv.org/pdf/2308.15363 

[3] Mohammadreza Pourreza, Davood Rafiei. «DIN-SQL: Dekomponert kontekstbasert læring av tekst-til-SQL med selvkorreksjon» arXiv. Juni 2026

https://arxiv.org/pdf/2304.11015


Dilşen YILDAR HAVAYLAR, 

Senior programvareingeniør, mastergrad.