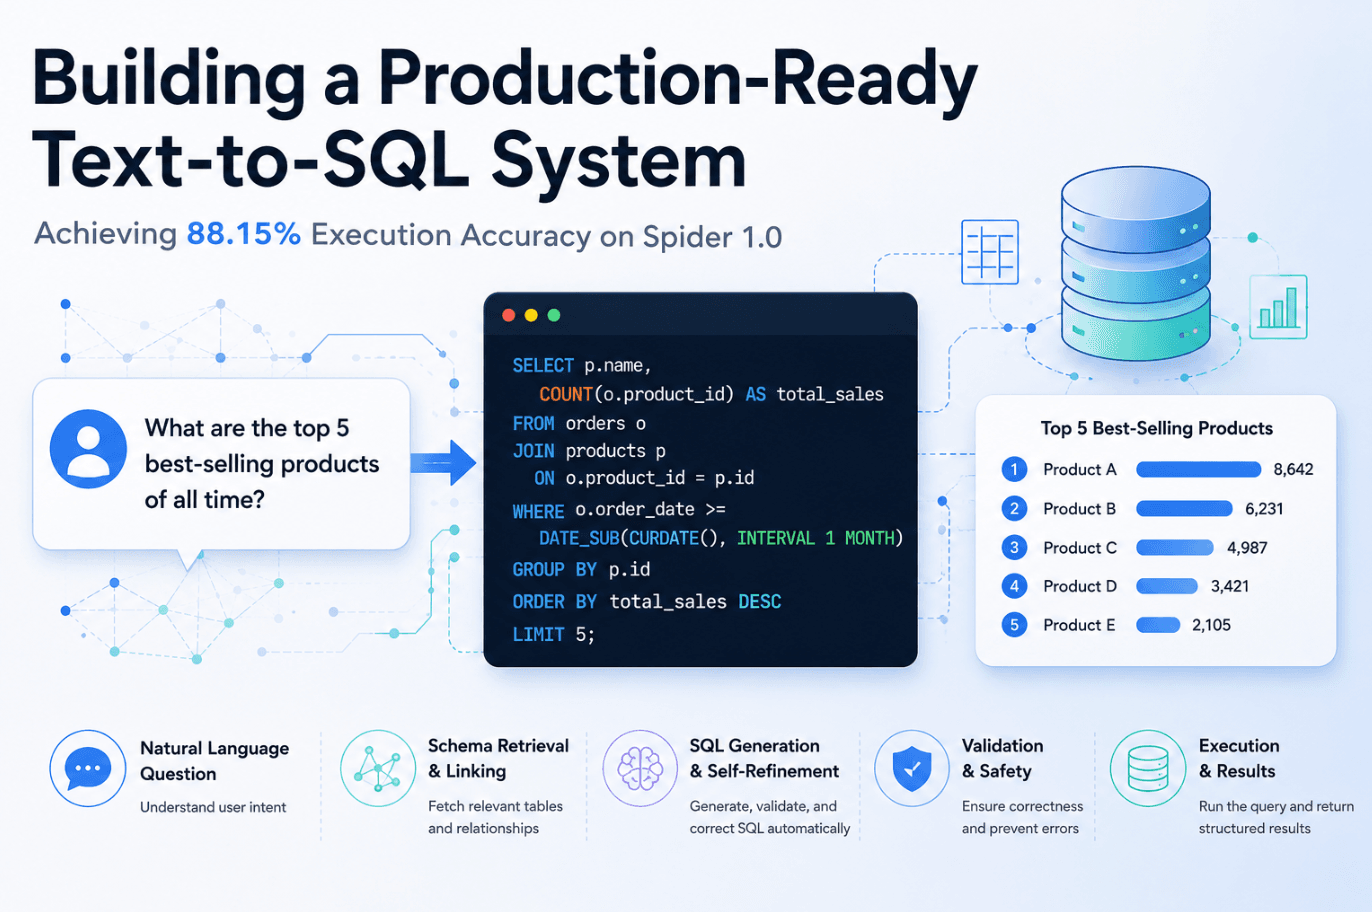
Budowanie gotowego do produkcji systemu Text-to-SQL: osiągnięcie 88.15% w Spider 1.0
Data publikacji
July 13, 2026
Udziały
Streszczenie
Zbudowanie gotowego do produkcji systemu Text-to-SQL wymaga znacznie więcej niż generowania kodu SQL za pomocą rozbudowanego modelu językowego. Aplikacje korporacyjne wymagają dokładnego zrozumienia schematu, pobierania kontekstu, walidacji i korekcji błędów, aby generować wiarygodne wyniki w bazach danych, których wcześniej nie widziano.
W niniejszym badaniu testujemy naszego Agenta Danych w oparciu o platformę Spider 1.0 i osiągamy dokładność wykonania na poziomie 88.15%, korzystając z modelu Gemma 4 26B . Zamiast skupiać się wyłącznie na wynikach testów porównawczych, artykuł omawia decyzje architektoniczne, wnioski z inżynierii i wnioski z testów porównawczych, które stoją za tymi wynikami.
Poza generowaniem SQL
Duże modele językowe znacząco usprawniły generowanie kodu SQL, ale zbudowanie gotowego do produkcji systemu Text-to-SQL wymaga znacznie więcej niż tylko przetłumaczenia języka naturalnego na SQL. Aplikacje korporacyjne muszą rozumieć złożone schematy baz danych, wyszukiwać odpowiedni kontekst, weryfikować wygenerowane zapytania i generować wiarygodne wyniki w bazach danych, z którymi nigdy wcześniej nie miały do czynienia.
Aby ocenić te możliwości, przeprowadziliśmy testy naszego Data Agenta w oparciu o Spider 1.0, najpopularniejszy test porównawczy Text-to-SQL. Korzystając z modelu Gemma 4 26B , nasz system osiągnął dokładność wykonania na poziomie 88.15% , co dowodzi, że architektura i zarządzanie kontekstem są równie ważne, jak wybór modelu.
Dlaczego Spider 1.0?
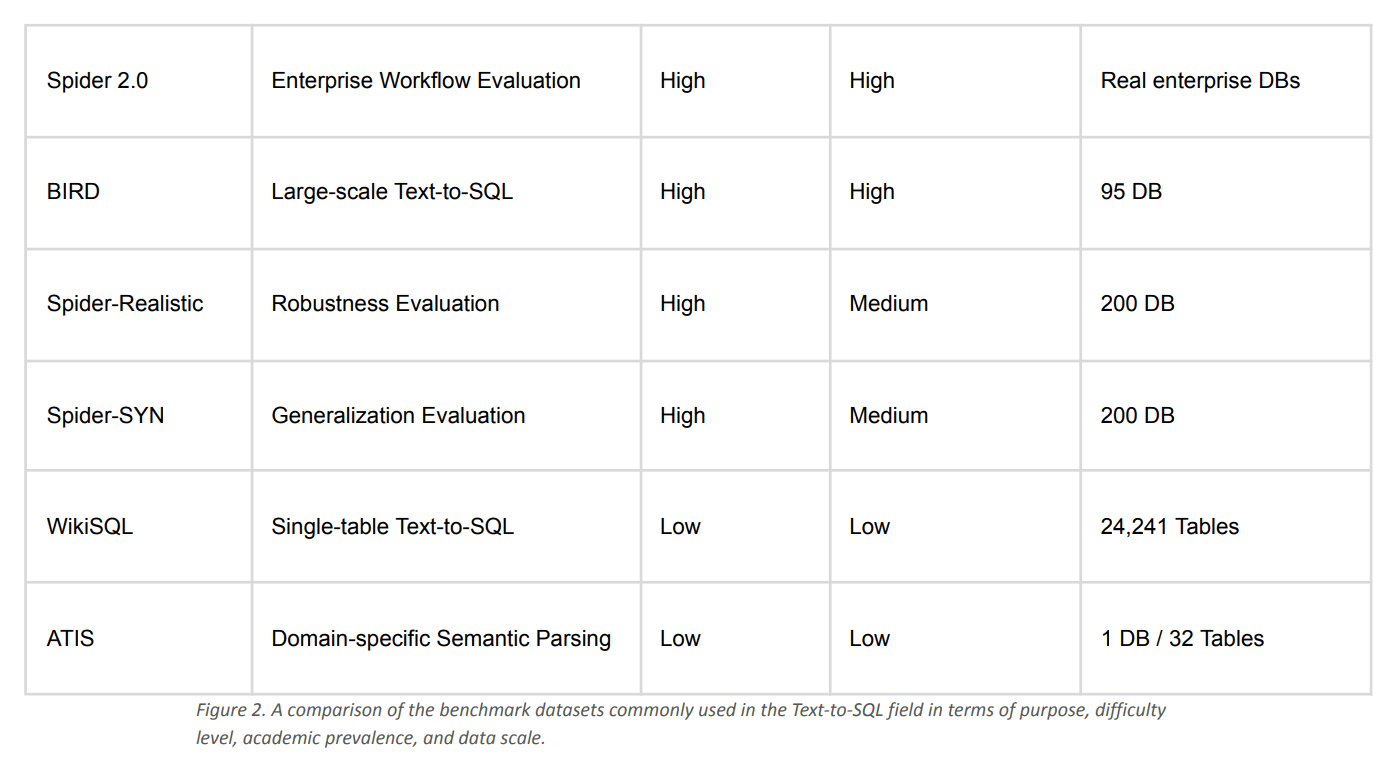
Wybór odpowiedniego benchmarku jest równie ważny, jak wybór odpowiedniego modelu. Chociaż nowsze zestawy danych, takie jak Spider 2.0 i BIRD, wprowadzają bardziej złożone scenariusze korporacyjne, Spider 1.0 pozostaje najszerzej stosowanym benchmarkiem do oceny systemów Text-to-SQL i porównywania wyników w literaturze.
Do wstępnej oceny wybraliśmy Spider 1.0, ponieważ zapewnia on ustandaryzowany i ugruntowany punkt odniesienia. Pozwala nam zmierzyć, jak skutecznie nasz Agent Danych rozumie dotychczas nieznane schematy baz danych i generuje poprawne dane SQL w realistycznych warunkach.
Na rysunku 2 podsumowano porównanie Spider 1.0 z innymi powszechnie stosowanymi testami porównawczymi Text-to-SQL.
Budowanie agenta danych
Osiągnięcie wysokiej dokładności konwersji tekstu na SQL nie polega jedynie na wykorzystaniu większego modelu językowego. W trakcie naszych testów porównawczych odkryliśmy, że architektura i zarządzanie kontekstem mają większy wpływ na wydajność niż sam wybór modelu.
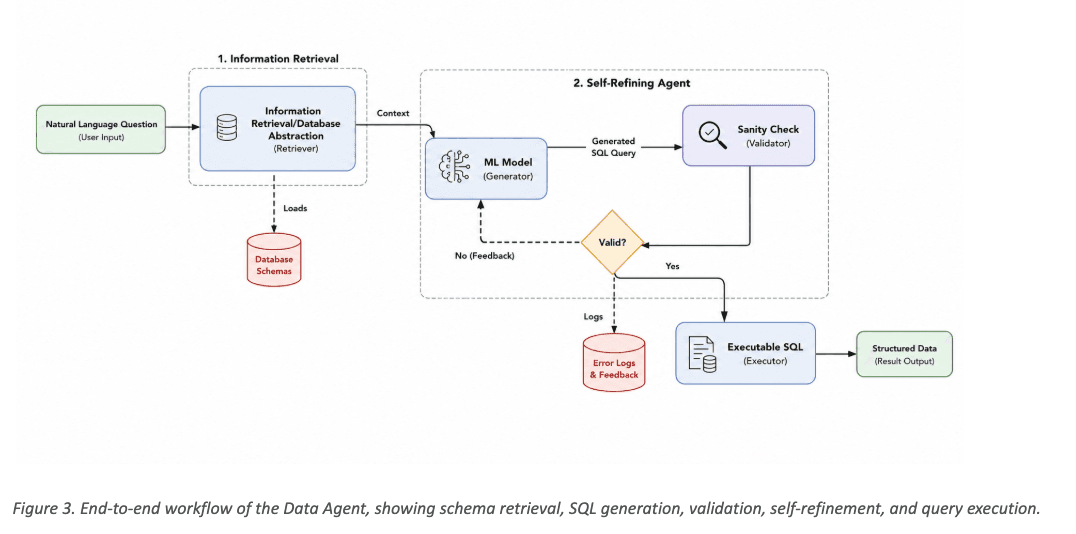
Nasz agent danych został zaprojektowany jako wieloetapowy proces, który stopniowo zawęża problem, zanim LLM zleci wygenerowanie kodu SQL. Zamiast udostępniać modelowi cały schemat bazy danych, system najpierw pobiera tylko odpowiedni schemat i informacje kontekstowe, a następnie generuje zapytanie SQL, weryfikuje wynik i automatycznie koryguje typowe błędy przed wykonaniem.
Jak pokazano na rysunku 3 , architektura składa się z trzech głównych etapów:
Wyszukiwanie informacji – Pytanie użytkownika jest analizowane w celu zidentyfikowania odpowiednich obiektów bazy danych, a z magazynu metadanych pobierane są tylko niezbędne informacje o schemacie.
Środek samorafinujący – Model języka generuje kod SQL, weryfikuje zapytanie względem pobranego schematu i automatycznie je udoskonala, gdy walidacja się nie powiedzie.
Wykonanie i reakcja – Po sprawdzeniu poprawności zapytania SQL jest ono wykonywane w bazie danych docelowej, a wyniki są zwracane w postaci danych strukturalnych lub odpowiedzi w języku naturalnym.
Ta zorientowana na produkcję architektura jest inspirowana ideami wprowadzonymi w DIN-SQL i DAIL-SQL , a jednocześnie jest dostosowana do środowisk korporacyjnych, w których niezawodność, możliwość wyjaśnienia i solidność są tak samo ważne jak dokładność testów porównawczych.
Nasza podróż porównawcza
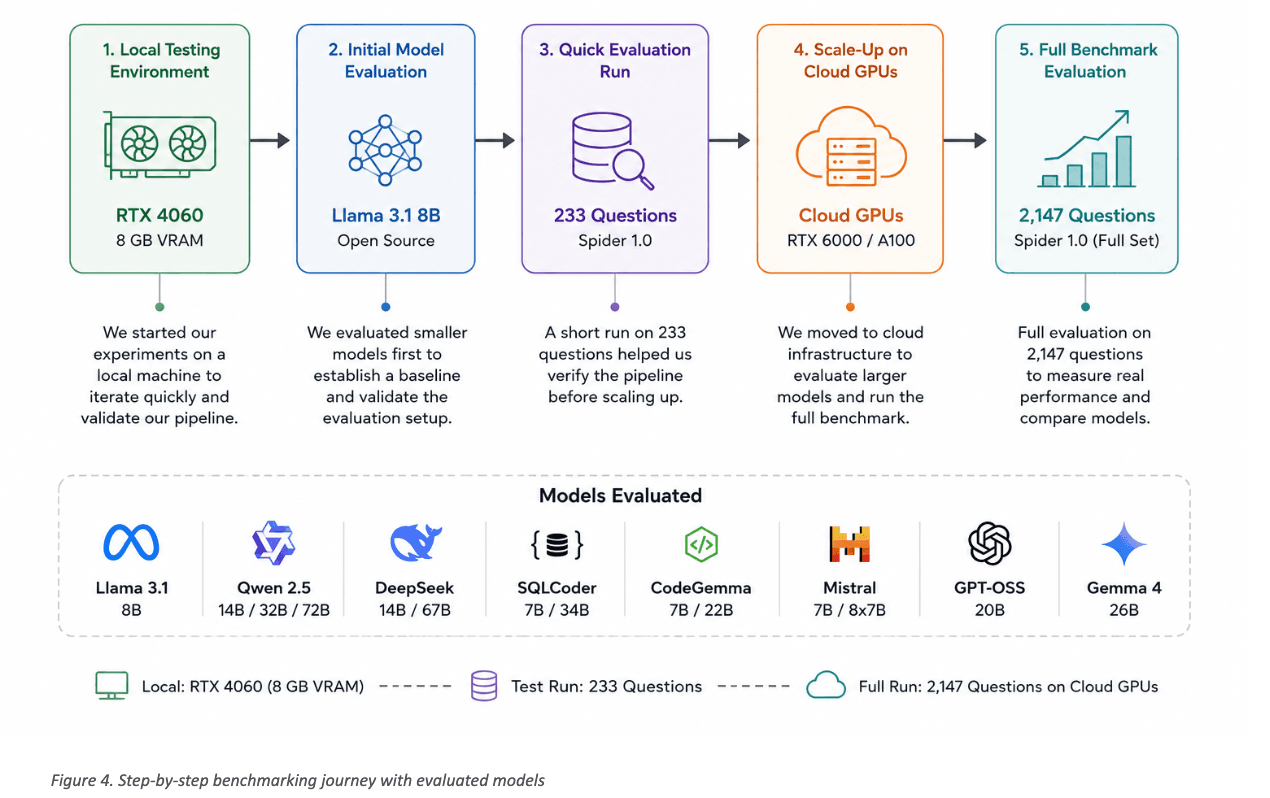
Wybór odpowiedniego modelu językowego był ważnym elementem naszego procesu benchmarkingu. Zamiast oceniać pojedynczy model, eksperymentowaliśmy z szeroką gamą open-source’owych programów LLM, w tym Llama 3.1, Qwen 2.5, DeepSeek, SQLCoder, CodeGemma, Mistral, GPT-OSS i Gemma 4.
Aby zapewnić uczciwe porównanie, każdy model oceniliśmy za pomocą wskaźnika dokładności wykonania (Execution Accuracy – EA) , standardowej metryki stosowanej w testach porównawczych konwersji tekstu na SQL. W przeciwieństwie do metryk opartych na składni, wskaźnik dokładności wykonania mierzy, czy wygenerowany kod SQL zwraca taki sam wynik, jak zapytanie referencyjne, co czyni go lepszym wskaźnikiem rzeczywistej wydajności.
Naszą ścieżkę testowania zilustrowano na rysunku 4. Rozpoczęliśmy od eksperymentów na lokalnej stacji roboczej wyposażonej w kartę graficzną RTX 4060 (8 GB pamięci VRAM) , gdzie mniejsze modele pozwoliły nam na szybkie iteracje i walidację naszego procesu. Po ustaleniu stabilnej linii bazowej przy użyciu podzbioru 233 pytań Spider 1.0, przeszliśmy na procesory graficzne w chmurze, aby ocenić większe modele w pełnym teście porównawczym , składającym się z 2,147 pytań . To etapowe podejście pozwoliło nam na efektywną optymalizację architektury przed zainwestowaniem w testy porównawcze na dużą skalę.
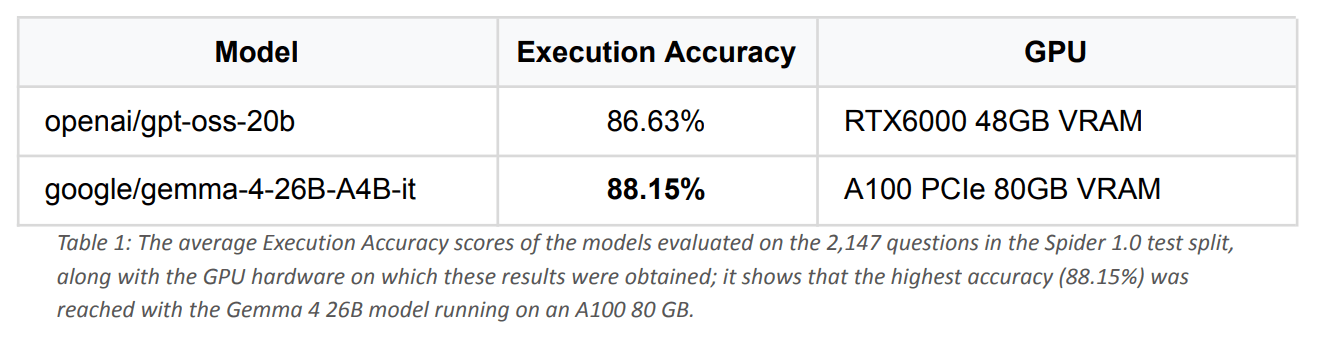
Oceniliśmy ostateczne modele w pełnym teście Spider 1.0, zawierającym 2,147 pytań. Jak pokazano w tabeli 1, Gemma 4 26B uzyskała najwyższy wynik (88.15%), a następnie GPT-OSS 20B (86.63%). Wyniki te dowodzą, że nowoczesne, otwarte programy nauczania (LLM), w połączeniu z efektywnym procesem wyszukiwania i walidacji, mogą osiągnąć wysoce konkurencyjną wydajność konwersji tekstu na SQL.
Jak mają się te wyniki do siebie?
Wyniki benchmarków mają sens tylko wtedy, gdy można je porównać z wcześniej opublikowanymi pracami. Aby lepiej zrozumieć istotność naszych wyników, przeanalizowaliśmy zarówno najnowsze badania dotyczące przetwarzania tekstu na SQL, jak i szeroko cytowane artykuły benchmarkowe.
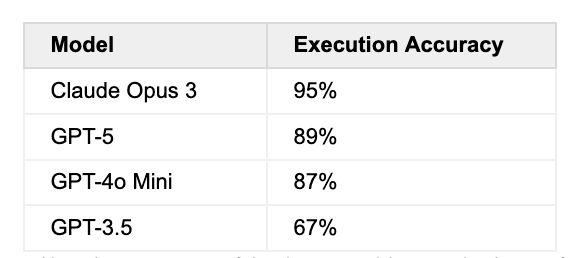
Tabela 2: Wskaźniki dokładności modeli o zamkniętym kodzie źródłowym podane w badaniu SQL-of-Thought na podzbiorze danych Spider; w ujęciu porównawczym pokazuje to, że wynik 88.15% uzyskany w tej pracy plasuje się powyżej GPT-4o Mini (87%) i na poziomie zbliżonym do GPT-5 (89%).
Najnowsze prace, takie jak SQL-of-Thought [1], donoszą, że wiodące modele o zamkniętym kodzie źródłowym – w tym Claude Opus 3, GPT-5 i GPT-4o Mini – osiągają wysoką dokładność w podzbiorach testów porównawczych Spider. Chociaż bezpośrednie porównania należy interpretować ostrożnie ze względu na różnice w ustawieniach oceny, monitach i podzbiorach testów porównawczych, nasza dokładność wykonania na poziomie 88.15% pokazuje, że modele o otwartym kodzie źródłowym mogą osiągać wydajność w tym samym konkurencyjnym zakresie.
Chociaż wyniki te pochodzą z różnych środowisk ewaluacyjnych i nie powinny być bezpośrednio porównywane, stanowią one użyteczny kontekst do zrozumienia obecnego krajobrazu wydajności systemów Text-to-SQL. Nasz benchmark pokazuje, że modele open-source mogą teraz konkurować z wiodącymi, zamkniętymi alternatywami, jeśli zostaną połączone z dobrze zaprojektowaną architekturą.
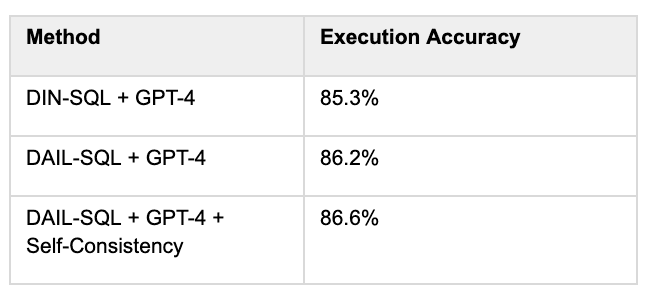
Porównaliśmy również nasze wyniki z zorientowanymi na produkcję frameworkami Text-to-SQL, takimi jak DIN-SQL [3] i DAIL-SQ L, które łączą duże modele językowe z technikami obejmującymi łączenie schematów, szybką inżynierię, samospójność i korekcję błędów.
Tabela 3: Wyniki dokładności wykonania różnych metod w Spider 1.0 w badaniu „Text-to-SQL Empowered by Large Language Models: A Benchmark Evaluation” [2]; ujawniają one wpływ na dokładność nie tylko wyboru modelu, ale także takich technik, jak szybka inżynieria, łączenie schematów i spójność wewnętrzna.
Nasze odkrycia potwierdzają wniosek podzielany przez całą najnowszą literaturę: wysoka wydajność konwersji tekstu na SQL zależy nie tylko od modelu języka, ale także od otaczającej architektury. Efektywne pobieranie schematu, zarządzanie kontekstem, walidacja i autokorekta są często równie ważne, jak sam model.
Czego się nauczyliśmy
Benchmarking to nie tylko pomiar dokładności, ale także zrozumienie, gdzie i dlaczego system zawodzi. W trakcie naszej oceny przeanalizowaliśmy błędne prognozy i zidentyfikowaliśmy kilka powtarzających się wzorców, które wpłynęły na końcowe wyniki.
Niektóre błędy wynikały z samego benchmarku. W kilku przypadkach niespójności w referencyjnych (złotych) zapytaniach SQL powodowały, że logicznie poprawne prognozy były oznaczane jako niepoprawne. W innych przypadkach występowały niejednoznaczne pytania w języku naturalnym lub sytuacje rozstrzygające remis, w których wiele zapytań SQL mogło dawać równie poprawne odpowiedzi.
Zaobserwowaliśmy również kilka zachowań specyficznych dla danego modelu, w tym niepotrzebne konwersje typów, niespójne przetwarzanie z uwzględnieniem wielkości liter oraz sporadyczne nadmierne komplikowanie prostych zapytań SQL. Odkrycia te podkreśliły wagę włączenia mechanizmów walidacji i autokorekty do potoku agenta danych.
Ogólnie rzecz biorąc, nasza analiza wykazała, że wiele pozostałych błędów nie było spowodowanych ograniczeniami samego modelu językowego, ale niejednoznacznościami w testach porównawczych lub przypadkach brzegowych w generowaniu kodu SQL. Sugeruje to, że dalsze usprawnienia w zakresie wyszukiwania, walidacji i zarządzania kontekstem mogłyby przesunąć system ponad próg 90% dokładności wykonania.
Koszt i wydajność
Wysoka dokładność to tylko jeden z aspektów gotowego do produkcji systemu Text-to-SQL. W środowiskach korporacyjnych równie ważne są koszty infrastruktury, prywatność danych i elastyczność wdrażania.
Jedną z kluczowych zalet naszego podejścia jest to, że opiera się ono w całości na modelach językowych typu open source. W trakcie całego procesu rozwoju mogliśmy przeprowadzić większość eksperymentów lokalnie, korzystając z konsumenckiej karty graficznej RTX 4060 (8 GB pamięci VRAM) , co pozwoliło nam na szybkie iteracje bez ponoszenia kosztów API ani tokenów. Większe testy porównawcze zostały przeprowadzone na dedykowanych procesorach graficznych w chmurze dopiero po walidacji architektury.
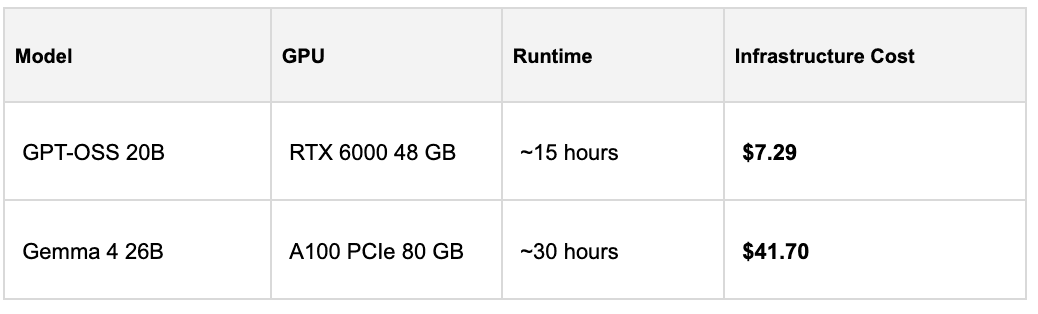
Do pełnej ewaluacji Spider 1.0 wykorzystaliśmy RunPod Secure Cloud. Test Gemma 4 26B został przeprowadzony na karcie graficznej A100 PCIe 80 GB, natomiast test GPT-OSS 20B został przeprowadzony na karcie graficznej RTX 6000 48 GB.
Koszty infrastruktury podsumowano w tabeli 4.
Chociaż największe testy porównawcze wymagały infrastruktury chmurowej, cały proces rozwoju pozostał opłacalny dzięki lokalnym eksperymentom i modelom open source. Co ważniejsze, powstała architektura może zostać wdrożona w całości w ramach własnej infrastruktury organizacji, eliminując zależność od zewnętrznych interfejsów API, a jednocześnie zapewniając większą kontrolę nad prywatnością danych, zgodnością z przepisami i kosztami operacyjnymi.
Dzięki temu architektura ta jest szczególnie przydatna dla organizacji działających w środowiskach wrażliwych pod względem prywatności, regulowanych lub odizolowanych od sieci, w których bezpieczeństwo danych i elastyczność wdrażania są wymogami krytycznymi.
Poza Pająkiem 1.0
Testy porównawcze zapewniają obiektywny sposób oceny systemów AI, ale nie są ostatecznym celem. Wysoki wynik testu porównawczego ma wartość tylko wtedy, gdy przekłada się na niezawodną wydajność w rzeczywistych zastosowaniach.
W toku naszych badań odkryliśmy, że zbudowanie gotowego do produkcji systemu Text-to-SQL to o wiele więcej niż generowanie kodu SQL. Zrozumienie schematów bazy danych, pobieranie odpowiedniego kontekstu, walidacja wygenerowanych zapytań i korygowanie błędnych wyników okazały się równie ważne, jak sam model języka.
Nasza dokładność wykonania na poziomie 88.15% w Spider 1.0 dowodzi, że modele open source w połączeniu z dobrze zaprojektowaną architekturą mogą zapewnić wysoce konkurencyjną wydajność w przypadku zadań przetwarzania tekstu na SQL w przedsiębiorstwach. Co ważniejsze, potwierdza to słuszność zasad projektowania naszego agenta danych , który został stworzony z myślą o niezawodnym działaniu na złożonych bazach danych przedsiębiorstw, a nie tylko na zbiorach danych testowych.
Spider 1.0 stanowi ważny kamień milowy, ale to dopiero początek naszej podróży. Nasze kolejne kroki obejmują ewaluację Data Agent w Spider 2.0 , testy porównawcze na większą skalę w przedsiębiorstwach oraz, co najważniejsze, rzeczywiste środowiska klientów, w których schematy baz danych są znacznie obszerniejsze, a kwestie biznesowe znacznie bardziej złożone.
Nasza długoterminowa wizja nie ogranicza się do zbudowania lepszego generatora SQL. Naszym celem jest stworzenie inteligentnych agentów danych, które umożliwią organizacjom interakcję z danymi przedsiębiorstwa tak naturalnie, jak komunikację z kolegami – łącząc wyszukiwanie, wnioskowanie, walidację i wyjaśnialną sztuczną inteligencję w niezawodną platformę wspomagania decyzji.
Kluczowe lekcje
Benchmarking nie polega wyłącznie na mierzeniu dokładności, lecz także na zrozumieniu, dlaczego system odnosi sukcesy lub ponosi porażki.
W trakcie naszej oceny zidentyfikowaliśmy kilka powtarzających się wzorców błędów. Niektóre z nich wynikały z niejednoznaczności w samym benchmarku, w tym niespójności w zapytaniach SQL referencyjnych i niedookreślonych warunków kolejności. Inne odzwierciedlały typowe zachowania LLM, takie jak niepotrzebne rzutowanie typów lub niespójna obsługa wartości uwzględniających wielkość liter.
Te obserwacje potwierdziły jeden z głównych wniosków naszej pracy: architektura ma równie duże znaczenie, co wybór modelu. Wyszukiwanie, łączenie schematów, walidacja i autokorekta wpłynęły na ostateczną wydajność w takim samym stopniu, jak bazowy model językowy.
Choć ograniczenia testów porównawczych mają nieunikniony wpływ na wynik końcowy, nasza analiza wskazuje, że dalsze usprawnienia w zakresie zarządzania kontekstem i walidacji mogą sprawić, że system przekroczy granicę 90% dokładności wykonania.
Patrząc w przyszłość
Spider 1.0 stanowił ważny punkt odniesienia do oceny naszego Agenta danych, ale stanowi on dopiero pierwszy krok w kierunku wdrożenia w przedsiębiorstwie sztucznej inteligencji gotowej do produkcji.
Teraz skupimy się na ocenie architektury w bardziej wymagających testach porównawczych, takich jak Spider 2.0 , a co ważniejsze, na rzeczywistych bazach danych przedsiębiorstw, w których schematy są znacznie większe, dokumentacja często niekompletna, a pytania biznesowe znacznie bardziej złożone.
Naszym celem nie jest po prostu zbudowanie kolejnego systemu Text-to-SQL. Budujemy inteligentne agenty danych , które łączą w sobie funkcje wyszukiwania, wnioskowania, walidacji i wyjaśniania, aby pomóc organizacjom w naturalnej i niezawodnej interakcji z danymi przedsiębiorstwa.
Referencje
[1] Saumya Chaturvedi, Aman Chadha, Laurent Bindschaedler arXiv. „SQL-of-Thought: wieloagentowe przetwarzanie tekstu na SQL z kierowaną korekcją błędów”. arXiv. Czerwiec 2026 r. https://arxiv.org/abs/2509.00581
[2] Dawei Gao, Haibin Wang, Yaliang Li, Xiuyu Sun, Yichen Qian, Bolin Ding, Jingren Zhou „Przetwarzanie tekstu na SQL wspomagane przez duże modele językowe: ocena porównawcza” arXiv. Czerwiec 2026