Construindo um sistema de conversão de texto em SQL pronto para produção: alcançando 88.15% no Spider 1.0
Data de publicação
13 de julho de 2026
Compartilhar
Sumário Executivo
Construir um sistema de conversão de texto para SQL pronto para produção exige muito mais do que gerar SQL com um modelo de linguagem amplo. Aplicações empresariais demandam compreensão precisa do esquema, recuperação de contexto, validação e correção de erros para produzir resultados confiáveis em bancos de dados nunca antes vistos.
Neste estudo, avaliamos o desempenho do nosso Agente de Dados no Spider 1.0 e alcançamos uma Precisão de Execução de 88.15% usando o modelo Gemma 4 26B . Em vez de focar apenas nos resultados dos testes de desempenho, este artigo compartilha as decisões arquitetônicas, as lições de engenharia e as percepções obtidas com os testes de desempenho que embasaram esses resultados.
Além da geração de SQL
Grandes modelos de linguagem melhoraram significativamente a geração de SQL, mas construir um sistema de texto para SQL pronto para produção exige muito mais do que traduzir linguagem natural em SQL. Aplicativos corporativos precisam entender esquemas de banco de dados complexos, recuperar o contexto correto, validar as consultas geradas e produzir resultados confiáveis em bancos de dados que nunca viram antes.
Para avaliar essas capacidades, realizamos um benchmark do nosso Agente de Dados no Spider 1.0, o benchmark de conversão de texto para SQL mais utilizado. Usando o modelo Gemma 4 26B , nosso sistema alcançou uma Precisão de Execução de 88.15% , demonstrando que a arquitetura e o gerenciamento de contexto são tão importantes quanto a seleção do modelo.
Por que o Spider 1.0?
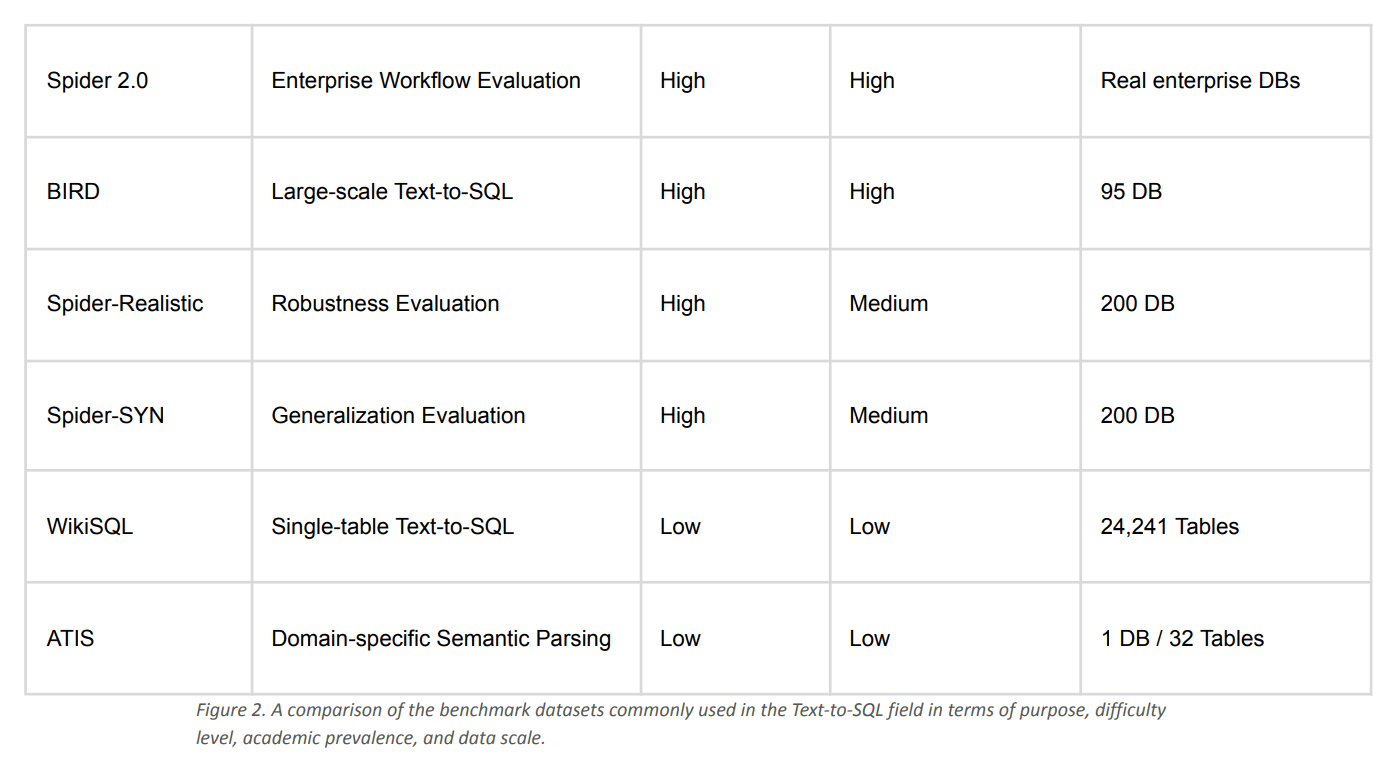
Escolher o benchmark correto é tão importante quanto escolher o modelo correto. Embora conjuntos de dados mais recentes, como o Spider 2.0 e o BIRD, introduzam cenários empresariais mais complexos, o Spider 1.0 continua sendo o benchmark mais amplamente adotado para avaliar sistemas de conversão de texto em SQL e comparar resultados na literatura.
Para nossa avaliação inicial, selecionamos o Spider 1.0 porque ele fornece uma base de referência padronizada e bem estabelecida. Isso nos permite medir a eficácia com que nosso Agente de Dados compreende esquemas de banco de dados nunca vistos antes e gera SQL correto em condições realistas.
A Figura 2 resume como o Spider 1.0 se compara com outros benchmarks de conversão de texto para SQL comumente usados.
Construindo o Agente de Dados
Obter alta precisão na conversão de texto para SQL não se resume simplesmente a usar um modelo de linguagem maior. Ao longo do nosso processo de avaliação comparativa, descobrimos que a arquitetura e o gerenciamento de contexto tiveram um impacto maior no desempenho do que a seleção do modelo por si só.
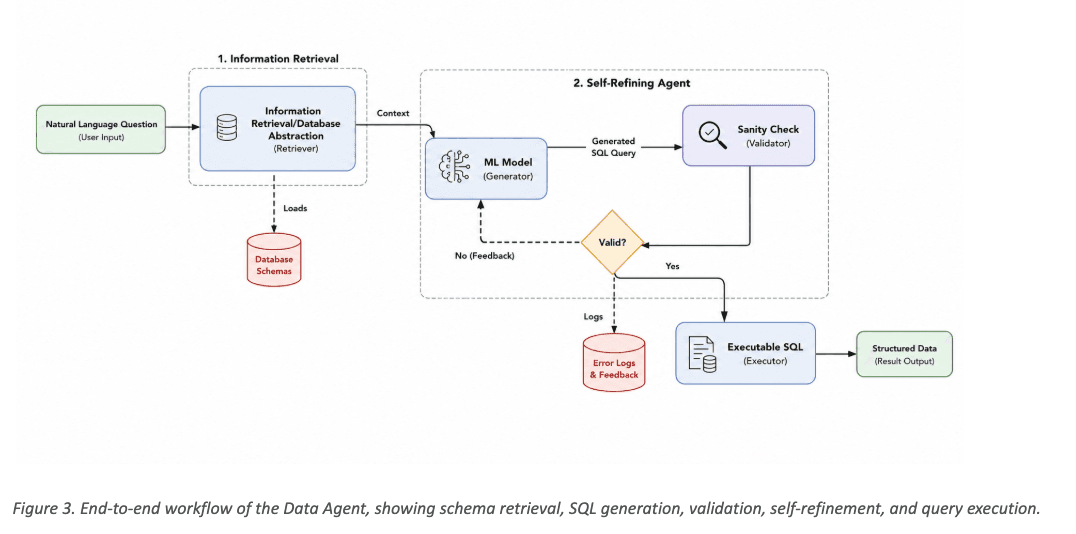
Nosso Agente de Dados foi projetado como um pipeline de múltiplos estágios que reduz progressivamente o problema antes de solicitar ao LLM (Modelo de Aprendizado de Liderança) a geração de SQL. Em vez de expor todo o esquema do banco de dados ao modelo, o sistema primeiro recupera apenas o esquema relevante e as informações contextuais, depois gera uma consulta SQL, valida o resultado e corrige automaticamente erros comuns antes da execução.
Conforme ilustrado na Figura 3 , a arquitetura consiste em três etapas principais:
Recuperação de informação – A pergunta do usuário é analisada para identificar os objetos relevantes do banco de dados, e somente as informações de esquema necessárias são recuperadas do repositório de metadados.
Agente de auto-refinamento – O modelo de linguagem gera SQL, valida a consulta em relação ao esquema recuperado e a refina automaticamente sempre que a validação falha.
Execução e Resposta – Após a validação, a consulta SQL é executada no banco de dados de destino e os resultados são retornados como dados estruturados ou uma resposta em linguagem natural.
Essa arquitetura orientada à produção é inspirada em ideias introduzidas no DIN-SQL e no DAIL-SQL , sendo adaptada para ambientes corporativos onde confiabilidade, explicabilidade e robustez são tão importantes quanto a precisão dos benchmarks.
Nossa jornada de benchmarking
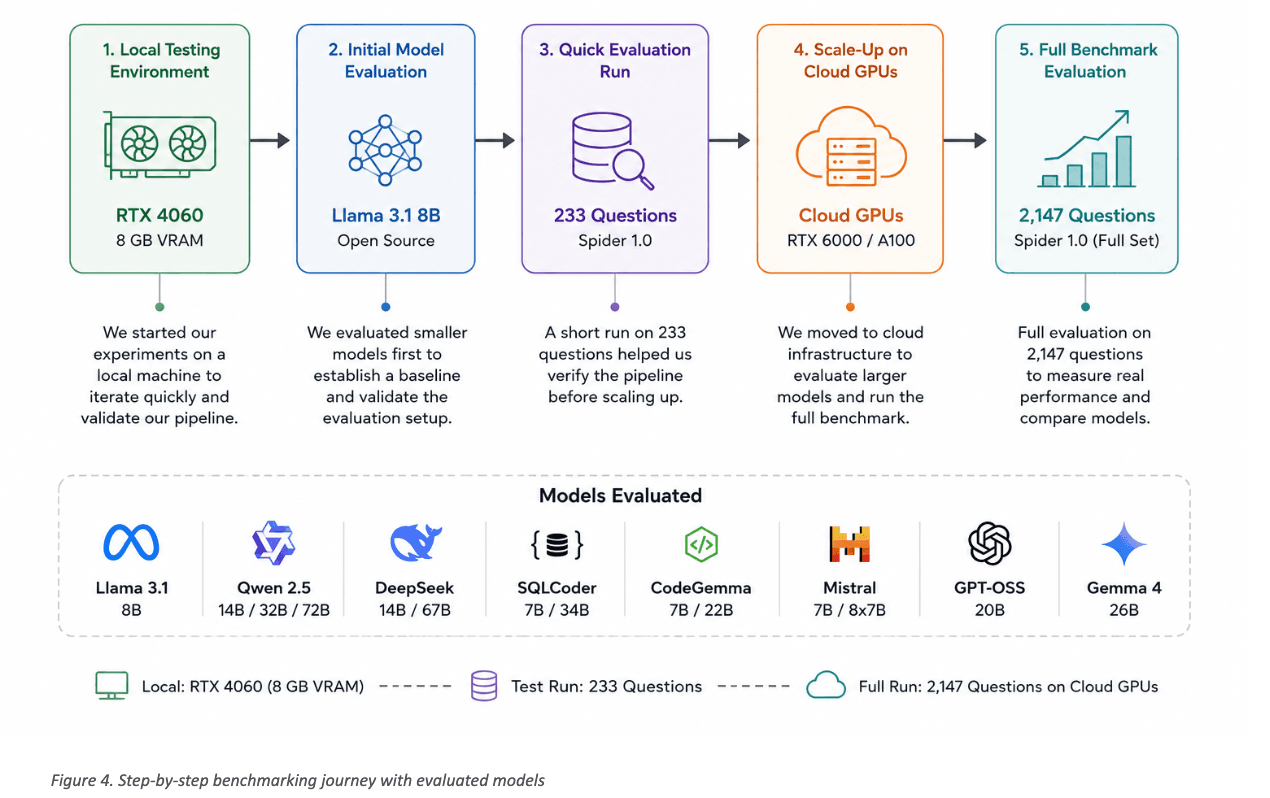
A seleção do modelo de linguagem adequado foi uma parte importante do nosso processo de avaliação comparativa. Em vez de avaliar um único modelo, experimentamos uma ampla gama de modelos de linguagem de código aberto, incluindo Llama 3.1, Qwen 2.5, DeepSeek, SQLCoder, CodeGemma, Mistral, GPT-OSS e Gemma 4.
Para garantir uma comparação justa, avaliamos cada modelo usando a Precisão de Execução (EA) , a métrica padrão para benchmarking de conversão de texto em SQL. Ao contrário das métricas baseadas em sintaxe, a Precisão de Execução mede se o SQL gerado retorna o mesmo resultado que a consulta de referência, tornando-se um indicador melhor do desempenho em situações reais.
Nossa jornada de avaliação comparativa está ilustrada na Figura 4. Começamos experimentando em uma estação de trabalho local equipada com uma RTX 4060 (8 GB de VRAM) , onde modelos menores nos permitiram iterar rapidamente e validar nosso pipeline. Após estabelecer uma linha de base estável usando um subconjunto de 233 questões do Spider 1.0, migramos para GPUs na nuvem para avaliar modelos maiores no conjunto completo de 2,147 questões do benchmark. Essa abordagem em etapas nos permitiu otimizar a arquitetura de forma eficiente antes de investir em execuções de benchmark em larga escala.
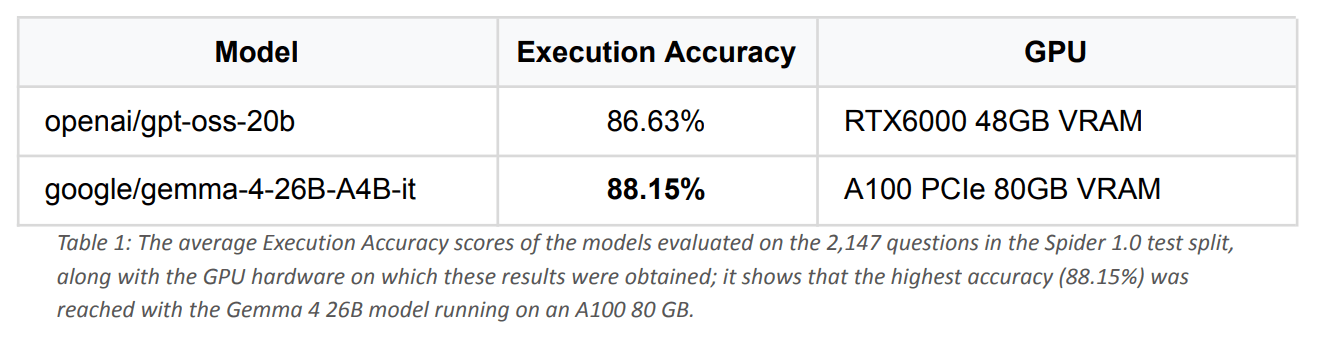
Avaliamos os modelos finais na versão completa do teste Spider 1.0, contendo 2,147 questões. Como mostrado na Tabela 1, o Gemma 4 26B obteve a maior pontuação (88.15%), seguido pelo GPT-OSS 20B (86.63%). Esses resultados demonstram que os modelos de linguagem de código aberto modernos, quando combinados com um pipeline de recuperação e validação eficaz, podem alcançar um desempenho altamente competitivo na conversão de texto em SQL.
Como se comparam esses resultados?
Os resultados dos benchmarks só são significativos quando podem ser comparados com trabalhos publicados anteriormente. Para melhor compreender a relevância dos nossos resultados, analisamos tanto estudos recentes de conversão de texto em SQL quanto artigos de benchmark amplamente referenciados.
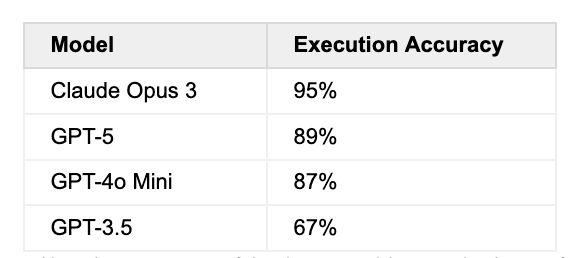
Tabela 2: As taxas de precisão dos modelos de código fechado relatadas no estudo SQL-of-Thought em um subconjunto do conjunto de dados Spider; mostra, em termos comparativos, que o resultado de 88.15% obtido neste trabalho está posicionado acima do GPT-4o Mini (87%) e em um nível próximo ao GPT-5 (89%).
Trabalhos recentes, como o SQL-of-Thought [1], relatam que os principais modelos de código fechado — incluindo Claude Opus 3, GPT-5 e GPT-4o Mini — alcançam alta precisão em subconjuntos do benchmark Spider. Embora comparações diretas devam ser interpretadas com cautela devido às diferenças nas configurações de avaliação, prompts e subconjuntos do benchmark, nossa Precisão de Execução de 88.15% demonstra que os modelos de código aberto podem alcançar desempenho dentro da mesma faixa competitiva.
Embora esses resultados provenham de diferentes configurações de avaliação e não devam ser comparados diretamente, eles fornecem um contexto útil para a compreensão do panorama atual de desempenho dos sistemas de conversão de texto para SQL. Nosso benchmark demonstra que os modelos de código aberto agora podem competir com as principais alternativas proprietárias quando combinados com uma arquitetura bem projetada.
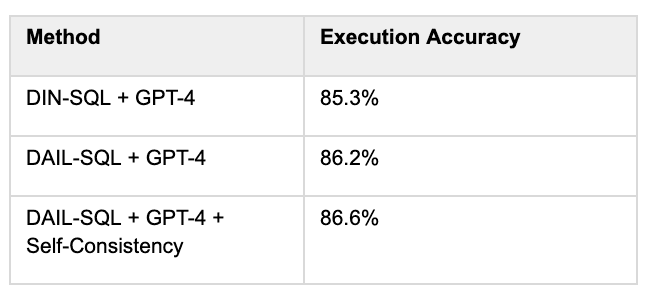
Também comparamos nossos resultados com estruturas Text-to-SQL orientadas à produção, como DIN-SQL [3] e DAIL-SQL , que combinam grandes modelos de linguagem com técnicas incluindo vinculação de esquema, engenharia de prompts, autoconsistência e correção de erros.
Tabela 3: Os resultados de precisão de execução de diferentes métodos no Spider 1.0 no estudo "Text-to-SQL Empowered by Large Language Models: A Benchmark Evaluation" [2]; revela o impacto na precisão não apenas da seleção do modelo, mas também de técnicas como engenharia de prompts, vinculação de esquemas e autoconsistência.
Nossos resultados reforçam uma conclusão compartilhada na literatura recente: o alto desempenho da conversão de texto para SQL depende não apenas do modelo de linguagem, mas também da arquitetura subjacente. A recuperação eficaz do esquema, o gerenciamento do contexto, a validação e a autocorreção são frequentemente tão importantes quanto o próprio modelo.
O que aprendemos
A avaliação comparativa não se resume apenas a medir a precisão — trata-se também de compreender onde e por que um sistema falha. Ao longo de nossa avaliação, analisamos previsões incorretas e identificamos diversos padrões recorrentes que afetaram as pontuações finais.
Alguns erros originaram-se do próprio benchmark. Em um pequeno número de casos, inconsistências nas consultas SQL de referência (ouro) fizeram com que previsões logicamente corretas fossem marcadas como incorretas. Outros casos envolveram perguntas ambíguas em linguagem natural ou cenários de desempate, onde múltiplas consultas SQL poderiam legitimamente produzir respostas igualmente válidas.
Também observamos diversos comportamentos específicos do modelo, incluindo conversões de tipo desnecessárias, tratamento inconsistente da diferenciação entre maiúsculas e minúsculas e, ocasionalmente, complexidade excessiva de consultas SQL que, de outra forma, seriam simples. Essas descobertas reforçaram a importância de incorporar mecanismos de validação e autocorreção no pipeline do Agente de Dados.
Em geral, nossa análise mostrou que muitos dos erros restantes não foram causados por limitações do próprio modelo de linguagem, mas por ambiguidades no benchmark ou casos extremos na geração de SQL. Isso sugere que melhorias adicionais na recuperação, validação e gerenciamento de contexto poderiam levar o sistema a ultrapassar o limite de 90% de precisão de execução.
Custo e Eficiência
A alta precisão é apenas um aspecto de um sistema de conversão de texto para SQL pronto para produção. Em ambientes corporativos, o custo da infraestrutura, a privacidade dos dados e a flexibilidade de implantação são considerações igualmente importantes.
Uma das principais vantagens da nossa abordagem é que ela se baseia inteiramente em modelos de linguagem de código aberto. Ao longo do processo de desenvolvimento, conseguimos realizar a maioria dos experimentos localmente usando uma placa de vídeo RTX 4060 (8 GB de VRAM) de nível consumidor , o que nos permitiu iterar rapidamente sem incorrer em custos de API ou tokens. Os testes de benchmark mais complexos foram executados em GPUs dedicadas na nuvem somente após a validação da arquitetura.
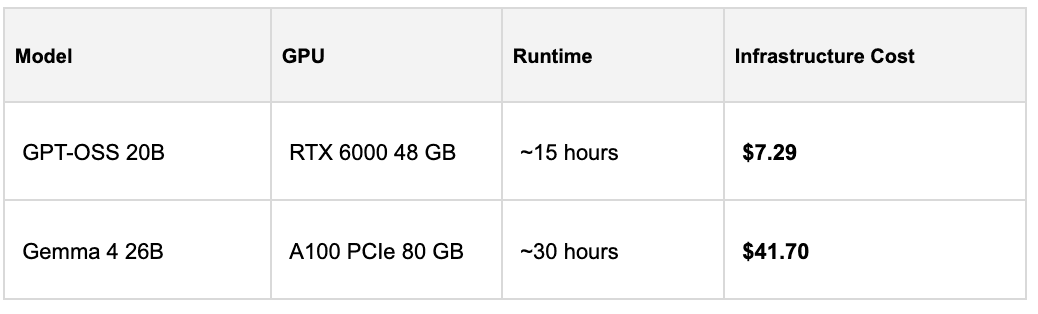
Utilizamos o RunPod Secure Cloud para a avaliação completa do Spider 1.0. O benchmark Gemma 4 26B foi executado em uma GPU A100 PCIe de 80 GB, enquanto o GPT-OSS 20B foi executado em uma GPU RTX 6000 de 48 GB.
Os custos de infraestrutura estão resumidos na Tabela 4.
Embora os testes de benchmark mais complexos exigissem infraestrutura em nuvem, o processo de desenvolvimento como um todo manteve-se economicamente viável graças à experimentação local e aos modelos de código aberto. Mais importante ainda, a arquitetura resultante pode ser implementada integralmente na infraestrutura da própria organização, eliminando a dependência de APIs externas e proporcionando maior controle sobre a privacidade dos dados, a conformidade e os custos operacionais.
Isso torna a arquitetura particularmente adequada para organizações que operam em ambientes sensíveis à privacidade, regulamentados ou isolados da internet, onde a segurança de dados e a flexibilidade de implantação são requisitos essenciais.
Além da Aranha 1.0
Os benchmarks fornecem uma maneira objetiva de avaliar sistemas de IA, mas não são o objetivo final. Uma pontuação alta em benchmarks só é valiosa se se traduzir em desempenho confiável em aplicações do mundo real.
Ao longo deste estudo, descobrimos que construir um sistema de conversão de texto em SQL pronto para produção envolve muito mais do que gerar SQL. Compreender os esquemas de banco de dados, recuperar o contexto correto, validar as consultas geradas e refinar as saídas incorretas provaram ser tão importantes quanto o próprio modelo de linguagem.
Nossa precisão de execução de 88.15% no Spider 1.0 demonstra que modelos de código aberto, combinados com uma arquitetura bem projetada, podem oferecer desempenho altamente competitivo para tarefas corporativas de conversão de texto em SQL. Mais importante ainda, isso valida os princípios de design por trás do nosso Agente de Dados , que foi desenvolvido para operar de forma confiável em bancos de dados corporativos complexos, e não apenas em conjuntos de dados de referência.
O Spider 1.0 representa um marco importante, mas é apenas o começo da nossa jornada. Nossos próximos passos incluem avaliar o Agente de Dados no Spider 2.0 , realizar benchmarks em escala empresarial e, principalmente, em ambientes reais de clientes, onde os esquemas de banco de dados são significativamente maiores e as questões de negócios são muito mais complexas.
Nossa visão de longo prazo não é simplesmente construir um gerador de SQL melhor. Nosso objetivo é criar Agentes de Dados inteligentes que permitam às organizações interagir com dados corporativos de forma tão natural quanto se comunicam com um colega — combinando recuperação, raciocínio, validação e IA explicável em uma plataforma confiável de suporte à decisão.
Principais lições
A avaliação comparativa não se trata apenas de medir a precisão — trata-se de entender por que um sistema tem sucesso ou falha.
Ao longo de nossa avaliação, identificamos diversos padrões de erro recorrentes. Alguns originaram-se de ambiguidades no próprio benchmark, incluindo inconsistências em consultas SQL de referência e condições de ordenação pouco especificadas. Outros refletiram comportamentos comuns do LLM, como conversão de tipo desnecessária ou tratamento inconsistente de valores que diferenciam maiúsculas de minúsculas.
Essas observações reforçaram uma das principais conclusões do nosso trabalho: a arquitetura importa tanto quanto a seleção do modelo. A recuperação, a vinculação de esquemas, a validação e a autocorreção contribuíram tanto para o desempenho final quanto o modelo de linguagem subjacente.
Embora as limitações dos parâmetros de referência inevitavelmente afetem a pontuação final, nossa análise sugere que melhorias adicionais no gerenciamento e validação do contexto poderiam levar o sistema a ultrapassar a marca de 90% de Precisão de Execução.
Olhando para o futuro
O Spider 1.0 forneceu uma base importante para avaliar nosso Agente de Dados, mas representa apenas o primeiro passo rumo a uma IA empresarial pronta para produção.
Nosso próximo foco é avaliar a arquitetura em benchmarks mais desafiadores, como o Spider 2.0 e, mais importante, em bancos de dados empresariais reais, onde os esquemas são significativamente maiores, a documentação geralmente é incompleta e as questões de negócios são muito mais complexas.
Nosso objetivo não é simplesmente construir mais um sistema de conversão de texto em SQL. Estamos criando Agentes de Dados inteligentes que combinam recuperação, raciocínio, validação e explicabilidade para ajudar as organizações a interagir com os dados corporativos de forma natural e confiável.
Referências
[1] Saumya Chaturvedi, Aman Chadha, Laurent Bindschaedler arXiv. “SQL-of-Thought: Multi-agentic Text-to-SQL with Guided Error Correction.” arXiv. Junho de 2026 https://arxiv.org/abs/2509.00581
[2] Dawei Gao, Haibin Wang, Yaliang Li, Xiuyu Sun, Yichen Qian, Bolin Ding, Jingren Zhou “Texto para SQL capacitado por grandes modelos de linguagem: uma avaliação de referência” arXiv. Junho de 2026