Бенчмарки предоставляют объективный способ оценки систем искусственного интеллекта, но они не являются конечной целью. Высокий балл бенчмарка ценен только в том случае, если он обеспечивает надежную работу в реальных приложениях.
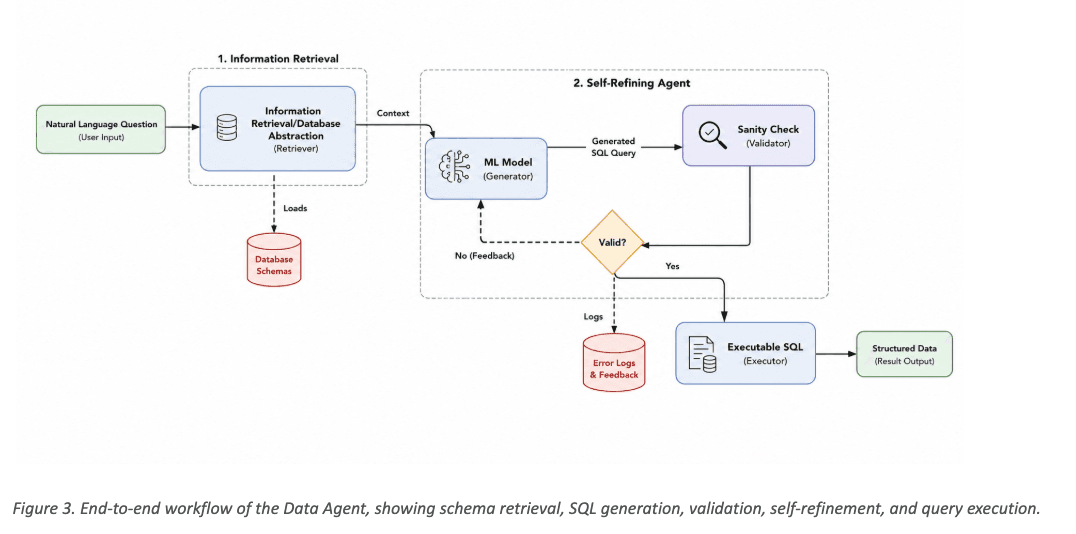
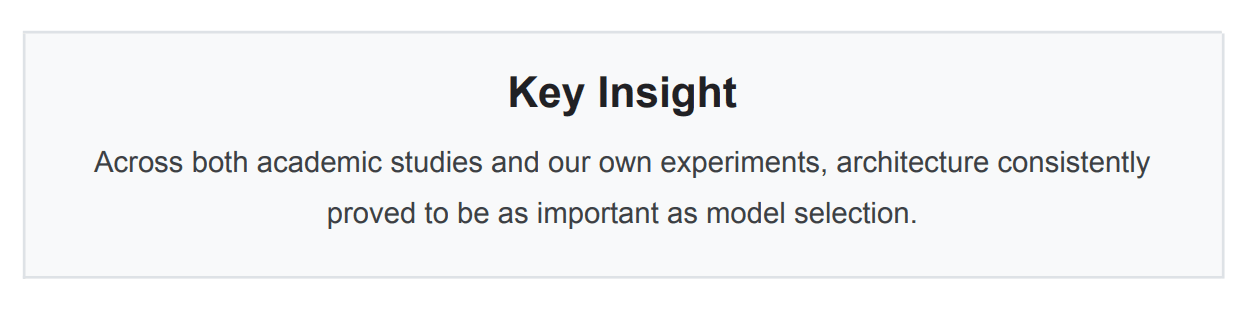
В ходе этого исследования мы обнаружили, что создание готовой к использованию системы преобразования текста в SQL — это гораздо больше, чем просто генерация SQL-запросов. Понимание схем баз данных, получение необходимого контекста, проверка сгенерированных запросов и исправление некорректных результатов оказались столь же важными, как и сама языковая модель.
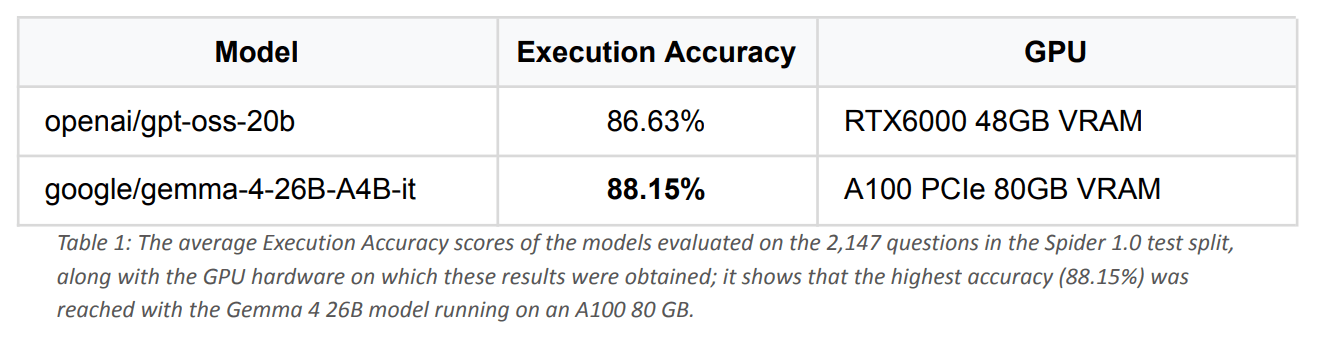
Наша точность выполнения 88.15% на Spider 1.0 демонстрирует, что модели с открытым исходным кодом в сочетании с хорошо продуманной архитектурой могут обеспечить высококонкурентную производительность для корпоративных задач преобразования текста в SQL. Что еще важнее, это подтверждает принципы проектирования нашего Data Agent , который был создан для надежной работы со сложными корпоративными базами данных, а не только с эталонными наборами данных.
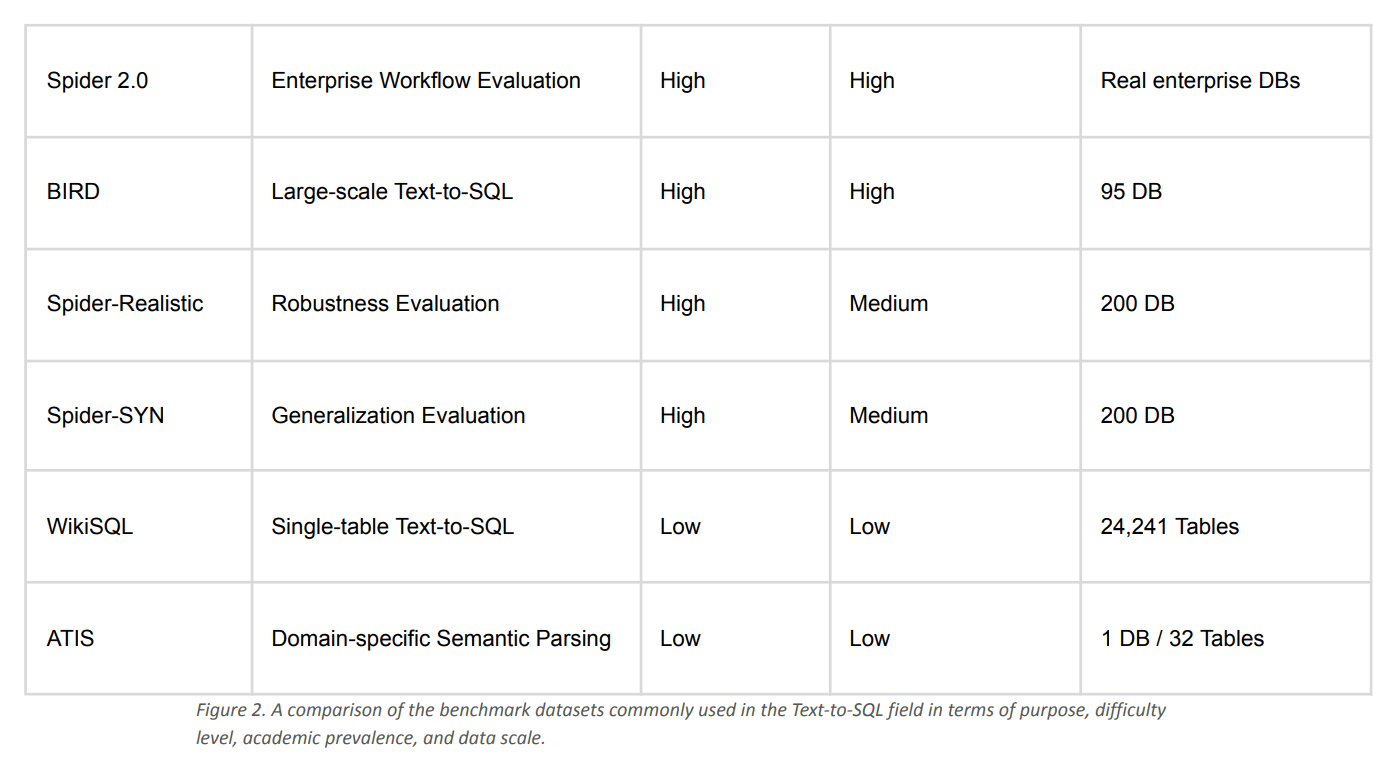
Spider 1.0 представляет собой важную веху, но это только начало нашего пути. Наши следующие шаги включают оценку Data Agent на Spider 2.0 , более масштабные сравнительные тесты в масштабах предприятия и, что наиболее важно, работу в реальных клиентских средах, где схемы баз данных значительно больше, а бизнес-задачи гораздо сложнее.
Наша долгосрочная цель — не просто создать более совершенный генератор SQL-запросов. Мы стремимся разработать интеллектуальных агентов данных, которые позволят организациям взаимодействовать с корпоративными данными так же естественно, как они общаются с коллегами, объединяя поиск, рассуждения, проверку и объяснимый ИИ в надежную платформу поддержки принятия решений.