Riktmärken ger ett objektivt sätt att utvärdera AI-system, men de är inte det slutgiltiga målet. Ett högt riktmärkesresultat är bara värdefullt om det leder till tillförlitlig prestanda i verkliga tillämpningar.
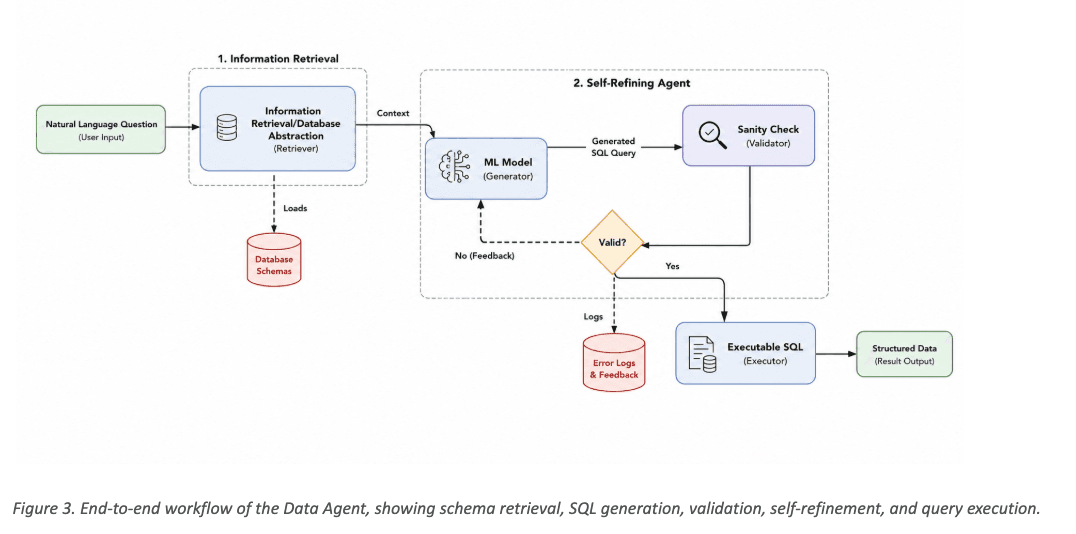
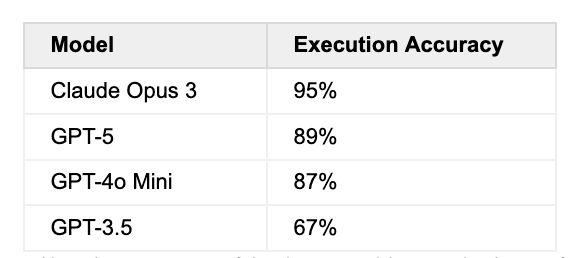
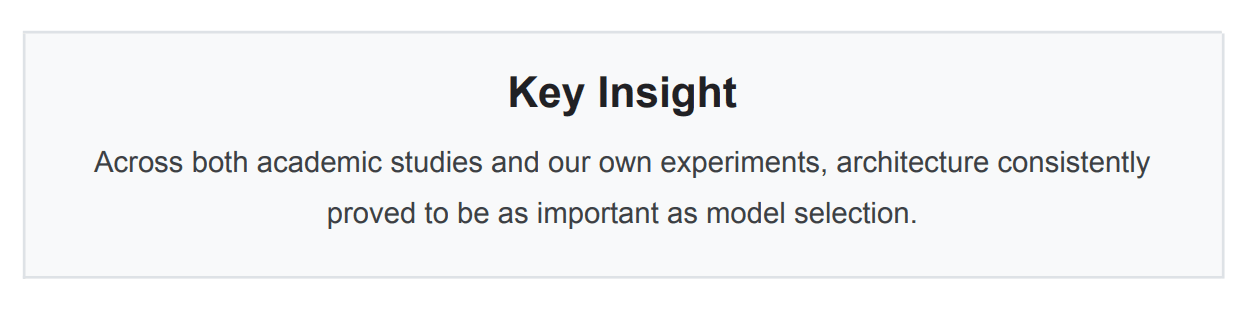
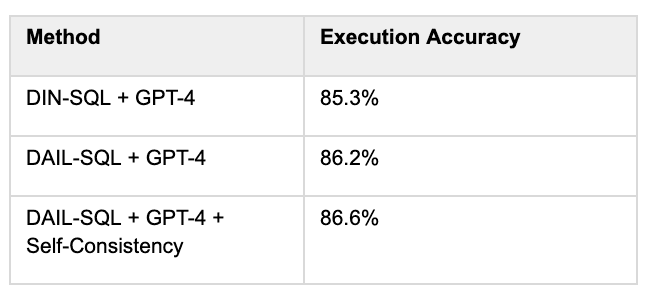
Genom hela studien fann vi att det att bygga ett produktionsklart Text-to-SQL-system handlar om mycket mer än att bara generera SQL. Att förstå databasscheman, hämta rätt kontext, validera genererade frågor och förfina felaktiga utdata visade sig vara lika viktigt som själva språkmodellen.
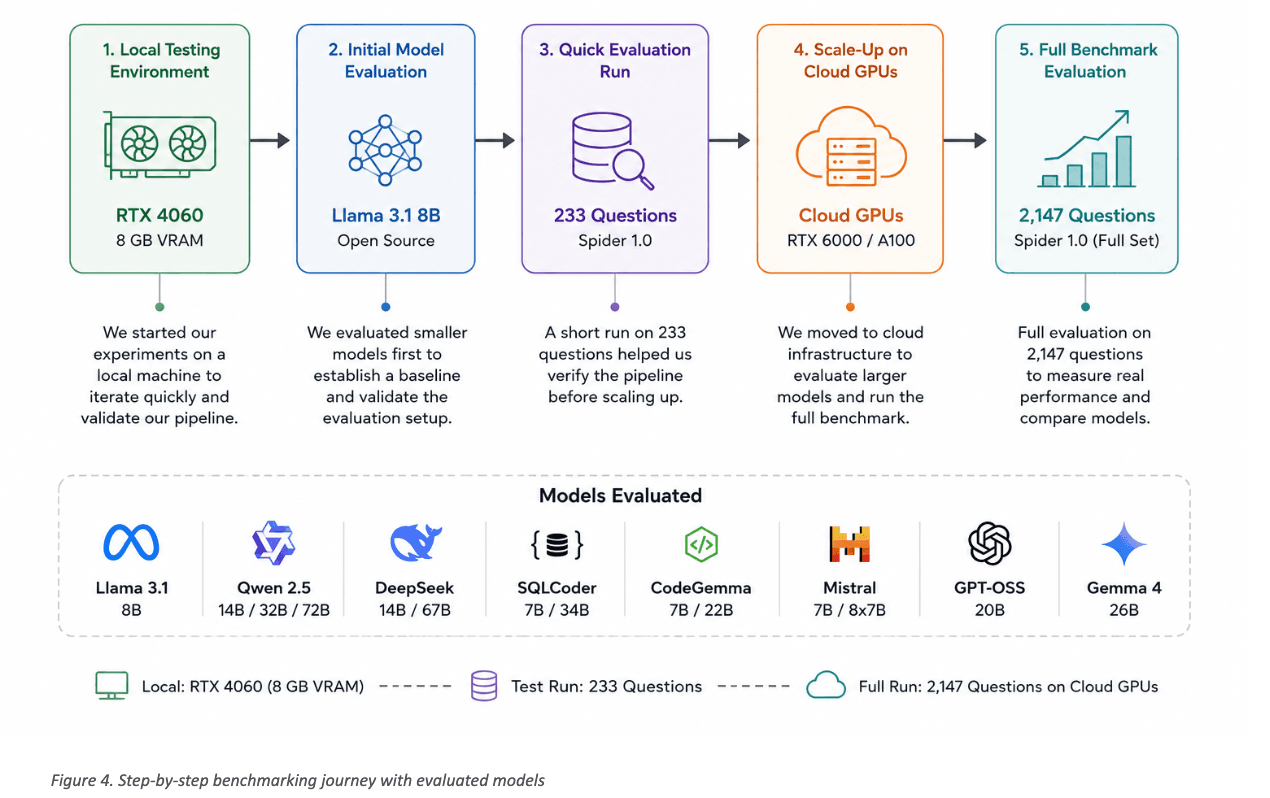
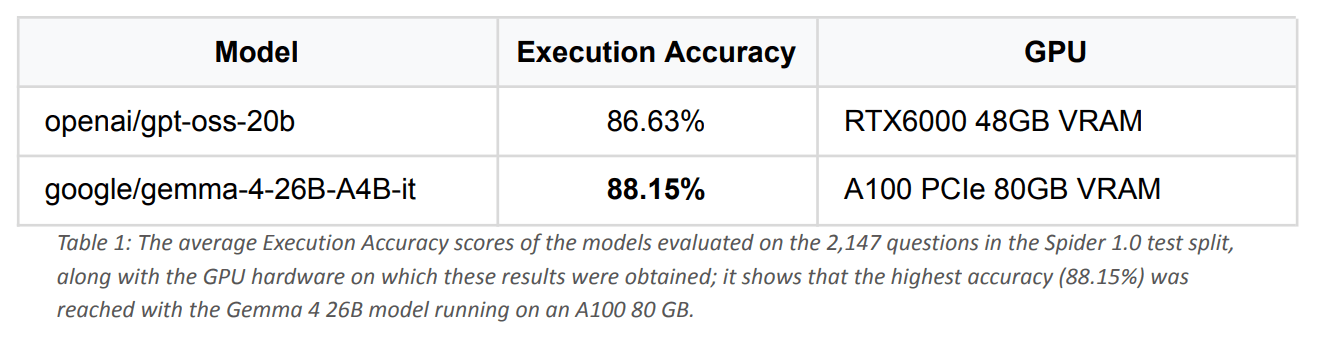
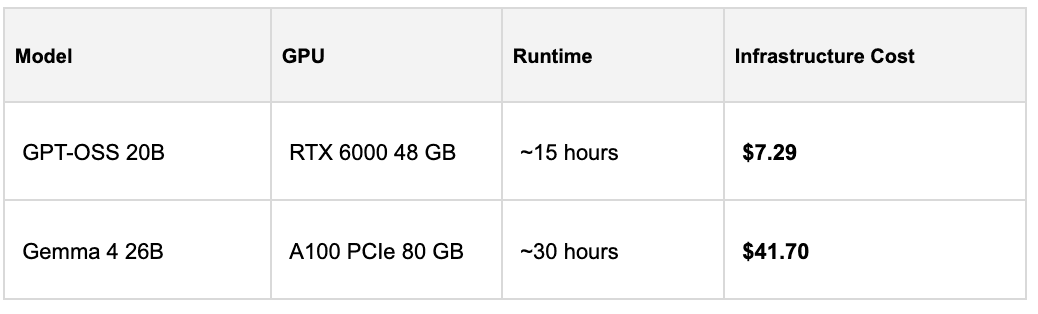
Vår exekveringsnoggrannhet på 88.15 % i Spider 1.0 visar att modeller med öppen källkod, i kombination med en väl utformad arkitektur, kan leverera mycket konkurrenskraftig prestanda för Text-to-SQL-uppgifter på företag. Ännu viktigare är att det validerar designprinciperna bakom vår Data Agent , som byggdes för att fungera tillförlitligt på komplexa företagsdatabaser snarare än bara på benchmark-dataset.
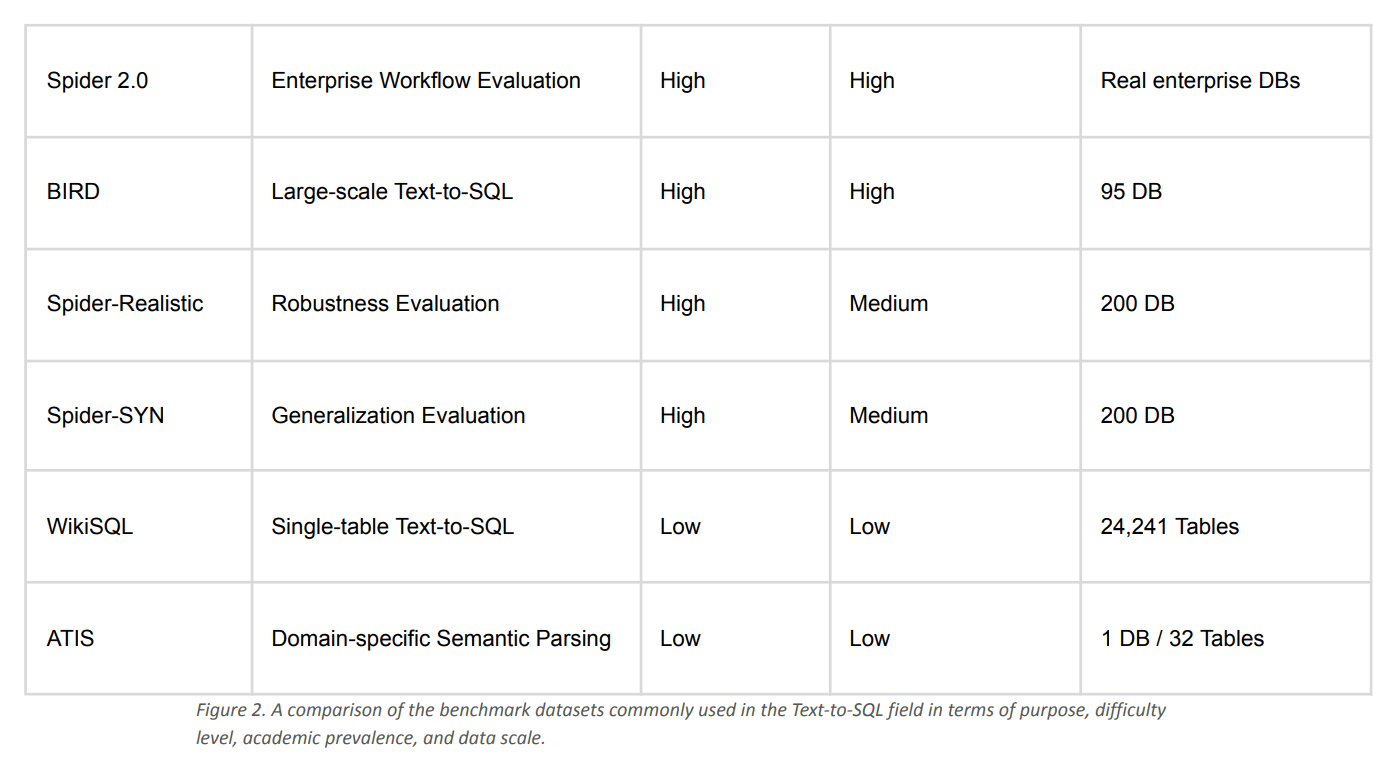
Spider 1.0 representerar en viktig milstolpe, men det är bara början på vår resa. Våra nästa steg inkluderar att utvärdera Data Agent på Spider 2.0 , större företagsnivåer och, viktigast av allt, verkliga kundmiljöer där databasscheman är betydligt större och affärsfrågor är mycket mer komplexa.
Vår långsiktiga vision är inte bara att bygga en bättre SQL-generator. Vi strävar efter att bygga intelligenta dataagenter som gör det möjligt för organisationer att interagera med företagsdata lika naturligt som de kommunicerar med en kollega – och kombinerar hämtning, resonemang, validering och förklarbar AI i en pålitlig beslutsstödsplattform.