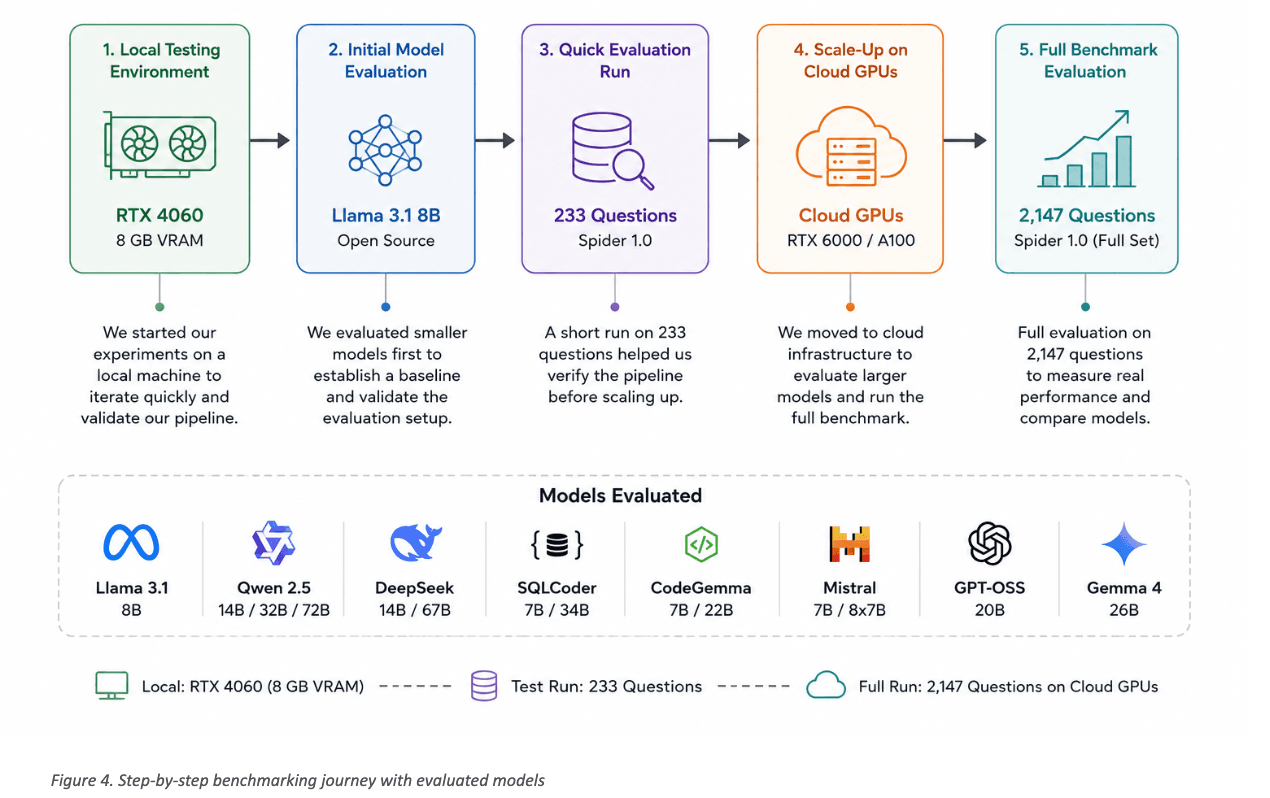
การเลือกโมเดลภาษาที่เหมาะสมเป็นส่วนสำคัญของกระบวนการเปรียบเทียบประสิทธิภาพของเรา แทนที่จะประเมินเพียงโมเดลเดียว เราได้ทดลองใช้โมเดลภาษาแบบโอเพนซอร์สหลากหลายรุ่น รวมถึงLlama 3.1, Qwen 2.5, DeepSeek, SQLCoder, CodeGemma, Mistral, GPT-OSS และGemma 4
เพื่อให้การเปรียบเทียบมีความยุติธรรม เราจึงประเมินแต่ละโมเดลโดยใช้ความแม่นยำในการดำเนินการ (Execution Accuracy หรือ EA) ซึ่งเป็นตัวชี้วัดมาตรฐานสำหรับการวัดประสิทธิภาพการแปลงข้อความเป็น SQL แตกต่างจากตัวชี้วัดที่อิงตามไวยากรณ์ ความแม่นยำในการดำเนินการจะวัดว่า SQL ที่สร้างขึ้นนั้นให้ผลลัพธ์เหมือนกับคำสั่ง SQL อ้างอิงหรือไม่ ทำให้เป็นตัวบ่งชี้ประสิทธิภาพในโลกแห่งความเป็นจริงที่ดีกว่า
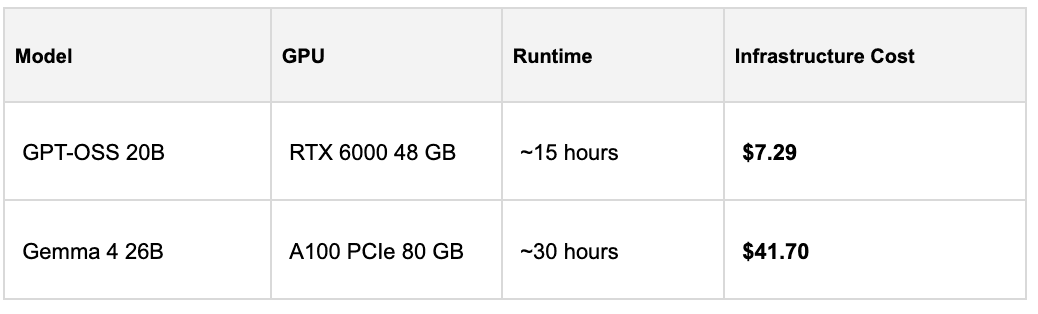
เส้นทางการทดสอบประสิทธิภาพของเราแสดงไว้ในรูปที่ 4 เราเริ่มต้นด้วยการทดลองบนเวิร์กสเตชันในพื้นที่ซึ่งติดตั้งRTX 4060 (8 GB VRAM) โดยโมเดลขนาดเล็กช่วยให้เราสามารถทดสอบซ้ำได้อย่างรวดเร็วและตรวจสอบความถูกต้องของไปป์ไลน์ของเรา หลังจากสร้างพื้นฐานที่เสถียรโดยใช้ชุดคำถาม Spider 1.0 จำนวน 233 ข้อ เราจึงย้ายไปยัง GPU บนคลาวด์เพื่อประเมินโมเดลขนาดใหญ่ขึ้นบน ชุด คำถามทดสอบประสิทธิภาพทั้งหมด 2,147 ข้อ วิธีการแบบเป็นขั้นตอนนี้ช่วยให้เราสามารถปรับสถาปัตยกรรมให้เหมาะสมได้อย่างมีประสิทธิภาพก่อนที่จะลงทุนในการทดสอบประสิทธิภาพขนาดใหญ่
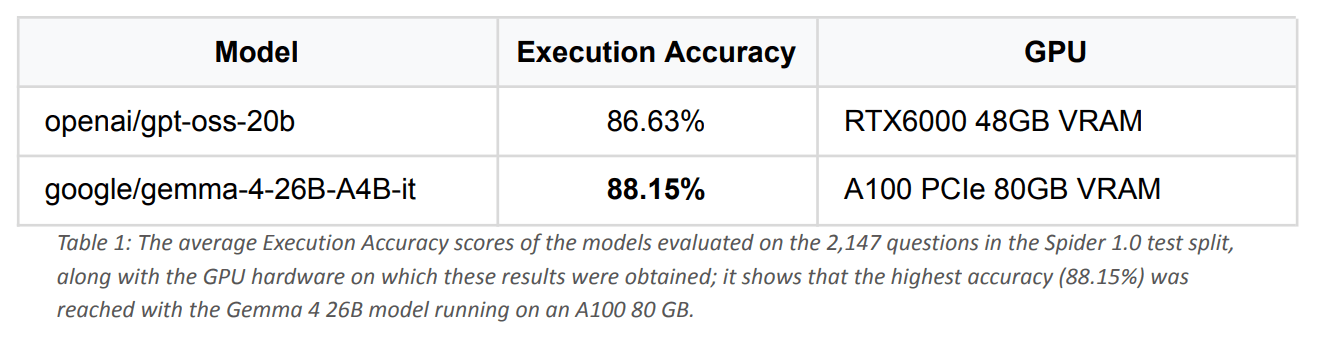
เราได้ประเมินโมเดลขั้นสุดท้ายบนชุดทดสอบ Spider 1.0 ฉบับสมบูรณ์ ซึ่งประกอบด้วยคำถาม 2,147 ข้อ ดังแสดงในตารางที่ 1 Gemma 4 26B ได้คะแนนสูงสุด (88.15%) ตามด้วย GPT-OSS 20B (86.63%) ผลลัพธ์เหล่านี้แสดงให้เห็นว่า LLM แบบโอเพนซอร์สที่ทันสมัย เมื่อรวมกับไปป์ไลน์การดึงข้อมูลและการตรวจสอบความถูกต้องที่มีประสิทธิภาพ สามารถบรรลุประสิทธิภาพการแปลงข้อความเป็น SQL ที่แข่งขันได้ในระดับสูง