• Yayın tarihi
    Temmuz 13, 2026
  • paylaş
Ekran Resmi 2026-07-10 15.13.39.png

Yönetici Özeti

Üretime hazır bir Metin-SQL sistemi oluşturmak, büyük bir dil modeliyle SQL üretmekten çok daha fazlasını gerektirir. Kurumsal uygulamalar, daha önce görülmemiş veritabanlarında güvenilir sonuçlar üretmek için doğru şema anlayışı, bağlam alma, doğrulama ve hata düzeltme gerektirir.

Bu çalışmada, Veri Aracımızı Spider 1.0 üzerinde kıyasladık ve Gemma 4 26B modelini kullanarak %88.15 Yürütme Doğruluğu elde ettik . Bu makale, yalnızca kıyaslama puanlarına odaklanmak yerine, bu sonuçların ardındaki mimari kararları, mühendislik derslerini ve kıyaslama içgörülerini paylaşmaktadır.

SQL Üretiminin Ötesinde

SQL Üretiminin Ötesinde

Büyük dil modelleri SQL üretimini önemli ölçüde geliştirmiştir, ancak üretime hazır bir Metin-SQL sistemi oluşturmak, doğal dili SQL'e çevirmekten çok daha fazlasını gerektirir. Kurumsal uygulamalar, karmaşık veritabanı şemalarını anlamalı, doğru bağlamı almalı, oluşturulan sorguları doğrulamalı ve daha önce hiç görmedikleri veritabanlarında güvenilir sonuçlar üretmelidir.

Bu yetenekleri değerlendirmek için, en yaygın kullanılan Metin-SQL kıyaslama aracı olan Spider 1.0 üzerinde Veri Aracımızı kıyasladık . Gemma 4 26B modelini kullanarak, sistemimiz %88.15 Yürütme Doğruluğu elde etti ; bu da mimari ve bağlam yönetiminin model seçimi kadar önemli olduğunu göstermektedir.

Spider 1.0 neden?

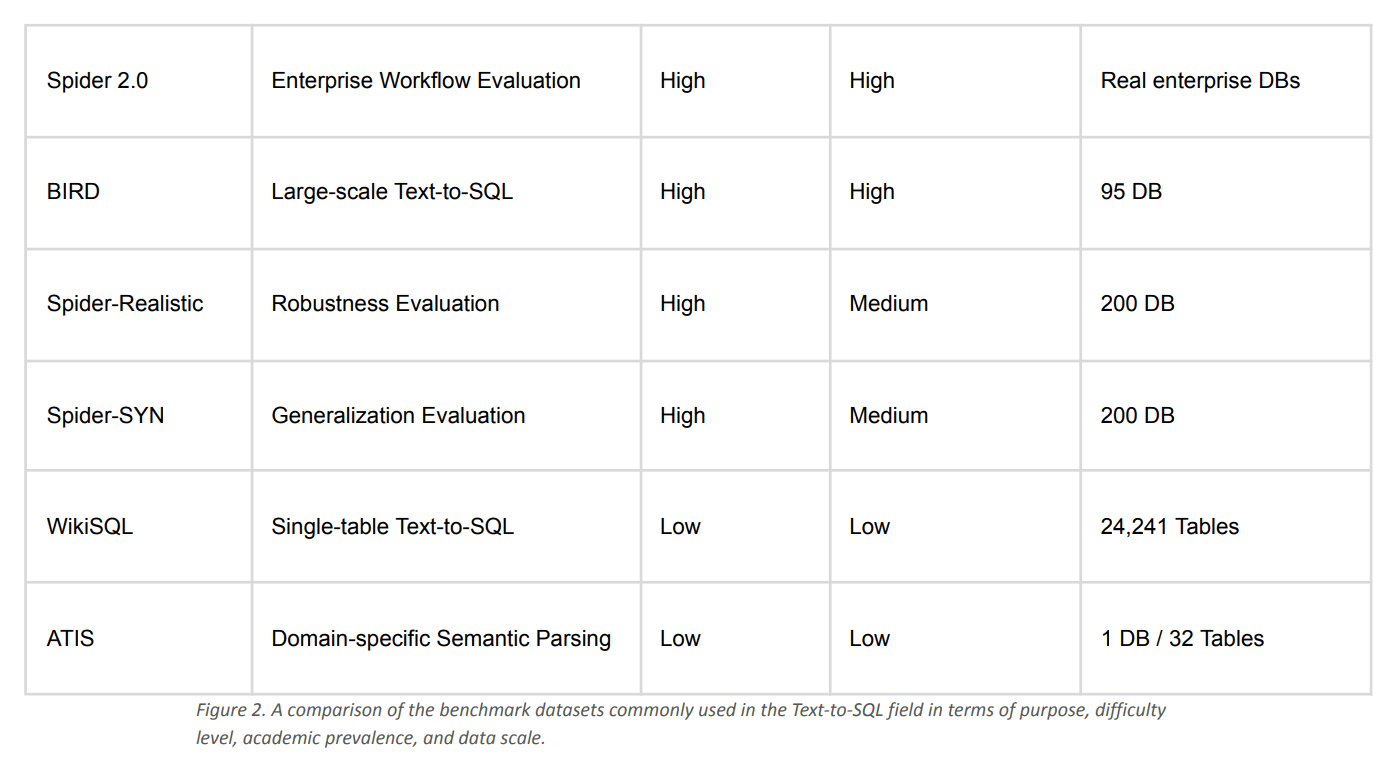
Doğru kıyaslama ölçütünü seçmek, doğru modeli seçmek kadar önemlidir. Spider 2.0 ve BIRD gibi daha yeni veri kümeleri daha karmaşık kurumsal senaryolar sunarken, Spider 1.0, metinden SQL'e dönüştürme sistemlerini değerlendirmek ve literatürdeki sonuçları karşılaştırmak için en yaygın olarak kullanılan kıyaslama ölçütü olmaya devam etmektedir.

Ekran Resmi 2026-07-13 15.13.56.png

İlk değerlendirmemiz için, standartlaştırılmış ve iyi kurulmuş bir temel sağladığı için Spider 1.0'ı seçtik. Bu sayede, Veri Aracımızın daha önce görülmemiş veritabanı şemalarını ne kadar etkili bir şekilde anladığını ve gerçekçi koşullar altında doğru SQL ürettiğini ölçebiliyoruz.

Şekil 2, Spider 1.0'ın yaygın olarak kullanılan diğer Metin-SQL kıyaslama araçlarıyla nasıl karşılaştırıldığını özetlemektedir.

Veri Aracısını Oluşturma

Yüksek metinden SQL'e dönüştürme doğruluğu elde etmek, yalnızca daha büyük bir dil modeli kullanmakla ilgili bir şey değildir. Kıyaslama sürecimiz boyunca, mimari ve bağlam yönetiminin, tek başına model seçiminden daha fazla performans üzerinde etkili olduğunu gördük.

Ekran Resmi 2026-07-10 15.31.28.png

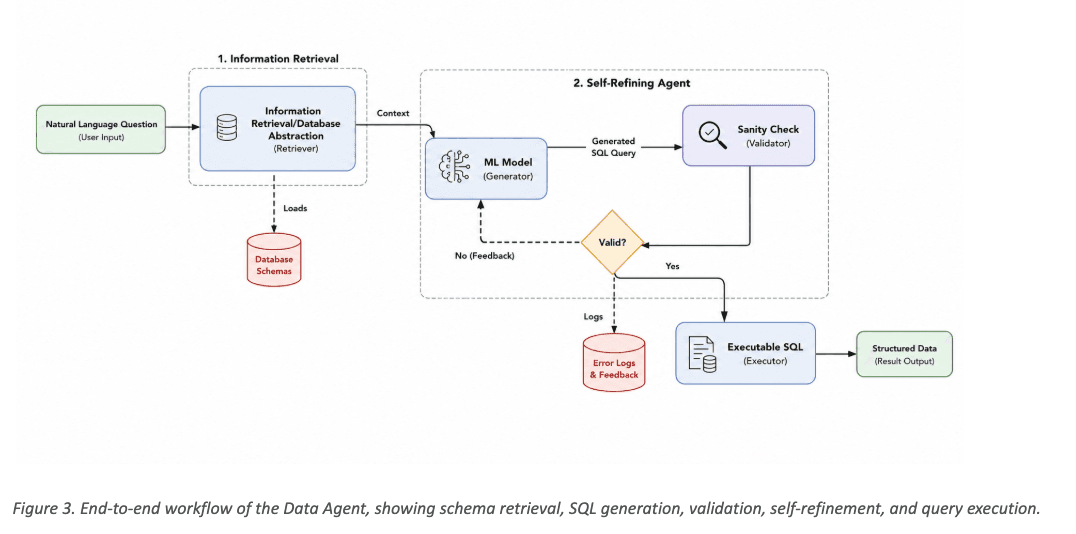
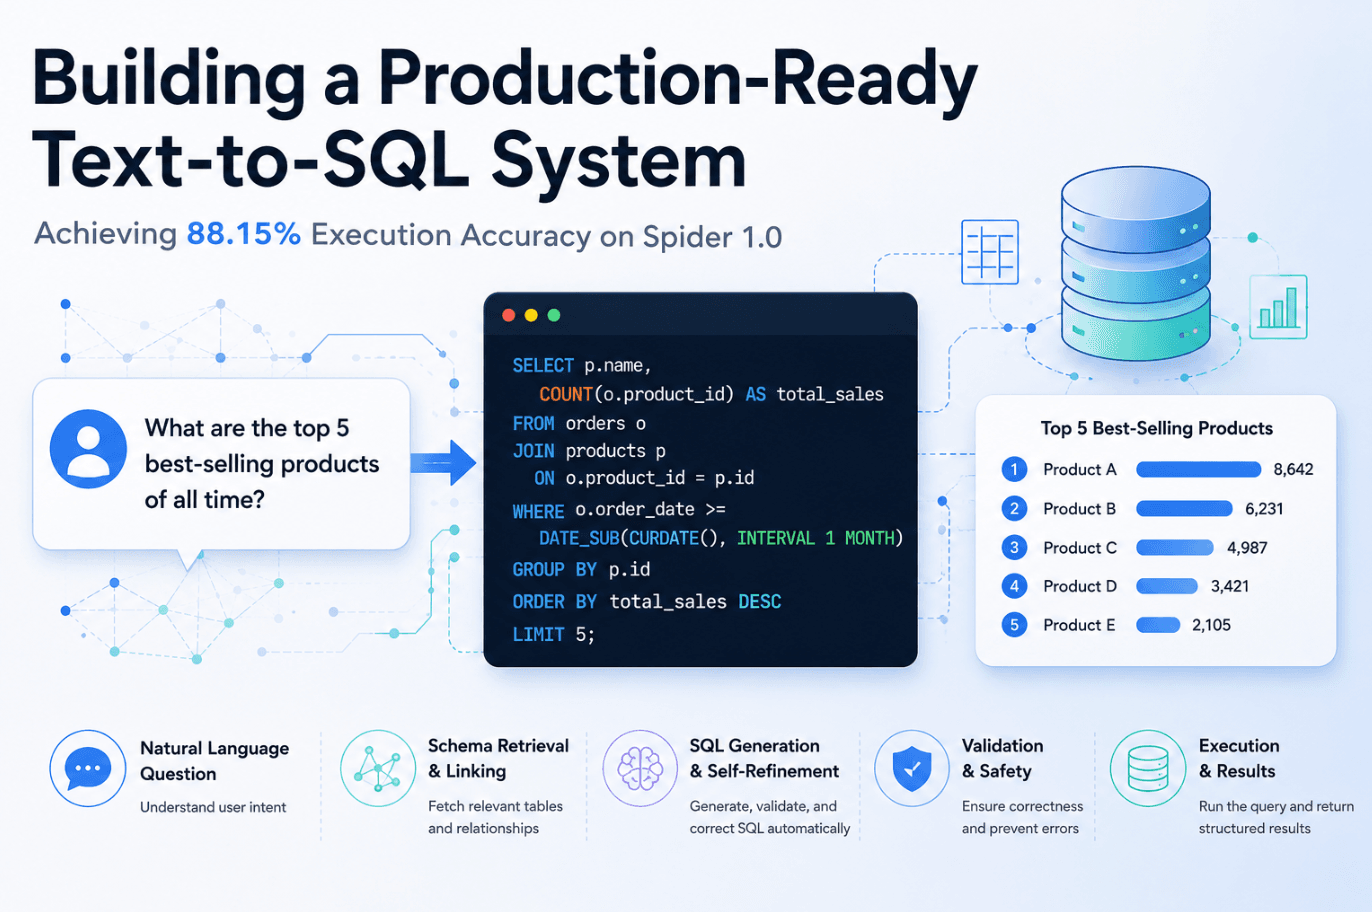
Veri Aracımız , LLM'den SQL oluşturmasını istemeden önce sorunu aşamalı olarak daraltan çok aşamalı bir işlem hattı olarak tasarlanmıştır. Sistem, veritabanı şemasının tamamını modele sunmak yerine, önce yalnızca ilgili şemayı ve bağlamsal bilgileri alır, ardından bir SQL sorgusu oluşturur, sonucu doğrular ve yürütmeden önce yaygın hataları otomatik olarak düzeltir.

Şekil 3'te gösterildiği gibi , mimari üç ana aşamadan oluşmaktadır:

  • Bilgi alma – Kullanıcının sorusu analiz edilerek ilgili veritabanı nesneleri belirlenir ve meta veri deposundan yalnızca gerekli şema bilgileri alınır.
  • Kendini Arındıran Madde – Dil modeli SQL sorgusu üretir, sorguyu alınan şemaya göre doğrular ve doğrulama başarısız olduğunda otomatik olarak iyileştirir.
  • Yürütme ve Yanıt Doğrulama işlemi tamamlandıktan sonra, SQL sorgusu hedef veritabanına karşı yürütülür ve sonuçlar yapılandırılmış veri veya doğal dil yanıtı olarak döndürülür.

Üretim odaklı bu mimari, DIN-SQL ve DAIL-SQL'de ortaya atılan fikirlerden esinlenerek , güvenilirlik, açıklanabilirlik ve sağlamlığın kıyaslama doğruluğu kadar önemli olduğu kurumsal ortamlara uyarlanmıştır.

Kıyaslama Yolculuğumuz

Ekran Resmi 2026-07-10 15.32.47.png

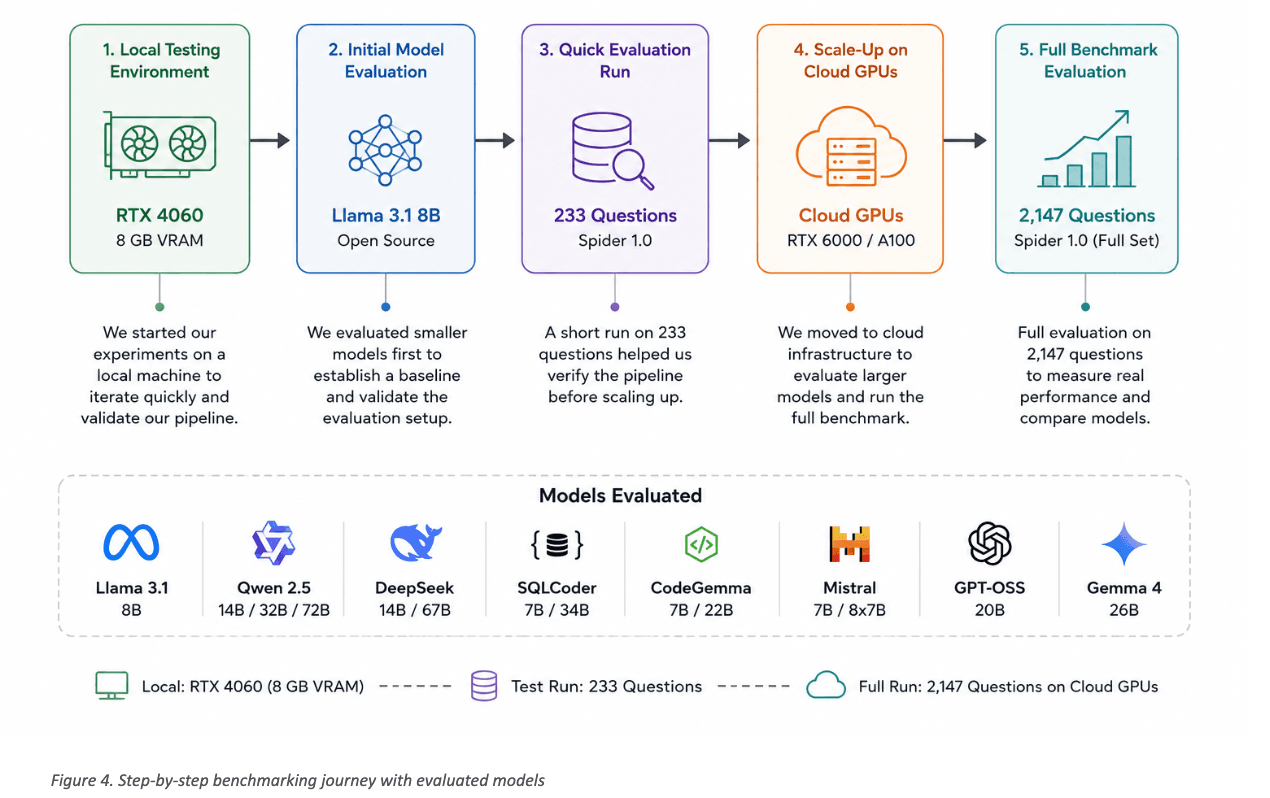
Doğru dil modelini seçmek, kıyaslama sürecimizin önemli bir parçasıydı. Tek bir modeli değerlendirmek yerine, Llama 3.1, Qwen 2.5, DeepSeek, SQLCoder, CodeGemma, Mistral, GPT-OSS ve Gemma 4 dahil olmak üzere çok çeşitli açık kaynaklı dil modelleriyle denemeler yaptık.

Adil bir karşılaştırma sağlamak için, her modeli Metin-SQL kıyaslaması için standart ölçüt olan Yürütme Doğruluğu (EA) kullanarak değerlendirdik . Sözdizimine dayalı ölçütlerin aksine, Yürütme Doğruluğu, oluşturulan SQL'in referans sorgusuyla aynı sonucu döndürüp döndürmediğini ölçer ve bu da onu gerçek dünya performansının daha iyi bir göstergesi yapar.

Kıyaslama yolculuğumuz Şekil 4'te gösterilmiştir . Önce RTX 4060 (8 GB VRAM) ile donatılmış yerel bir iş istasyonunda deneyler yaparak başladık ; burada daha küçük modeller, hızlı bir şekilde yineleme yapmamıza ve işlem hattımızı doğrulamamıza olanak sağladı. 233 adet Spider 1.0 sorusundan oluşan bir alt küme kullanarak istikrarlı bir temel oluşturduktan sonra, 2,147 soruluk tam kıyaslama testinde daha büyük modelleri değerlendirmek için bulut GPU'larına geçtik . Bu aşamalı yaklaşım, büyük ölçekli kıyaslama çalışmalarına yatırım yapmadan önce mimariyi verimli bir şekilde optimize etmemizi sağladı.

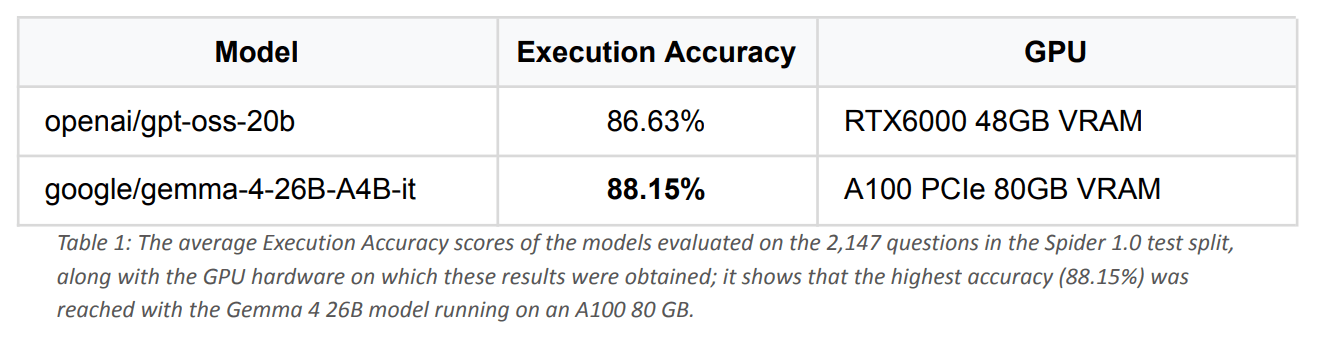
Son modelleri, 2,147 sorudan oluşan Spider 1.0 test veri setinin tamamı üzerinde değerlendirdik. Tablo 1'de gösterildiği gibi, Gemma 4 26B en yüksek puanı (%88.15) alırken, onu GPT-OSS 20B (%86.63) takip etti. Bu sonuçlar, etkili bir arama ve doğrulama hattıyla birleştirildiğinde, modern açık kaynaklı LLM'lerin oldukça rekabetçi bir Metin-SQL performansı elde edebileceğini göstermektedir. 

Ekran Resmi 2026-07-13 15.15.08.png


Bu sonuçlar nasıl karşılaştırılıyor?

Karşılaştırma puanları, ancak daha önce yayınlanmış çalışmalarla karşılaştırılabildiğinde anlamlıdır. Sonuçlarımızın önemini daha iyi anlamak için hem yakın tarihli Metinden SQL'e dönüştürme çalışmalarını hem de yaygın olarak referans gösterilen karşılaştırma makalelerini inceledik.

Ekran Resmi 2026-07-13 13.07.55.png

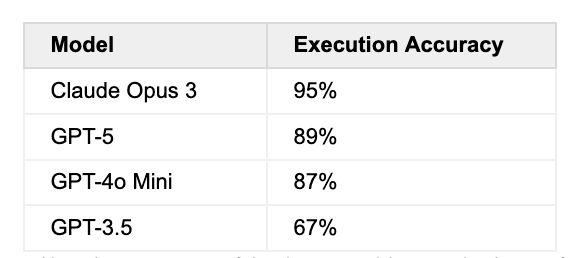
Tablo 2: SQL-of-Thought çalışmasında Spider veri setinin bir alt kümesi üzerinde raporlanan kapalı kaynaklı modellerin doğruluk oranları; karşılaştırmalı olarak, bu çalışmada elde edilen %88.15'lik sonucun GPT-4o Mini'nin (%87) üzerinde ve GPT-5'e (%89) yakın bir seviyede konumlandığını göstermektedir.

SQL-of-Thought [1] gibi son çalışmalar, Claude Opus 3, GPT-5 ve GPT-4o Mini dahil olmak üzere önde gelen kapalı kaynaklı modellerin Spider kıyaslama alt kümelerinde yüksek doğruluk elde ettiğini bildirmektedir. Değerlendirme ayarlarındaki, istemlerdeki ve kıyaslama alt kümelerindeki farklılıklar nedeniyle doğrudan karşılaştırmalar dikkatlice yorumlanmalıdır, ancak %88.15'lik Yürütme Doğruluğumuz , açık kaynaklı modellerin aynı rekabetçi aralıkta performans elde edebileceğini göstermektedir.

Bu sonuçlar farklı değerlendirme ortamlarından elde edildiğinden doğrudan karşılaştırılmamalıdır, ancak metinden SQL'e (Text-to-SQL) sistemlerinin mevcut performans durumunu anlamak için faydalı bir bağlam sağlamaktadırlar. Karşılaştırmalı testimiz, açık kaynaklı modellerin iyi tasarlanmış bir mimariyle birleştirildiğinde önde gelen kapalı kaynaklı alternatiflerle rekabet edebileceğini göstermektedir.

Ekran Resmi 2026-07-13 15.17.45.png

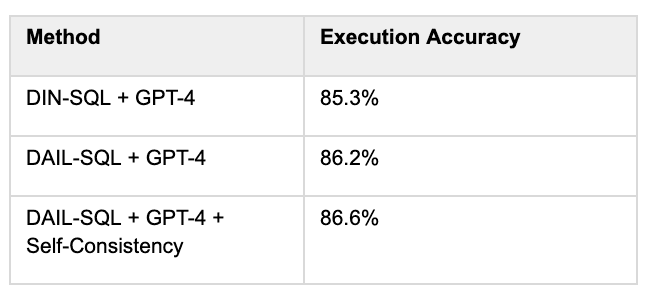
Sonuçlarımızı, şema bağlantısı, istem mühendisliği, öz tutarlılık ve hata düzeltme gibi teknikleri içeren büyük dil modellerini birleştiren DIN-SQL [3] ve DAIL- SQL gibi üretim odaklı Metin-SQL çerçeveleriyle de karşılaştırdık.

Ekran Resmi 2026-07-13 13.10.44.png

Tablo 3: "Büyük Dil Modelleriyle Güçlendirilmiş Metinden SQL'e: Bir Kıyaslama Değerlendirmesi" [2] çalışmasında Spider 1.0'da farklı yöntemlerin yürütme doğruluğu sonuçları; doğruluk üzerindeki etkiyi yalnızca model seçiminin değil, aynı zamanda istem mühendisliği, şema bağlantısı ve öz tutarlılık gibi tekniklerin de ortaya koymaktadır.

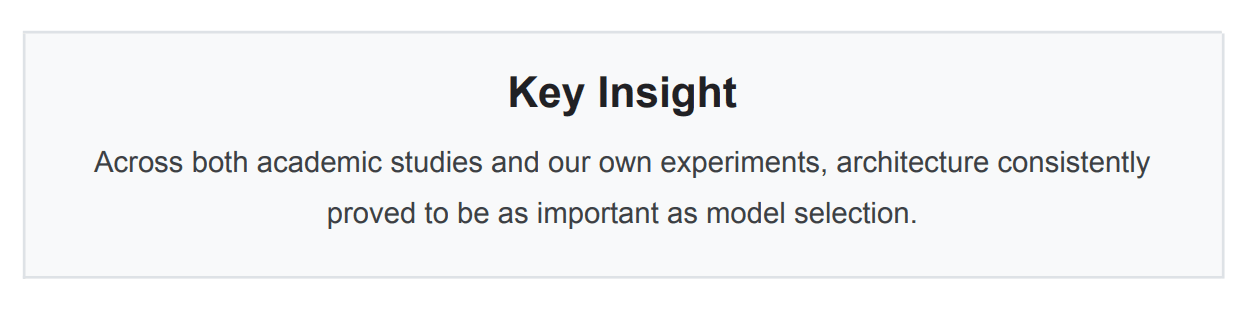
Bulgularımız, son dönemdeki literatürde paylaşılan bir sonucu destekliyor: Yüksek Text-to-SQL performansı yalnızca dil modeline değil, aynı zamanda çevreleyen mimariye de bağlıdır. Etkili şema alma, bağlam yönetimi, doğrulama ve kendi kendini düzeltme, çoğu zaman modelin kendisi kadar önemlidir.

Öğrendiklerimiz

Kıyaslama (benchmarking) sadece doğruluğu ölçmekle ilgili değil, aynı zamanda bir sistemin nerede ve neden başarısız olduğunu anlamakla da ilgilidir. Değerlendirmemiz boyunca, hatalı tahminleri analiz ettik ve nihai puanları etkileyen birkaç tekrar eden kalıbı belirledik.

Bazı hatalar, kıyaslama testinin kendisinden kaynaklandı. Az sayıda durumda, referans (altın) SQL sorgularındaki tutarsızlıklar, mantıksal olarak doğru tahminlerin yanlış olarak işaretlenmesine neden oldu. Diğer durumlarda ise, birden fazla SQL sorgusunun eşit derecede geçerli yanıtlar üretebileceği belirsiz doğal dil soruları veya eşitlik bozma senaryoları söz konusuydu.

Ayrıca, gereksiz tür dönüşümleri, büyük/küçük harf duyarlılığının tutarsız şekilde ele alınması ve aksi takdirde basit olan SQL sorgularının zaman zaman aşırı karmaşıklaştırılması gibi modele özgü çeşitli davranışlar gözlemledik. Bu bulgular, doğrulama ve kendi kendini düzeltme mekanizmalarının Veri Aracısı işlem hattına dahil edilmesinin önemini pekiştirdi.

Genel olarak, analizimiz kalan hataların çoğunun dil modelinin kendi sınırlamalarından değil, kıyaslama testindeki belirsizliklerden veya SQL oluşturmadaki uç durumlardan kaynaklandığını gösterdi. Bu, alma, doğrulama ve bağlam yönetiminde yapılacak daha fazla iyileştirmenin sistemi %90 Yürütme Doğruluğu eşiğinin ötesine taşıyabileceğini düşündürmektedir.

Maliyet ve Verimlilik

Yüksek doğruluk, üretime hazır bir Metin-SQL sisteminin yalnızca bir yönüdür. Kurumsal ortamlarda, altyapı maliyeti, veri gizliliği ve dağıtım esnekliği de aynı derecede önemli hususlardır.

Yaklaşımımızın en önemli avantajlarından biri, tamamen açık kaynaklı dil modellerine dayanmasıdır . Geliştirme süreci boyunca, çoğu deneyi yerel olarak tüketici sınıfı bir RTX 4060 (8 GB VRAM) kullanarak gerçekleştirebildik ; bu da herhangi bir API veya token maliyetine katlanmadan hızlı bir şekilde yineleme yapmamızı sağladı. Daha büyük kıyaslama testleri ise mimari doğrulandıktan sonra özel bulut GPU'larında gerçekleştirildi.

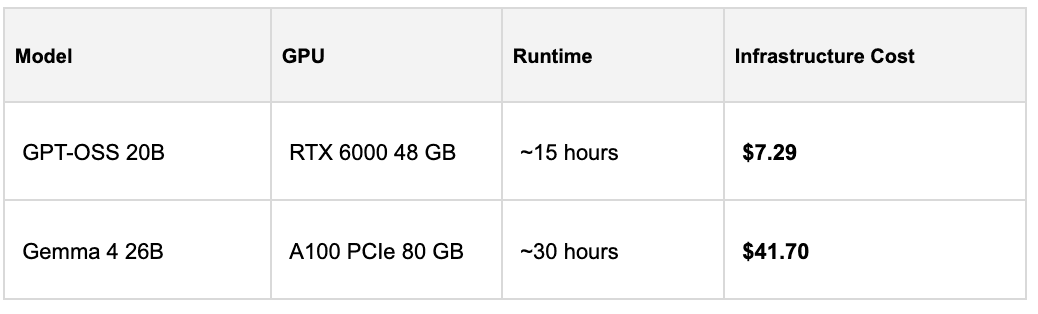
Spider 1.0'ın tam değerlendirmesi için RunPod Secure Cloud'u kullandık. Gemma 4 26B kıyaslama testi A100 PCIe 80 GB GPU üzerinde, GPT-OSS 20B ise RTX 6000 48 GB GPU üzerinde gerçekleştirildi .

Altyapı maliyetleri Tablo 4'te özetlenmiştir.

Ekran Resmi 2026-07-13 13.11.54.png

En büyük kıyaslama çalışmaları bulut altyapısı gerektirse de, genel geliştirme süreci yerel deneyler ve açık kaynak modelleri sayesinde maliyet etkinliğini korudu. Daha da önemlisi, ortaya çıkan mimari tamamen bir kuruluşun kendi altyapısı içinde konuşlandırılabilir; bu da harici API'lere olan bağımlılığı ortadan kaldırırken veri gizliliği, uyumluluk ve operasyonel maliyetler üzerinde daha fazla kontrol sağlar.

Bu durum, mimariyi özellikle veri güvenliğinin ve dağıtım esnekliğinin kritik gereksinimler olduğu, gizliliğe duyarlı, düzenlemeye tabi veya internet bağlantısı olmayan ortamlarda faaliyet gösteren kuruluşlar için son derece uygun hale getiriyor.

Beyond Spider 1.0

Kıyaslama testleri, yapay zeka sistemlerini değerlendirmek için objektif bir yol sunar, ancak nihai hedef değildir. Yüksek bir kıyaslama puanı, ancak gerçek dünya uygulamalarında güvenilir performansa dönüştüğü takdirde değerlidir.

Bu çalışma boyunca, üretime hazır bir Metin-SQL sistemi oluşturmanın SQL üretmekten çok daha fazlasını gerektirdiğini gördük. Veritabanı şemalarını anlamak, doğru bağlamı elde etmek, oluşturulan sorguları doğrulamak ve hatalı çıktıları düzeltmek, dil modelinin kendisi kadar önemli olduğunu kanıtladı.

Spider 1.0'da elde ettiğimiz %88.15'lik yürütme doğruluğu , açık kaynaklı modellerin iyi tasarlanmış bir mimariyle birleştiğinde, kurumsal Metin-SQL görevleri için oldukça rekabetçi bir performans sunabileceğini göstermektedir. Daha da önemlisi, bu sonuç, yalnızca kıyaslama veri kümelerinde değil, karmaşık kurumsal veritabanlarında da güvenilir bir şekilde çalışmak üzere tasarlanmış olan Veri Aracımızın tasarım prensiplerini doğrulamaktadır.

Spider 1.0 önemli bir dönüm noktası olsa da, yolculuğumuzun sadece başlangıcı. Sonraki adımlarımız arasında Spider 2.0 üzerindeki Veri Aracısının değerlendirilmesi , daha büyük kurumsal ölçekli kıyaslamalar ve en önemlisi, veritabanı şemalarının önemli ölçüde daha büyük ve iş sorularının çok daha karmaşık olduğu gerçek müşteri ortamları yer alıyor.

Uzun vadeli vizyonumuz sadece daha iyi bir SQL oluşturucu geliştirmek değil. Kuruluşların kurumsal verilerle tıpkı bir meslektaşlarıyla iletişim kurar gibi doğal bir şekilde etkileşim kurmalarını sağlayan, veri alma, akıl yürütme, doğrulama ve açıklanabilir yapay zekayı güvenilir bir karar destek platformunda birleştiren akıllı Veri Aracıları oluşturmayı hedefliyoruz.
Anahtar Dersler

Kıyaslama (benchmarking) sadece doğruluğu ölçmekle ilgili değildir; bir sistemin neden başarılı veya başarısız olduğunu anlamakla da ilgilidir.

Değerlendirmemiz boyunca, tekrar eden birkaç hata kalıbı belirledik. Bunlardan bazıları, referans SQL sorgularındaki tutarsızlıklar ve yetersiz belirtilmiş sıralama koşulları da dahil olmak üzere, kıyaslama testinin kendisindeki belirsizliklerden kaynaklanıyordu. Diğerleri ise gereksiz tür dönüştürme veya büyük/küçük harf duyarlı değerlerin tutarsız işlenmesi gibi yaygın LLM davranışlarını yansıtıyordu.

Bu gözlemler, çalışmamızın temel bulgularından birini pekiştirdi: mimari, model seçimi kadar önemlidir. Arama, şema bağlantısı, doğrulama ve kendi kendini düzeltme, nihai performansa temel dil modeli kadar katkıda bulundu.

Kıyaslama sınırlamaları kaçınılmaz olarak nihai puanı etkilese de, analizimiz bağlam yönetimi ve doğrulama alanındaki daha fazla iyileştirmenin sistemi %90'ın üzerinde bir yürütme doğruluğu seviyesine taşıyabileceğini göstermektedir .

Geleceğe Güçlü Bir Adım

Spider 1.0, Veri Aracımızı değerlendirmek için önemli bir temel oluşturdu, ancak üretime hazır kurumsal yapay zekaya doğru atılan ilk adımı temsil ediyor.

Bir sonraki hedefimiz, mimariyi Spider 2.0 gibi daha zorlu kıyaslama testlerinde ve daha da önemlisi, şemaların önemli ölçüde daha büyük olduğu, dokümantasyonun genellikle eksik olduğu ve iş sorularının çok daha karmaşık olduğu gerçek kurumsal veritabanlarında değerlendirmektir .

Amacımız sadece bir başka Metin-SQL sistemi oluşturmak değil. Kuruluşların kurumsal verilerle doğal ve güvenilir bir şekilde etkileşim kurmasına yardımcı olmak için, veri alma, akıl yürütme, doğrulama ve açıklanabilirliği birleştiren akıllı Veri Aracıları geliştiriyoruz .

Ekran Resmi 2026-07-10 15.41.38.png

Referanslar

[1] Saumya Chaturvedi, Aman Chadha, Laurent Bindschaedler arXiv. “SQL-of-Thought: Yönlendirilmiş Hata Düzeltmeli Çoklu Ajanlı Metin-SQL.” arXiv. Haziran 2026 https://arxiv.org/abs/2509.00581

[2] Dawei Gao, Haibin Wang, Yaliang Li, Xiuyu Sun, Yichen Qian, Bolin Ding, Jingren Zhou “Büyük Dil Modelleriyle Güçlendirilmiş Metinden SQL'e: Bir Karşılaştırma Değerlendirmesi” arXiv. Haziran 2026

https://arxiv.org/pdf/2308.15363 

[3] Mohammadreza Pourreza, Davood Rafiei. “DIN-SQL: Kendi Kendini Düzeltme Özelliğine Sahip Metin-SQL'in Bağlam İçi Ayrıştırılmış Öğrenimi” arXiv. Haziran 2026

https://arxiv.org/pdf/2304.11015


Dilşen YILDAR HAVAYLAR, 

Kıdemli Yazılım Mühendisi, Yüksek Lisans.