Бенчмарки забезпечують об'єктивний спосіб оцінки систем штучного інтелекту, але вони не є кінцевою метою. Високий бал бенчмарку цінний лише тоді, коли він забезпечує надійну продуктивність у реальних застосунках.
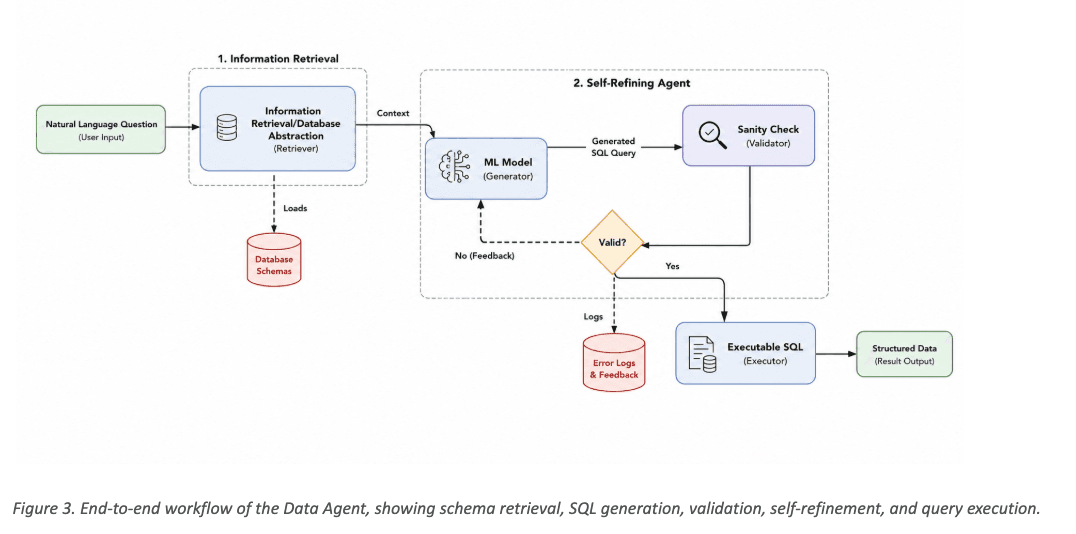
Протягом цього дослідження ми виявили, що побудова готової до роботи системи перетворення тексту в SQL — це набагато більше, ніж просто генерація SQL. Розуміння схем баз даних, отримання правильного контексту, перевірка згенерованих запитів та уточнення неправильних виводів виявилися такими ж важливими, як і сама мовна модель.
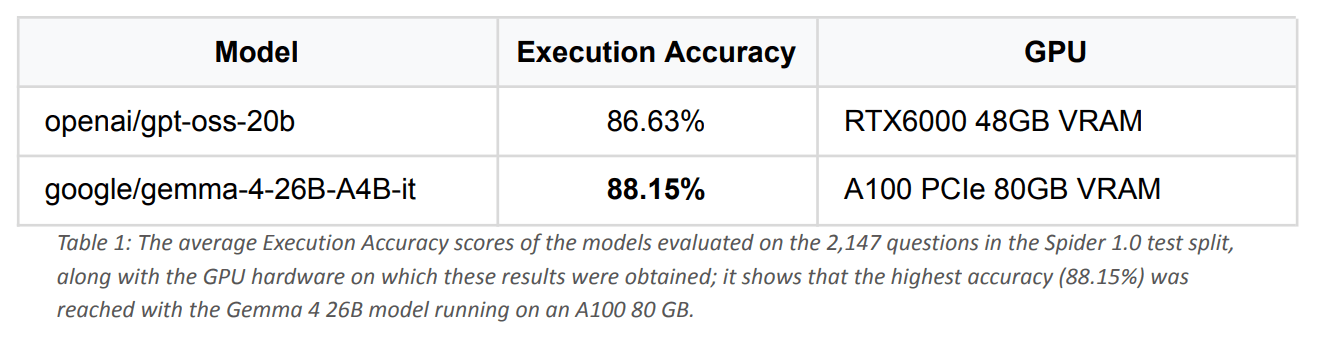
Наша точність виконання 88.15% на Spider 1.0 демонструє, що моделі з відкритим кодом у поєднанні з добре продуманою архітектурою можуть забезпечити високу конкурентоспроможну продуктивність для корпоративних завдань перетворення тексту в SQL. Що ще важливіше, це підтверджує принципи проектування нашого Data Agent , який був створений для надійної роботи на складних корпоративних базах даних, а не лише на еталонних наборах даних.
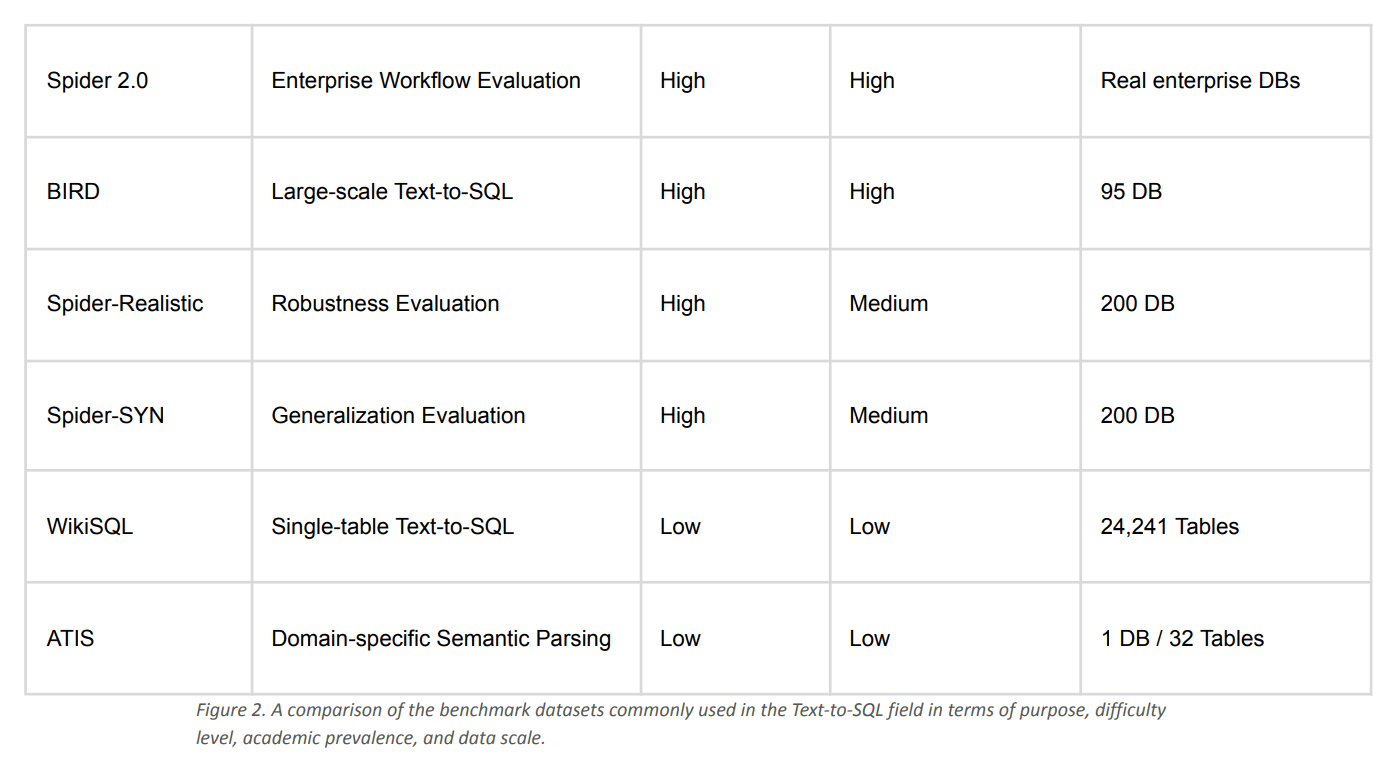
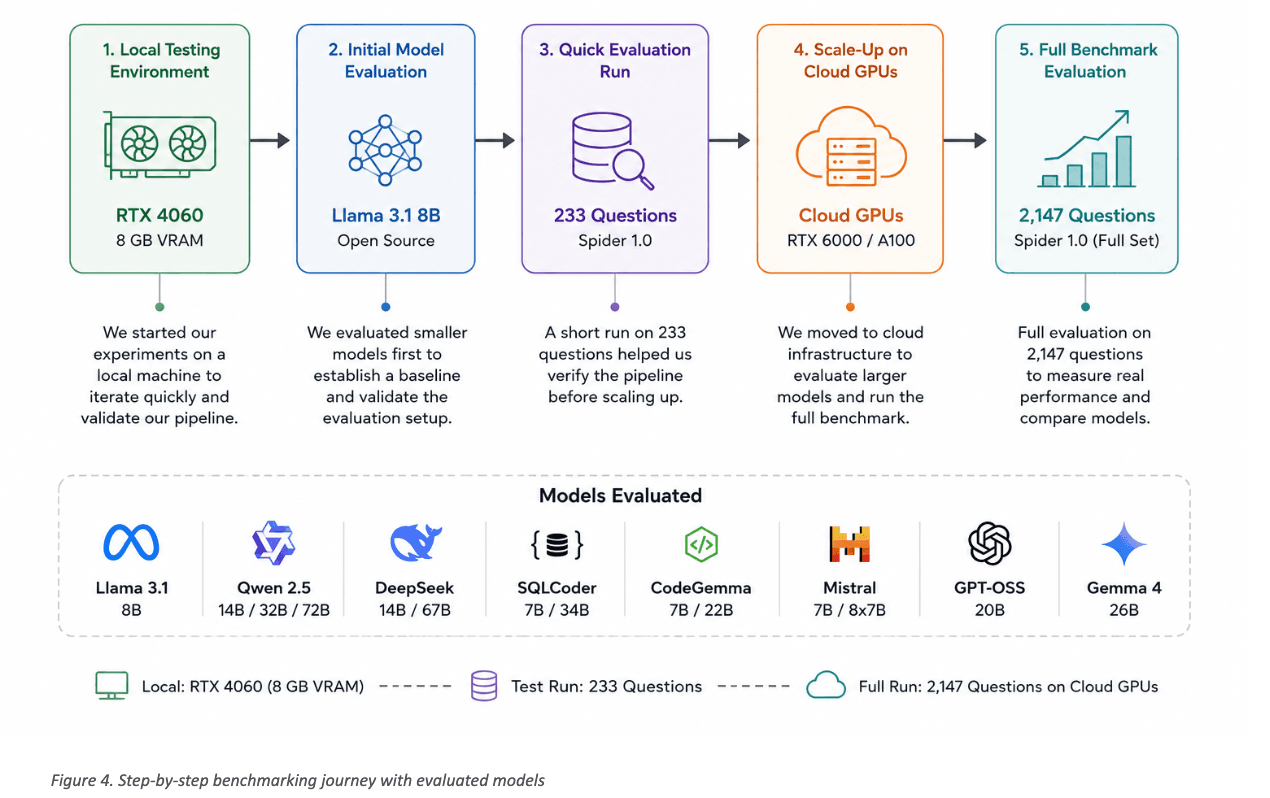
Spider 1.0 є важливою віхою, але це лише початок нашої подорожі. Наші наступні кроки включають оцінку Data Agent на Spider 2.0 , масштабніші бенчмарки корпоративного масштабу та, найголовніше, реальні клієнтські середовища, де схеми баз даних значно більші, а бізнес-питання набагато складніші.
Наше довгострокове бачення полягає не просто в тому, щоб створити кращий генератор SQL. Ми прагнемо створити інтелектуальні агенти даних, які дозволять організаціям взаємодіяти з корпоративними даними так само природно, як вони спілкуються з колегами, поєднуючи пошук, міркування, перевірку та пояснювальний штучний інтелект у надійну платформу підтримки рішень.