Xây dựng hệ thống chuyển đổi văn bản thành SQL sẵn sàng cho môi trường sản xuất: Đạt được 88.15% trên Spider 1.0
Ngày xuất bản
13 Tháng Bảy, 2026
Chia sẻ
Báo cáo tóm tắt
Việc xây dựng một hệ thống chuyển đổi văn bản thành SQL sẵn sàng cho môi trường sản xuất đòi hỏi nhiều hơn là chỉ tạo ra mã SQL với một mô hình ngôn ngữ lớn. Các ứng dụng doanh nghiệp yêu cầu hiểu biết chính xác về lược đồ, truy xuất ngữ cảnh, xác thực và sửa lỗi để tạo ra kết quả đáng tin cậy trên các cơ sở dữ liệu chưa từng thấy trước đây.
Trong nghiên cứu này, chúng tôi đánh giá hiệu năng của Data Agent trên Spider 1.0 và đạt được độ chính xác thực thi 88.15% bằng mô hình Gemma 4 26B . Thay vì chỉ tập trung vào điểm số đánh giá hiệu năng, bài viết này chia sẻ các quyết định kiến trúc, bài học kỹ thuật và hiểu biết về đánh giá hiệu năng đằng sau những kết quả này.
Vượt xa việc tạo SQL
Các mô hình ngôn ngữ quy mô lớn đã cải thiện đáng kể việc tạo câu lệnh SQL, nhưng việc xây dựng một hệ thống chuyển đổi văn bản thành SQL sẵn sàng cho môi trường sản xuất đòi hỏi nhiều hơn là chỉ dịch ngôn ngữ tự nhiên thành SQL. Các ứng dụng doanh nghiệp phải hiểu được lược đồ cơ sở dữ liệu phức tạp, truy xuất ngữ cảnh phù hợp, xác thực các truy vấn được tạo ra và tạo ra kết quả đáng tin cậy trên các cơ sở dữ liệu mà chúng chưa từng thấy trước đây.
Để đánh giá các khả năng này, chúng tôi đã kiểm tra hiệu năng của Data Agent trên Spider 1.0, bộ dữ liệu chuẩn chuyển đổi văn bản thành SQL được sử dụng rộng rãi nhất. Sử dụng mô hình Gemma 4 26B , hệ thống của chúng tôi đạt được độ chính xác thực thi 88.15% , chứng minh rằng kiến trúc và quản lý ngữ cảnh cũng quan trọng không kém việc lựa chọn mô hình.
Tại sao lại là Spider 1.0?
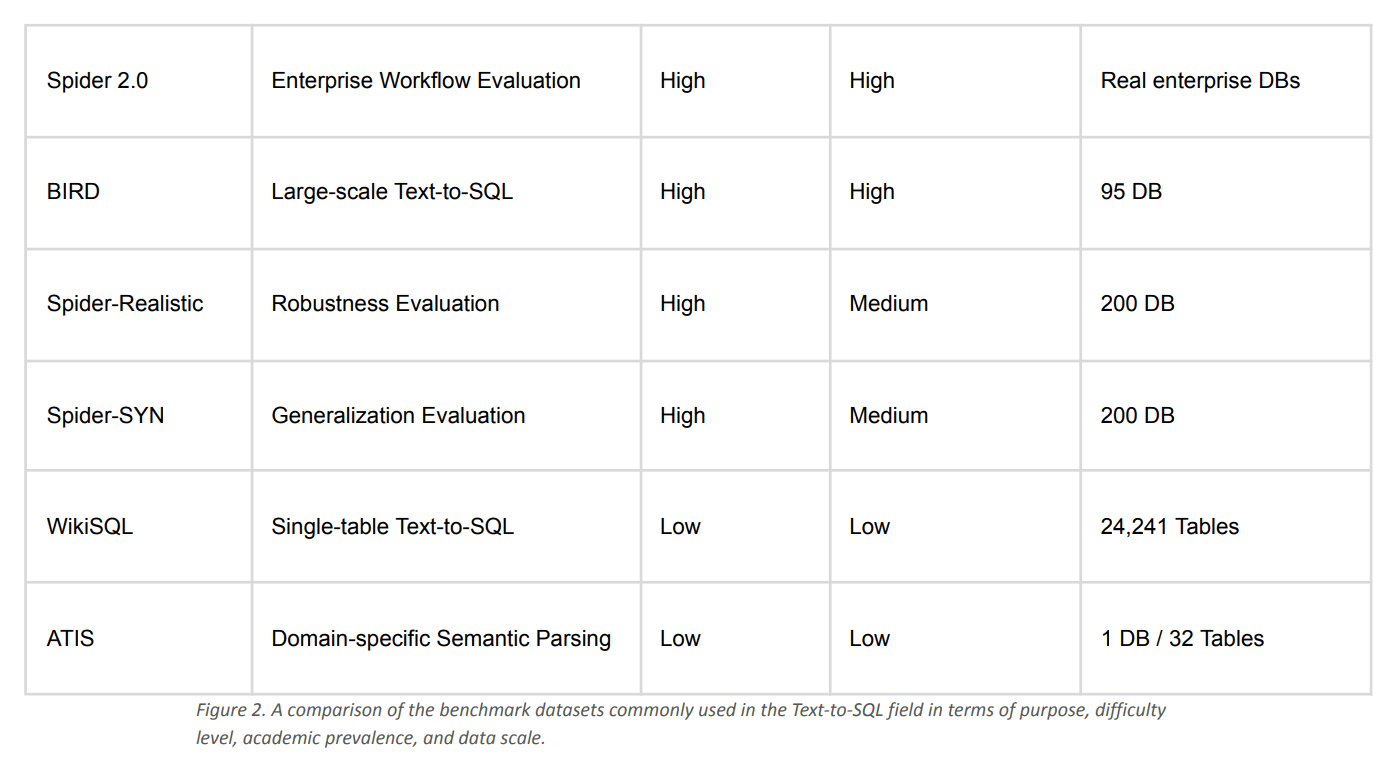
Việc lựa chọn bộ dữ liệu chuẩn phù hợp cũng quan trọng như việc lựa chọn mô hình phù hợp. Mặc dù các bộ dữ liệu mới hơn như Spider 2.0 và BIRD đưa ra các kịch bản doanh nghiệp phức tạp hơn, Spider 1.0 vẫn là bộ dữ liệu chuẩn được sử dụng rộng rãi nhất để đánh giá các hệ thống chuyển đổi văn bản thành SQL và so sánh kết quả trong các tài liệu nghiên cứu.
Để đánh giá ban đầu, chúng tôi đã chọn Spider 1.0 vì nó cung cấp một tiêu chuẩn cơ bản đã được thiết lập tốt. Điều này cho phép chúng tôi đo lường mức độ hiệu quả của Data Agent trong việc hiểu các lược đồ cơ sở dữ liệu chưa từng thấy trước đây và tạo ra các câu lệnh SQL chính xác trong điều kiện thực tế.
Hình 2 tóm tắt cách Spider 1.0 so sánh với các công cụ đo hiệu năng chuyển đổi văn bản thành SQL thông dụng khác.
Xây dựng tác nhân dữ liệu
Đạt được độ chính xác cao khi chuyển đổi văn bản sang SQL không chỉ đơn thuần là việc sử dụng mô hình ngôn ngữ lớn hơn. Trong suốt quá trình đánh giá hiệu năng, chúng tôi nhận thấy rằng kiến trúc và quản lý ngữ cảnh có tác động lớn hơn đến hiệu năng so với việc chỉ lựa chọn mô hình.
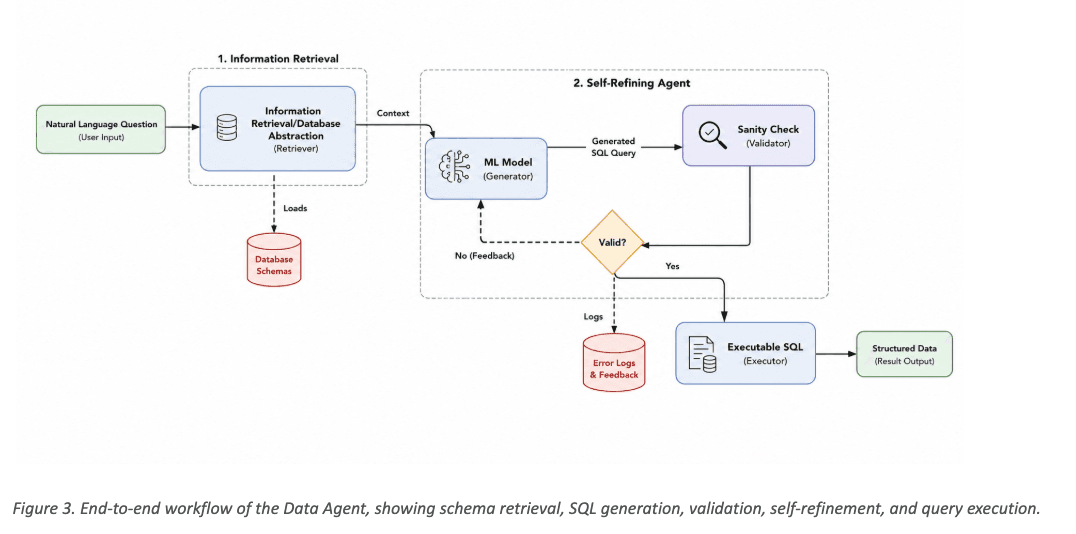
Hệ thống Data Agent của chúng tôi được thiết kế như một quy trình đa giai đoạn, thu hẹp dần vấn đề trước khi yêu cầu LLM tạo ra câu lệnh SQL. Thay vì hiển thị toàn bộ lược đồ cơ sở dữ liệu cho mô hình, hệ thống trước tiên chỉ truy xuất lược đồ và thông tin ngữ cảnh liên quan, sau đó tạo ra truy vấn SQL, xác thực kết quả và tự động sửa các lỗi thường gặp trước khi thực thi.
Như minh họa trong Hình 3 , kiến trúc bao gồm ba giai đoạn chính:
Truy xuất thông tin – Câu hỏi của người dùng được phân tích để xác định các đối tượng cơ sở dữ liệu có liên quan, và chỉ thông tin lược đồ cần thiết mới được truy xuất từ kho siêu dữ liệu.
Chất tự tinh chế – Mô hình ngôn ngữ tạo ra câu lệnh SQL, xác thực truy vấn so với lược đồ đã truy xuất và tự động tinh chỉnh nó bất cứ khi nào quá trình xác thực thất bại.
Thực thi & Phản hồi – Sau khi được xác thực, truy vấn SQL sẽ được thực thi trên cơ sở dữ liệu mục tiêu và kết quả được trả về dưới dạng dữ liệu có cấu trúc hoặc phản hồi bằng ngôn ngữ tự nhiên.
Kiến trúc hướng đến sản xuất này được lấy cảm hứng từ các ý tưởng được giới thiệu trong DIN-SQL và DAIL-SQL , đồng thời được điều chỉnh cho môi trường doanh nghiệp, nơi độ tin cậy, khả năng giải thích và tính mạnh mẽ cũng quan trọng như độ chính xác của chuẩn mực.
Hành trình so sánh hiệu suất của chúng tôi
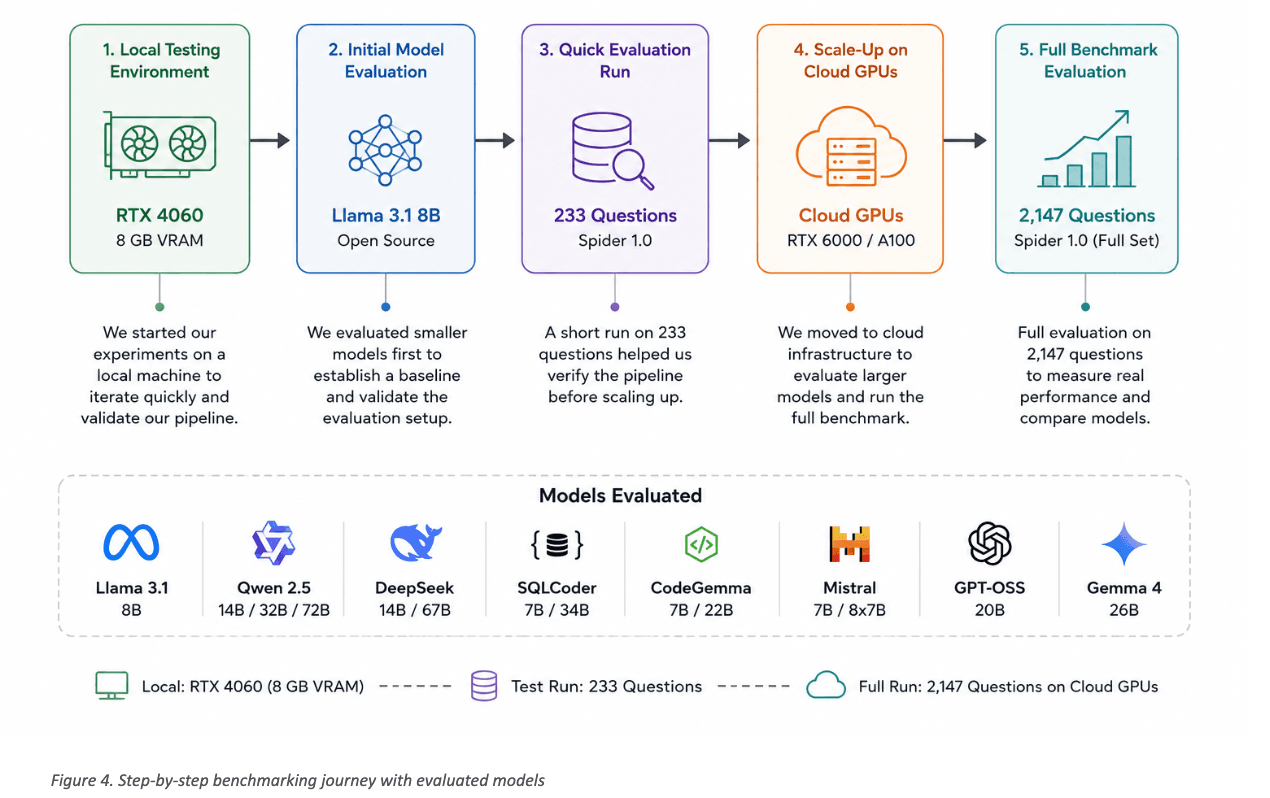
Việc lựa chọn mô hình ngôn ngữ phù hợp là một phần quan trọng trong quy trình đánh giá hiệu năng của chúng tôi. Thay vì đánh giá một mô hình duy nhất, chúng tôi đã thử nghiệm với nhiều mô hình ngôn ngữ nguồn mở khác nhau, bao gồm Llama 3.1, Qwen 2.5, DeepSeek, SQLCoder, CodeGemma, Mistral, GPT-OSS và Gemma 4.
Để đảm bảo sự so sánh công bằng, chúng tôi đã đánh giá mọi mô hình bằng Độ chính xác thực thi (Execution Accuracy - EA) , chỉ số tiêu chuẩn để đánh giá hiệu năng chuyển đổi văn bản thành SQL. Không giống như các chỉ số dựa trên cú pháp, Độ chính xác thực thi đo lường xem câu lệnh SQL được tạo ra có trả về cùng một kết quả với truy vấn tham chiếu hay không, do đó nó là một chỉ báo tốt hơn về hiệu năng thực tế.
Hành trình đánh giá hiệu năng của chúng tôi được minh họa trong Hình 4. Chúng tôi bắt đầu bằng cách thử nghiệm trên một máy trạm cục bộ được trang bị card đồ họa RTX 4060 (8 GB VRAM) , nơi các mô hình nhỏ hơn cho phép chúng tôi lặp lại nhanh chóng và xác thực quy trình của mình. Sau khi thiết lập được một đường cơ sở ổn định bằng cách sử dụng một tập hợp con gồm 233 câu hỏi của Spider 1.0, chúng tôi chuyển sang sử dụng GPU trên đám mây để đánh giá các mô hình lớn hơn trên bộ dữ liệu chuẩn gồm 2,147 câu hỏi . Cách tiếp cận theo từng giai đoạn này cho phép chúng tôi tối ưu hóa kiến trúc một cách hiệu quả trước khi đầu tư vào các lần chạy đánh giá hiệu năng quy mô lớn.
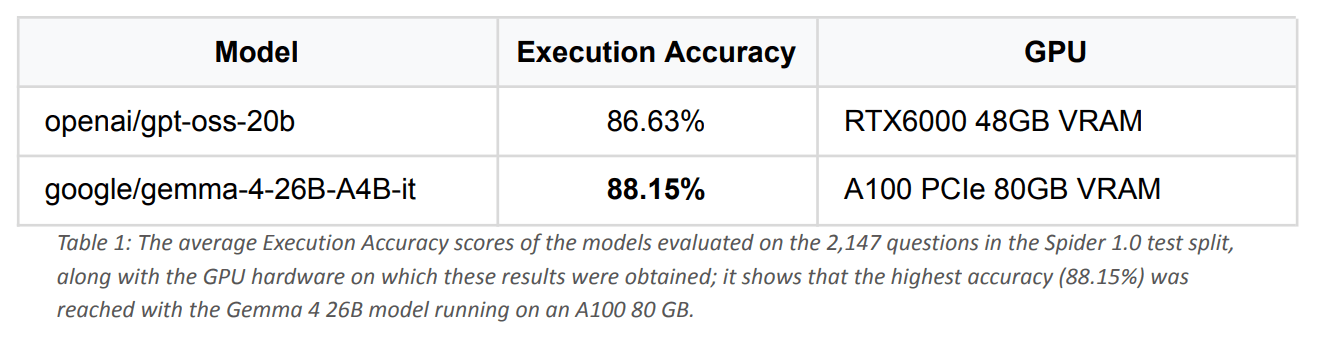
Chúng tôi đã đánh giá các mô hình cuối cùng trên toàn bộ tập dữ liệu thử nghiệm Spider 1.0 gồm 2,147 câu hỏi. Như thể hiện trong Bảng 1, Gemma 4 26B đạt điểm cao nhất (88.15%), tiếp theo là GPT-OSS 20B (86.63%). Những kết quả này chứng minh rằng các mô hình LLM mã nguồn mở hiện đại, khi được kết hợp với quy trình truy xuất và xác thực hiệu quả, có thể đạt được hiệu suất chuyển đổi văn bản thành SQL rất cạnh tranh.
So sánh các kết quả này như thế nào?
Điểm chuẩn chỉ có ý nghĩa khi chúng có thể được so sánh với các công trình đã được công bố trước đó. Để hiểu rõ hơn ý nghĩa của kết quả, chúng tôi đã xem xét cả các nghiên cứu Text-to-SQL gần đây và các bài báo chuẩn được trích dẫn rộng rãi.
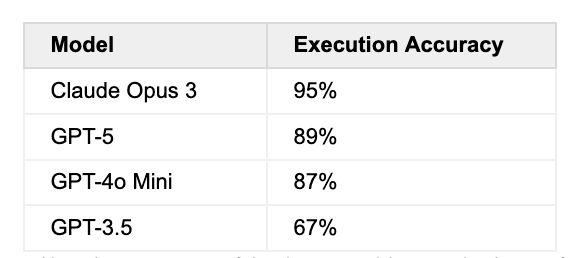
Bảng 2: Tỷ lệ chính xác của các mô hình mã nguồn đóng được báo cáo trong nghiên cứu SQL-of-Thought trên một tập con của bộ dữ liệu Spider; xét về mặt so sánh, kết quả 88.15% thu được trong nghiên cứu này cao hơn GPT-4o Mini (87%) và ở mức gần với GPT-5 (89%).
Các nghiên cứu gần đây như SQL-of-Thought [1] báo cáo rằng các mô hình mã nguồn đóng hàng đầu—bao gồm Claude Opus 3, GPT-5 và GPT-4o Mini —đạt độ chính xác cao trên các tập con chuẩn Spider. Mặc dù các so sánh trực tiếp cần được diễn giải cẩn thận do sự khác biệt về cài đặt đánh giá, lời nhắc và tập con chuẩn, nhưng Độ chính xác thực thi 88.15% của chúng tôi chứng minh rằng các mô hình mã nguồn mở có thể đạt được hiệu suất trong cùng phạm vi cạnh tranh.
Mặc dù các kết quả này đến từ các thiết lập đánh giá khác nhau và không nên so sánh trực tiếp, nhưng chúng cung cấp bối cảnh hữu ích để hiểu được tình hình hiệu năng hiện tại của các hệ thống chuyển đổi văn bản thành SQL. Bài kiểm tra hiệu năng của chúng tôi chứng minh rằng các mô hình mã nguồn mở hiện nay có thể cạnh tranh với các giải pháp thay thế mã nguồn đóng hàng đầu khi được kết hợp với một kiến trúc được thiết kế tốt.
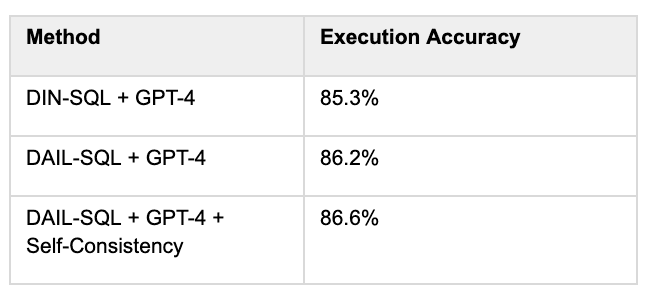
Chúng tôi cũng so sánh kết quả của mình với các khung Text-to-SQL hướng đến sản xuất như DIN-SQL [3] và DAIL- SQL, kết hợp các mô hình ngôn ngữ lớn với các kỹ thuật bao gồm liên kết lược đồ, kỹ thuật nhắc nhở, tính nhất quán tự thân và sửa lỗi.
Bảng 3: Kết quả Độ chính xác thực thi của các phương pháp khác nhau trên Spider 1.0 trong nghiên cứu "Chuyển đổi văn bản thành SQL được hỗ trợ bởi các mô hình ngôn ngữ lớn: Đánh giá chuẩn" [2]; nó cho thấy tác động đến độ chính xác không chỉ của việc lựa chọn mô hình mà còn của các kỹ thuật như kỹ thuật nhắc nhở, liên kết lược đồ và tính nhất quán tự thân.
Kết quả nghiên cứu của chúng tôi củng cố một kết luận được chia sẻ rộng rãi trong các tài liệu gần đây: hiệu suất chuyển đổi văn bản sang SQL cao không chỉ phụ thuộc vào mô hình ngôn ngữ mà còn phụ thuộc vào kiến trúc xung quanh. Việc truy xuất lược đồ hiệu quả, quản lý ngữ cảnh, xác thực và tự sửa lỗi thường quan trọng không kém gì chính mô hình đó.
Những gì chúng ta đã học
So sánh hiệu năng không chỉ đơn thuần là đo lường độ chính xác mà còn là hiểu rõ hệ thống thất bại ở đâu và vì sao. Trong suốt quá trình đánh giá, chúng tôi đã phân tích các dự đoán sai và xác định một số mô hình lặp đi lặp lại ảnh hưởng đến điểm số cuối cùng.
Một số lỗi bắt nguồn từ chính bộ công cụ đánh giá hiệu năng. Trong một số ít trường hợp, sự không nhất quán trong các truy vấn SQL tham chiếu (chuẩn) đã khiến các dự đoán đúng về mặt logic bị đánh dấu là không chính xác. Các trường hợp khác liên quan đến các câu hỏi ngôn ngữ tự nhiên mơ hồ hoặc các tình huống cần phân định thắng thua, trong đó nhiều truy vấn SQL có thể tạo ra các câu trả lời hợp lệ như nhau.
Chúng tôi cũng quan sát thấy một số hành vi đặc trưng của mô hình, bao gồm việc chuyển đổi kiểu dữ liệu không cần thiết, xử lý không nhất quán về phân biệt chữ hoa chữ thường và đôi khi làm phức tạp hóa quá mức các truy vấn SQL vốn dĩ đơn giản. Những phát hiện này củng cố tầm quan trọng của việc tích hợp các cơ chế xác thực và tự sửa lỗi vào quy trình xử lý dữ liệu của Data Agent.
Nhìn chung, phân tích của chúng tôi cho thấy nhiều lỗi còn lại không phải do những hạn chế của mô hình ngôn ngữ mà là do sự mơ hồ trong bộ dữ liệu chuẩn hoặc các trường hợp ngoại lệ trong quá trình tạo câu lệnh SQL. Điều này cho thấy rằng việc cải thiện hơn nữa trong việc truy xuất, xác thực và quản lý ngữ cảnh có thể giúp hệ thống vượt qua ngưỡng Độ chính xác thực thi 90%.
Chi phí và hiệu quả
Độ chính xác cao chỉ là một khía cạnh của hệ thống chuyển đổi văn bản thành SQL sẵn sàng cho môi trường sản xuất. Trong môi trường doanh nghiệp, chi phí cơ sở hạ tầng, bảo mật dữ liệu và tính linh hoạt trong triển khai cũng quan trọng không kém.
Một trong những ưu điểm chính của phương pháp chúng tôi là nó hoàn toàn dựa trên các mô hình ngôn ngữ mã nguồn mở. Trong suốt quá trình phát triển, chúng tôi đã có thể thực hiện hầu hết các thử nghiệm cục bộ bằng cách sử dụng card đồ họa RTX 4060 (8 GB VRAM) cấp người tiêu dùng , cho phép chúng tôi lặp lại nhanh chóng mà không phải chịu bất kỳ chi phí API hoặc token nào. Sau đó, các lần chạy thử nghiệm hiệu năng lớn hơn chỉ được thực hiện trên các GPU đám mây chuyên dụng sau khi kiến trúc đã được xác thực.
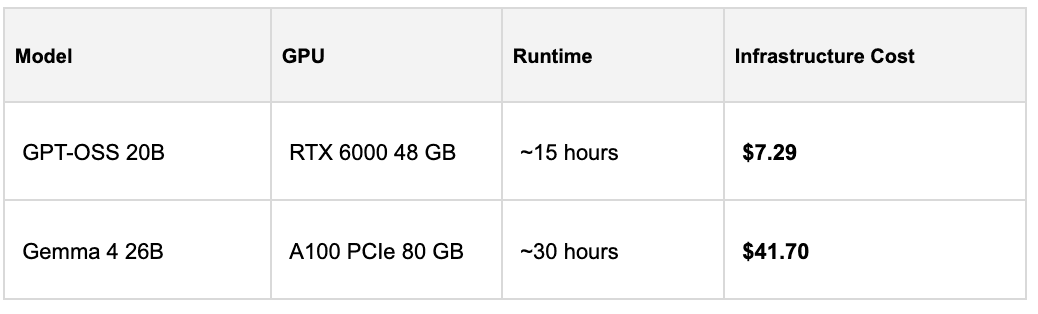
Chúng tôi đã sử dụng RunPod Secure Cloud để đánh giá đầy đủ Spider 1.0. Bài kiểm tra hiệu năng Gemma 4 26B được thực hiện trên GPU A100 PCIe 80 GB, trong khi GPT-OSS 20B chạy trên GPU RTX 6000 48 GB.
Chi phí cơ sở hạ tầng được tóm tắt trong Bảng 4.
Mặc dù các thử nghiệm hiệu năng lớn nhất yêu cầu cơ sở hạ tầng đám mây, quy trình phát triển tổng thể vẫn tiết kiệm chi phí nhờ vào việc thử nghiệm tại chỗ và các mô hình mã nguồn mở. Quan trọng hơn, kiến trúc thu được có thể được triển khai hoàn toàn trong cơ sở hạ tầng nội bộ của tổ chức, loại bỏ sự phụ thuộc vào API bên ngoài đồng thời cung cấp khả năng kiểm soát tốt hơn về quyền riêng tư dữ liệu, tuân thủ quy định và chi phí vận hành.
Điều này làm cho kiến trúc này đặc biệt phù hợp với các tổ chức hoạt động trong môi trường nhạy cảm về quyền riêng tư, được quản lý chặt chẽ hoặc không có kết nối mạng, nơi bảo mật dữ liệu và tính linh hoạt trong triển khai là những yêu cầu quan trọng.
Vượt xa Spider 1.0
Các bài kiểm tra hiệu năng cung cấp một cách khách quan để đánh giá các hệ thống AI, nhưng chúng không phải là mục tiêu cuối cùng. Điểm số cao trong bài kiểm tra hiệu năng chỉ có giá trị nếu nó phản ánh được hiệu suất đáng tin cậy trong các ứng dụng thực tế.
Xuyên suốt nghiên cứu này, chúng tôi nhận thấy rằng việc xây dựng một hệ thống chuyển đổi văn bản thành SQL sẵn sàng cho sản xuất không chỉ đơn thuần là tạo ra mã SQL. Hiểu rõ lược đồ cơ sở dữ liệu, truy xuất ngữ cảnh phù hợp, xác thực các truy vấn được tạo ra và tinh chỉnh các kết quả đầu ra không chính xác đều quan trọng không kém gì chính mô hình ngôn ngữ.
Độ chính xác thực thi 88.15% của chúng tôi trên Spider 1.0 chứng minh rằng các mô hình mã nguồn mở, kết hợp với kiến trúc được thiết kế tốt, có thể mang lại hiệu suất cạnh tranh cao cho các tác vụ Chuyển đổi Văn bản thành SQL cấp doanh nghiệp. Quan trọng hơn, nó xác thực các nguyên tắc thiết kế đằng sau Data Agent của chúng tôi , được xây dựng để hoạt động đáng tin cậy trên các cơ sở dữ liệu doanh nghiệp phức tạp chứ không chỉ trên các tập dữ liệu chuẩn.
Spider 1.0 đánh dấu một cột mốc quan trọng, nhưng đây chỉ là khởi đầu của hành trình chúng ta. Các bước tiếp theo bao gồm đánh giá Data Agent trên Spider 2.0 , thực hiện các bài kiểm tra hiệu năng quy mô doanh nghiệp lớn hơn, và quan trọng nhất là môi trường khách hàng thực tế, nơi lược đồ cơ sở dữ liệu lớn hơn đáng kể và các vấn đề kinh doanh phức tạp hơn nhiều.
Tầm nhìn dài hạn của chúng tôi không chỉ đơn thuần là xây dựng một công cụ tạo câu lệnh SQL tốt hơn. Chúng tôi hướng đến việc xây dựng các Tác nhân Dữ liệu thông minh, cho phép các tổ chức tương tác với dữ liệu doanh nghiệp một cách tự nhiên như khi giao tiếp với đồng nghiệp – kết hợp khả năng truy xuất, suy luận, xác thực và trí tuệ nhân tạo có thể giải thích được vào một nền tảng hỗ trợ quyết định đáng tin cậy.
Bài học chính
So sánh hiệu năng không chỉ đơn thuần là đo lường độ chính xác mà còn là để hiểu tại sao một hệ thống lại thành công hay thất bại.
Trong suốt quá trình đánh giá, chúng tôi đã xác định được một số mẫu lỗi lặp đi lặp lại. Một số lỗi bắt nguồn từ sự mơ hồ trong chính bộ dữ liệu chuẩn, bao gồm sự không nhất quán trong các truy vấn SQL tham chiếu và các điều kiện sắp xếp không được chỉ định rõ ràng. Một số lỗi khác phản ánh các hành vi phổ biến của LLM, chẳng hạn như việc chuyển đổi kiểu dữ liệu không cần thiết hoặc xử lý không nhất quán các giá trị phân biệt chữ hoa chữ thường.
Những quan sát này củng cố một trong những phát hiện trọng tâm của công trình nghiên cứu của chúng tôi: kiến trúc quan trọng không kém gì việc lựa chọn mô hình. Việc truy xuất, liên kết lược đồ, xác thực và tự sửa lỗi đóng góp vào hiệu suất cuối cùng cũng nhiều như mô hình ngôn ngữ cơ bản.
Mặc dù những hạn chế của tiêu chuẩn đánh giá chắc chắn sẽ ảnh hưởng đến điểm số cuối cùng, nhưng phân tích của chúng tôi cho thấy rằng những cải tiến hơn nữa trong quản lý ngữ cảnh và xác thực có thể giúp hệ thống vượt qua mốc Độ chính xác thực thi 90%.
Nhìn về phía trước
Spider 1.0 đã cung cấp một cơ sở quan trọng để đánh giá Data Agent của chúng tôi, nhưng nó chỉ là bước đầu tiên hướng tới trí tuệ nhân tạo doanh nghiệp sẵn sàng cho sản xuất.
Mục tiêu tiếp theo của chúng tôi là đánh giá kiến trúc trên các bộ dữ liệu thử thách hơn như Spider 2.0 và, quan trọng hơn, trên các cơ sở dữ liệu doanh nghiệp thực tế, nơi lược đồ lớn hơn đáng kể, tài liệu thường không đầy đủ và các câu hỏi kinh doanh phức tạp hơn nhiều.
Mục tiêu của chúng tôi không chỉ đơn thuần là xây dựng một hệ thống chuyển đổi văn bản thành SQL khác. Chúng tôi đang xây dựng các tác nhân dữ liệu thông minh kết hợp khả năng truy xuất, suy luận, xác thực và giải thích để giúp các tổ chức tương tác với dữ liệu doanh nghiệp một cách tự nhiên và đáng tin cậy.
dự án
[1] Saumya Chaturvedi, Aman Chadha, Laurent Bindschaedler arXiv. “SQL-of-Thought: Chuyển đổi văn bản thành SQL đa tác nhân với tính năng sửa lỗi có hướng dẫn.” arXiv. Tháng 6 năm 2026 https://arxiv.org/abs/2509.00581
[2] Dawei Gao, Haibin Wang, Yaliang Li, Xiuyu Sun, Yichen Qian, Bolin Ding, Jingren Zhou “Chuyển văn bản sang SQL được hỗ trợ bởi các mô hình ngôn ngữ lớn: Đánh giá điểm chuẩn” arXiv. tháng 6 năm 2026
[3] Mohammadreza Pourreza, Davood Rafiei. “DIN-SQL: Học chuyển đổi văn bản thành SQL theo ngữ cảnh phân tách với khả năng tự sửa lỗi” arXiv. Tháng 6 năm 2026